
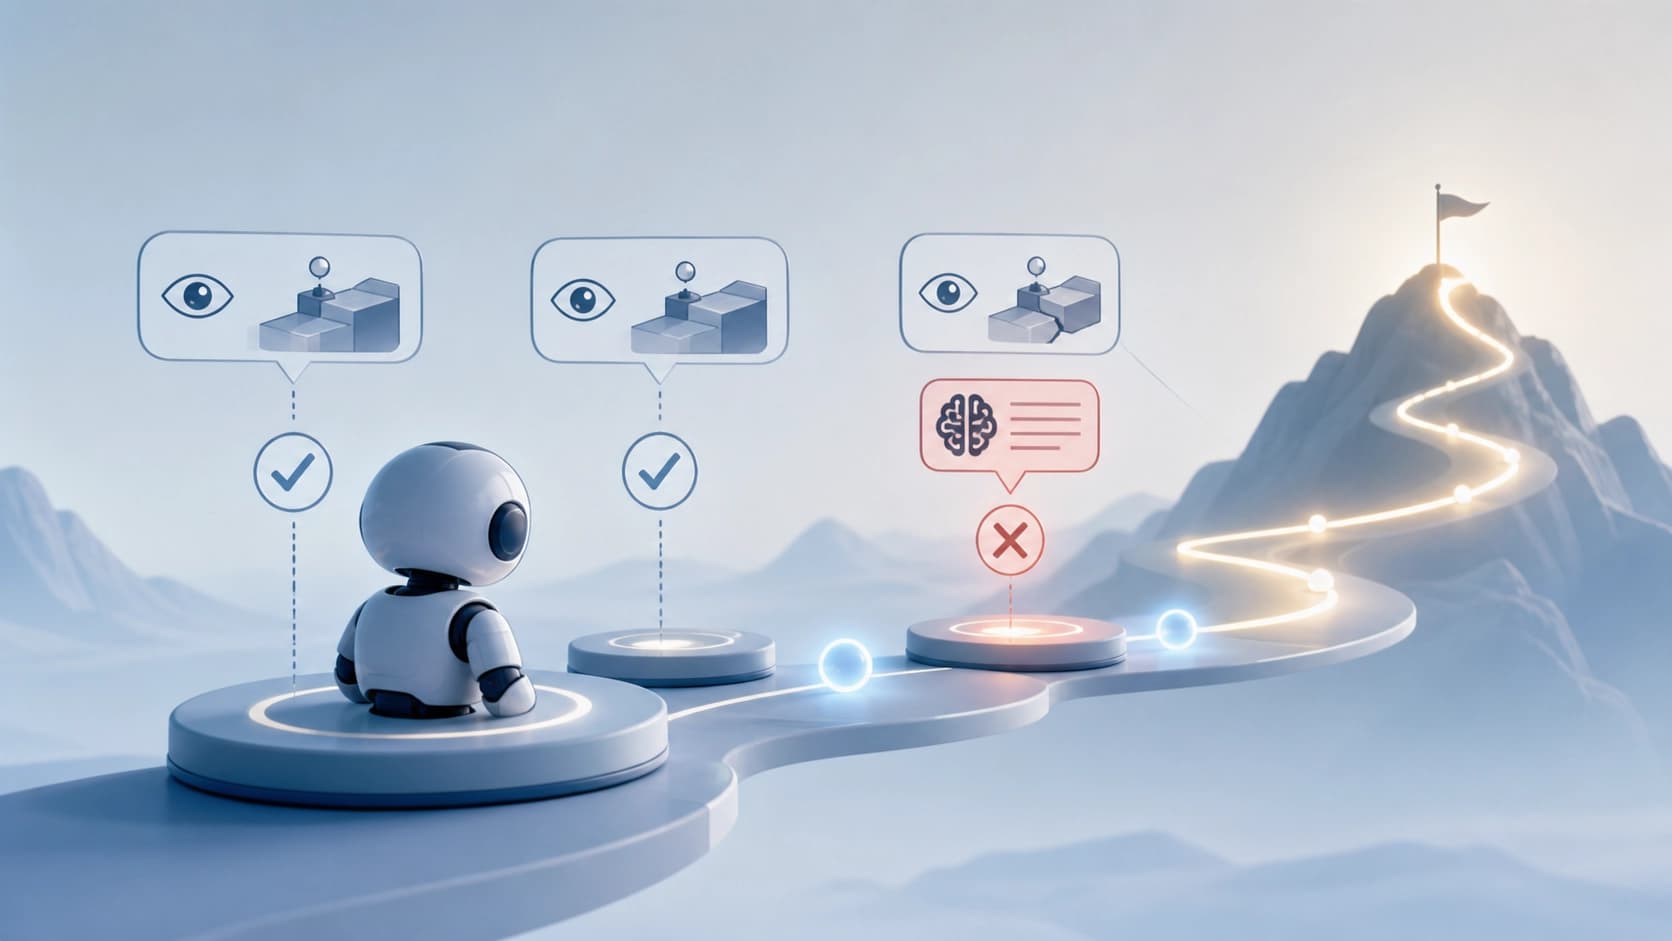
المشكلة: مكافأة واحدة لكل المسار
تتعلم الوكلاء متعددة الخطوات القائمة على نماذج اللغة الكبيرة (LLM) بالتجربة والخطأ: ينفذون سلسلة من الإجراءات، ويحصلون على تقييم نهائي، ويعدّلون سلوكهم بناءً عليه. المشكلة أن هذا التقييم يأتي عادةً على المسار بأكمله دفعة واحدة. فيعرف الوكيل أن المهمة أُنجزت أو فشلت، لكنه لا يعرف في أي خطوة بالتحديد سار كل شيء على نحو خاطئ.
ثم تبدأ الحسابات التي لا تنسجم جيدًا مع المنطق السليم. تُوزَّع الميزة نفسها على جميع الخطوات تباعًا — على اختيار الأداة удачно، وعلى خطأ مطبعي عابر في الطلب، وعلى خطوة روتينية مثل «تأكيد الإجراء». والنتيجة أن النموذج يكافئ في الوقت نفسه الأخطاء العابرة والخطوات العملية السليمة، إذا كان النهائي ناجحًا. ففضل النجاح يُنسب للجميع بالتساوي، ولوم الفشل كذلك أيضًا للجميع.
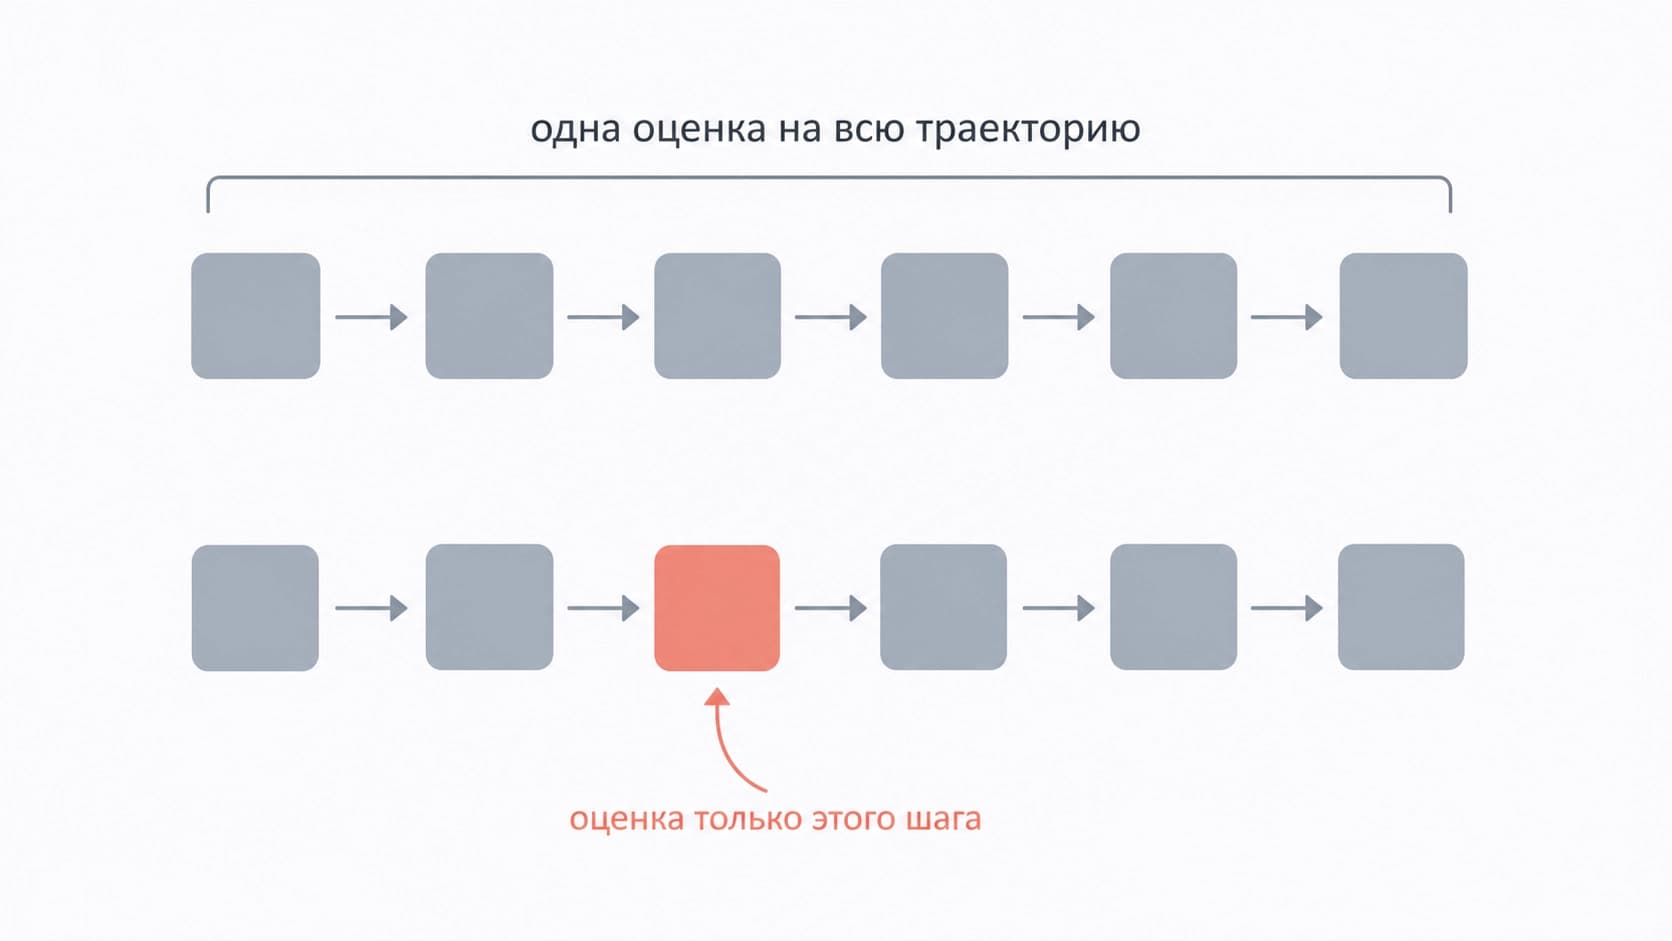
العلاج الكلاسيكي هو التقطير الذاتي بالمعلومات المميّزة. فالمعلّم يعرف أكثر من المتعلّم: لديه وصول إلى البيئة، وإلى الإشارات الوسيطة، وإلى الإجابة الصحيحة. ويمكنه أن يوجّه في كل خطوة، لا في النهاية فقط. يبدو هذا جيدًا، لكن لهذا النهج إهمالًا خفيًا: التوجيه نفسه يُقدَّم لجميع الخطوات دون تمييز.
لا تماثل الخطوات: الروتين والأخطاء يحتاجان إلى شيء مختلف
الفكرة المحورية في ورقة AHEAD هي أن الخطوات في المسار غير متكافئة، وأن الإشراف عليها يجب أن يكون مختلفًا أيضًا.
- الخطوات الروتينية — فتح صفحة، تأكيد انتقال، استدعاء الأداة المطلوبة — لا تكاد تحتاج إلى توجيهات. فالنموذج يتدبر أمره بنفسه. والتوجيه الزائد هنا لا يفعل سوى تشويش التدريب وإهدار الميزانية.
- الخطوات الحرجة التي فيها خطأ — حيث انحرف الوكيل عن المسار وفقد فرصة النجاح — تتطلب ليس مجرد تقرير بأن «الأمر سيئ هنا»، بل اتجاهًا محددًا: ما كان ينبغي فعله بدلًا من ذلك.
- التغذية الراجعة من البيئة تُرسّخ ما يحدث جيدًا: فهي تخبر بما حدث فعلًا. لكنها لا تستطيع أن تشرح كيف كان ينبغي التصرف. فإشارة «الباب لم يُفتح» لا تدل على مكان وجود المفتاح.
ويتضح من ذلك أن مصدرَي الإشراف يكمّل أحدهما الآخر، لكنه لا يحل محلّه. فالتغذية الراجعة من البيئة تقدّم إشارة كثيفة وصادقة في كل خطوة؛ والتوجيهات التصحيحية المولّدة من النموذج تقدّم ما لا يوجد في التغذية الراجعة من البيئة من حيث المبدأ — ألا وهو القصد والبديل. وخلطها عشوائيًا على امتداد المسار كله يعني إهدار نقاط القوة لدى كليهما.
كيف يعمل AHEAD
المؤلفون — Xiaolong Jin وDingmin Wang وVijay Lingam وVarun Kumar — يقترحون إطارًا يدرك نوع الخطوة ويختار لها مصدر الإشراف المناسب. وقد نُشرت الورقة على arXiv في أواخر أغسطس 2026، في تصنيف cs.AI؛ وحجمها 22 صفحة و15 شكلًا و7 جداول، أي أن المادة كافية للتفاصيل.
معلّم يرى البيئة
يتلقى النموذج المعلّم التغذية الراجعة من البيئة في جميع الخطوات — وهي إشارة مُرسَّخة وكثيفة، متاحة بالتساوي في المقاطع الناجحة والفاشلة على حد سواء. ومعلّم كهذا لا يتخيّل: بل يستند إلى ما حدث فعلًا في البيئة.
التوجيهات التصحيحية — بشكل موجَّه
فوق ذلك، يتلقى المعلّم توجيهات مولّدة من LLM، لكن ليس في جميع الخطوات، بل تحديدًا في الخطوات الخاطئة. والمنطق بسيط: حيث أخطأ الوكيل، لا تكفي حقيقة واحدة من البيئة، بل يلزم تفسير يوضح إلى أين كان ينبغي أن يتجه. أما حيث يسير كل شيء بسلاسة، فلا يُضاف توجيه إضافي على الإطلاق.
وهذا هو «التوجيه الموجَّه» الوارد في العنوان: ليس موزَّعًا على امتداد المسار، بل مركَّزًا على النقاط الإشكالية. مطابقة واعية بنوع الخطوة بين مصادر الإشراف، بدلًا من إشارة واحدة لسلسلة الإجراءات بأكملها.
تعديلات طفيفة على GRPO
يجدر التنويه بشكل منفصل بالتواضع الهندسي للطريقة. فـ GRPO — وهي خوارزمية شائعة للتعلّم المعزّز — لا يُعاد كتابتها من الصفر: بل تُجرى التعديلات بشكل موجَّه، فوق المخطط القياسي. وهذا مهم للممارسين، لأنه لا يتطلب إعادة بناء خط أنابيب تدريب الوكيل بالكامل.
ما أظهرته التجارب
جرى التقييم على ثلاثة أنواع من المهام: ALFWorld — سيناريوهات متعددة الخطوات في بيئة نصية، وWebShop — التفاعل مع متجر إلكتروني، والأسئلة والأجوبة البحثية. واختُبرت ثلاثة أحجام من النماذج، بحيث لا تكون الاستنتاجات مرتبطة بحجم واحد.
النتائج مقارنةً بـ GRPO العادي:
- +13.3 نقطة في معدل النجاح على ALFWorld مع نموذج بحجم 7B؛
- +11.0 نقطة على WebShop بالحجم نفسه.
وإلى جانب الأرقام المطلقة، هناك تأثيران لا يقلان إثارة للاهتمام. أولًا، يُبلَغ مستوى النجاح المحدد بعدد أقل من خطوات التدريب — أي أن الطريقة ليست أفضل في الحد الأقصى فحسب، بل تصل أيضًا أسرع إلى الحالة التشغيلية. وثانيًا، يحل الوكيل المهام في ميزانيات تفاعل أضيق من النهج القائمة على المكافأة النهائية فقط وطرق التقطير الذاتي السابقة.
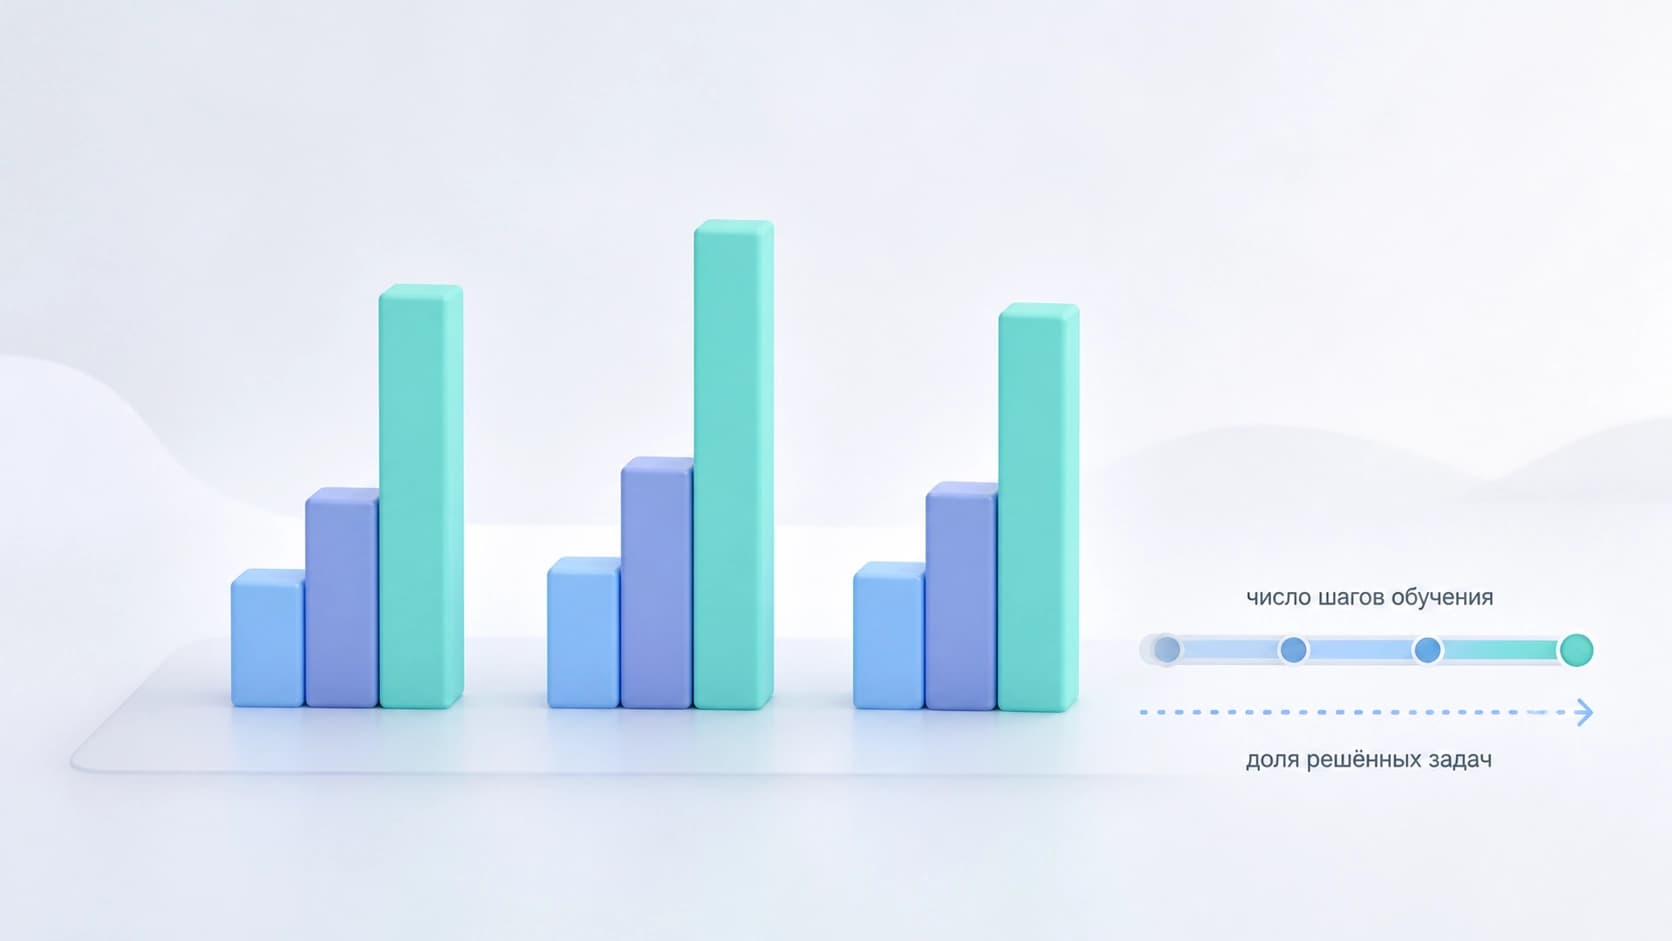
النقطة الثانية، في رأيي، مُقلَّل من تقديرها. فاقتصاد خطوات التفاعل ليس مجرد مقياس جمالي. في السيناريوهات الواقعية، كل استدعاء أداة يكلّف مالًا ووقتًا ومخاطرة. والوكيل الذي يصل إلى الهدف بخمسة إجراءات بدلًا من عشرة، يكون أنفع ليس بنسبة 13 في المئة، بل أضعافًا — خصوصًا حيث تكون تكلفة الخطأ مرتفعة.
لماذا ينجح هذا وما يبقى خارج الصورة
التفسير في هذه الطريقة شبه تربوي. فالمعلّم الجيد لا يعلّق على كل حركة يقوم بها المتعلّم — بل يصمت ما دام يفعل أشياء معقولة، ويتدخل تحديدًا حيث ضلّ المتعلّم عن الطريق. وإذا علّق على كل شيء، يتوقف المتعلّم عن التفكير بنفسه ويبدأ في انتظار التوجيهات. وإذا لم يعلّق على أي شيء، فسيكرر الأخطاء نفسها.
تُصوغ AHEAD هذه الحدسية بمصطلحات التعلّم المعزّز: نوع خطوة مختلف — مصدر إشارة مختلف. تغذية راجعة كثيفة ومُرسَّخة — كخلفية، واتجاه تصحيحي — كتأكيد. لا سحر في الأمر، مجرد رفض لفكرة أن جميع الخطوات متساوية.
أما ما يبقى موضع تساؤل: فإن توليد التوجيهات التصحيحية يتطلب بحد ذاته نموذجًا، ما يعني إضافة تكاليف حسابية واعتمادًا على جودته — فإذا شرح المعلّم بشكل خاطئ، سيحصل المتعلّم على اتجاه واثق لكن غير صحيح. ويبقى مفتوحًا أيضًا مدى قابلية نقل الطريقة إلى مهام لا تكون فيها تكلفة الخطوة الوسيطة واضحة كما في ALFWorld أو WebShop، وحيث لا يمكن دائمًا تحديد «خطأ» الخطوة فورًا، بل فقط عبر عواقب مؤجلة.
ومع ذلك، يبدو الاتجاه سليمًا. فالخط الرئيسي لتطور الطرق الوكيلية في السنوات الأخيرة ليس تكبير النموذج، بل إدارة إشارة التدريب بذكاء أكبر. وAHEAD من هذا الخط تحديدًا: تدخل موجَّه بدلًا من تحكم شامل.


