
لماذا نجح التصويت القائم على الثقة أصلًا
الفكرة مألوفة لكل من بنى خطوط معالجة حول النماذج اللغوية الكبيرة، وهي بسيطة: شغّل المهمة نفسها عدة مرات على التوازي، ثم اختر الإجابة بالأغلبية. لكن ليس بأغلبية «مسطّحة»، بل مرجّحة — إذ يحصل كل تشغيل على وزن وفق الإشارات الداخلية للنموذج، وفي الغالب وفق اللوغاريتمات الاحتمالية للرموز. والنسخة التي كان النموذج فيها أكثر ثقة تبدو أعلى صوتًا من غيرها.
في الاستدلال أحادي الخطوة تُظهر هذه المخطط أداءً جيدًا: فإذا أخطأ النموذج فإنه عادةً يتردد، بينما تصاحب الإجابة الصحيحة ثقة عالية. وهكذا يصبح الفارق في اللوغاريتمات الاحتمالية أشبه بكاشف أخطاء مدمج، لا يحتاج إلى استدعاءات إضافية ولا إلى وسم ولا إلى نموذج حَكَم منفصل.
ينكسر في المكان نفسه الذي بدأ منه: البحث متعدد الخطوات
المشكلة أن الوكلاء الحديثين مبنيون على نحو مختلف. فهم لا يكتفون بالاستدلال في مرور واحد: بل يصوغون الاستعلامات، ويحصلون على مستندات خارجية، ويدمجونها في السياق، ويحسّنون الاستعلام، وهكذا عدة مرات حتى يجمعوا مادة كافية للإجابة النهائية. وكل خطوة تضيف إلى نافذة النموذج أجزاءً من نصّ شخص آخر.
تحقق مؤلفو العمل «Beyond Confidence: Test-Time Scaling for Multi-Turn Search Agents via Retrieval Grounding» (arXiv:2608.24024، المقبول في Findings لمؤتمر EMNLP 2026) — Hyunho Kook وJunhyuk So وTianyu Fu وHaizhong Zheng وBeidi Chen — مما يحدث للتصويت القائم على الثقة في هذا السيناريو. والنتيجة مزعجة: الأسلوب الذي جرى ضبطه على المهام أحادية الخطوة ينتقل إلى وكلاء البحث بشكل سيئ.
آلية الفشل: copy inflation
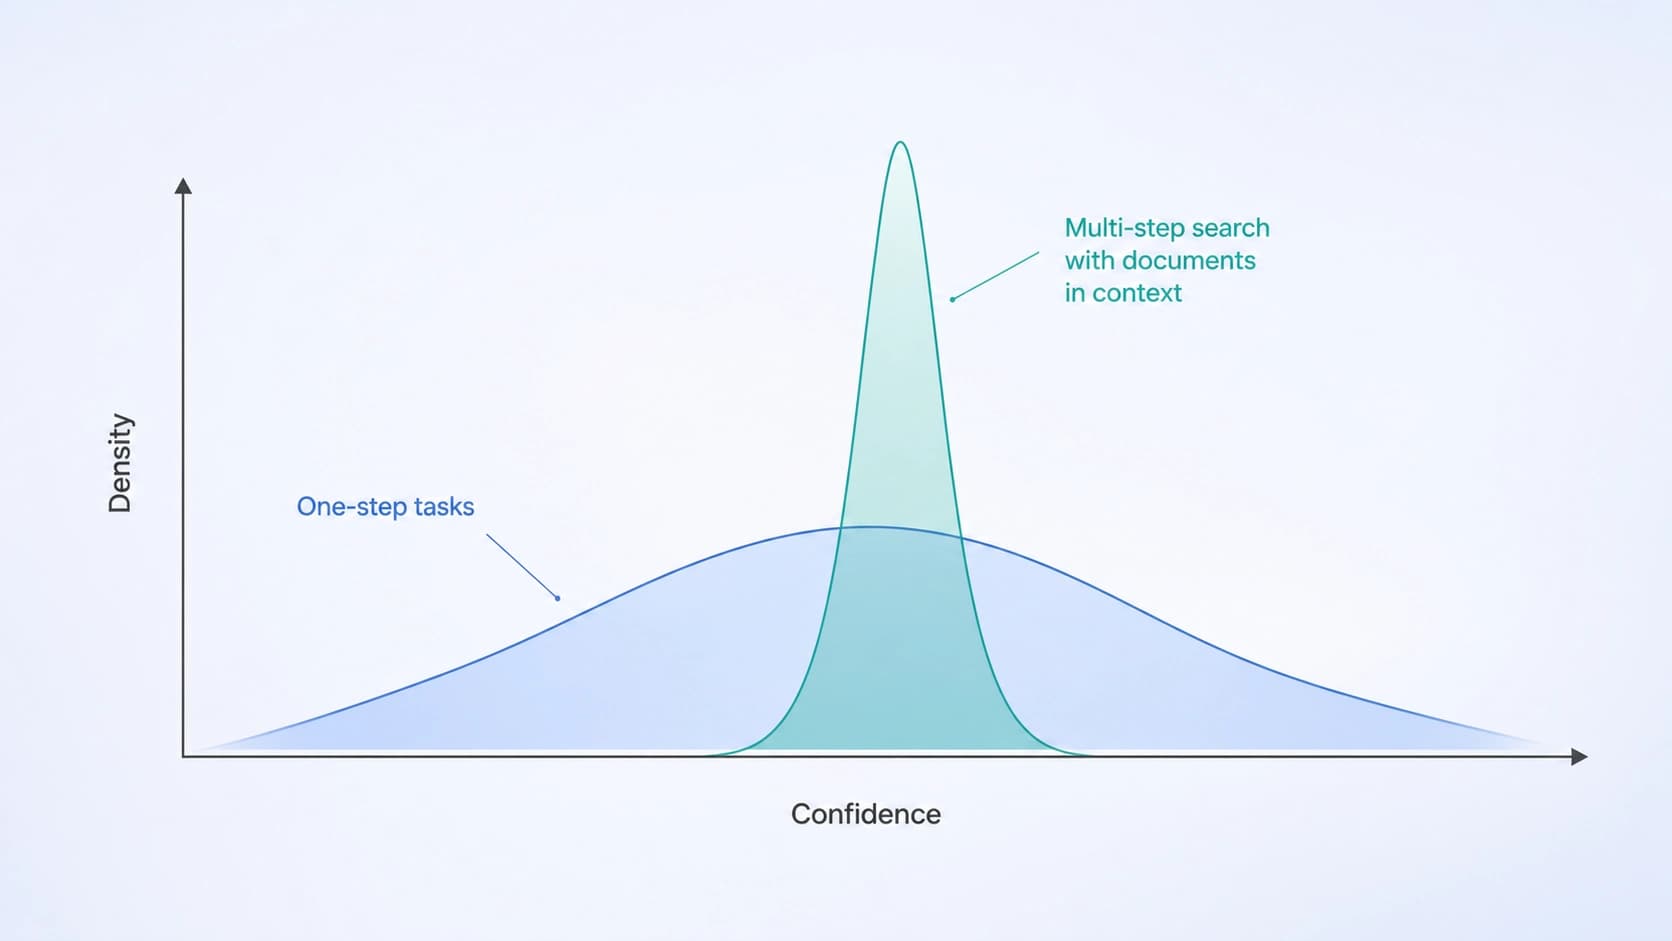
أطلق الباحثون على السبب اسم copy inflation — «التضخّم النسخي». فعندما تدخل المستندات المستخرجة إلى السياق، تحصل الرموز التي ينقلها النموذج من هذه المستندات إلى إجابته على لوغاريتمات احتمالية مرتفعة بشكل منهجي. فالنسخ عملية سهلة: متابعة نصّ ماثل أمام العينين أبسط إحصائيًا من توليد شيء من عندك. والنموذج «واثق» في هذا الرمز لا لأنه صحيح، بل لأنه منقول حرفيًا.
ثم يتراكم الأثر. ولأن جميع التشغيلات تستند بطريقة أو بأخرى إلى المستندات المستخرجة، فإنها جميعًا تنال نصيبها من الاحتمالات المتضخمة. وتتساوى تقديرات الثقة داخل السؤال الواحد، وتنضغط في نطاق ضيق — فيفقد التصويت المرجّح أهم ما وُجد من أجله: القدرة على التمييز بين تشغيل قوي وآخر ضعيف. وتصبح الأوزان شبه متطابقة، وتتحول عملية التجميع إلى أغلبية عادية، لكن مع عبء حسابي زائد.
ما المقترح: Retrieval-Grounded Voting
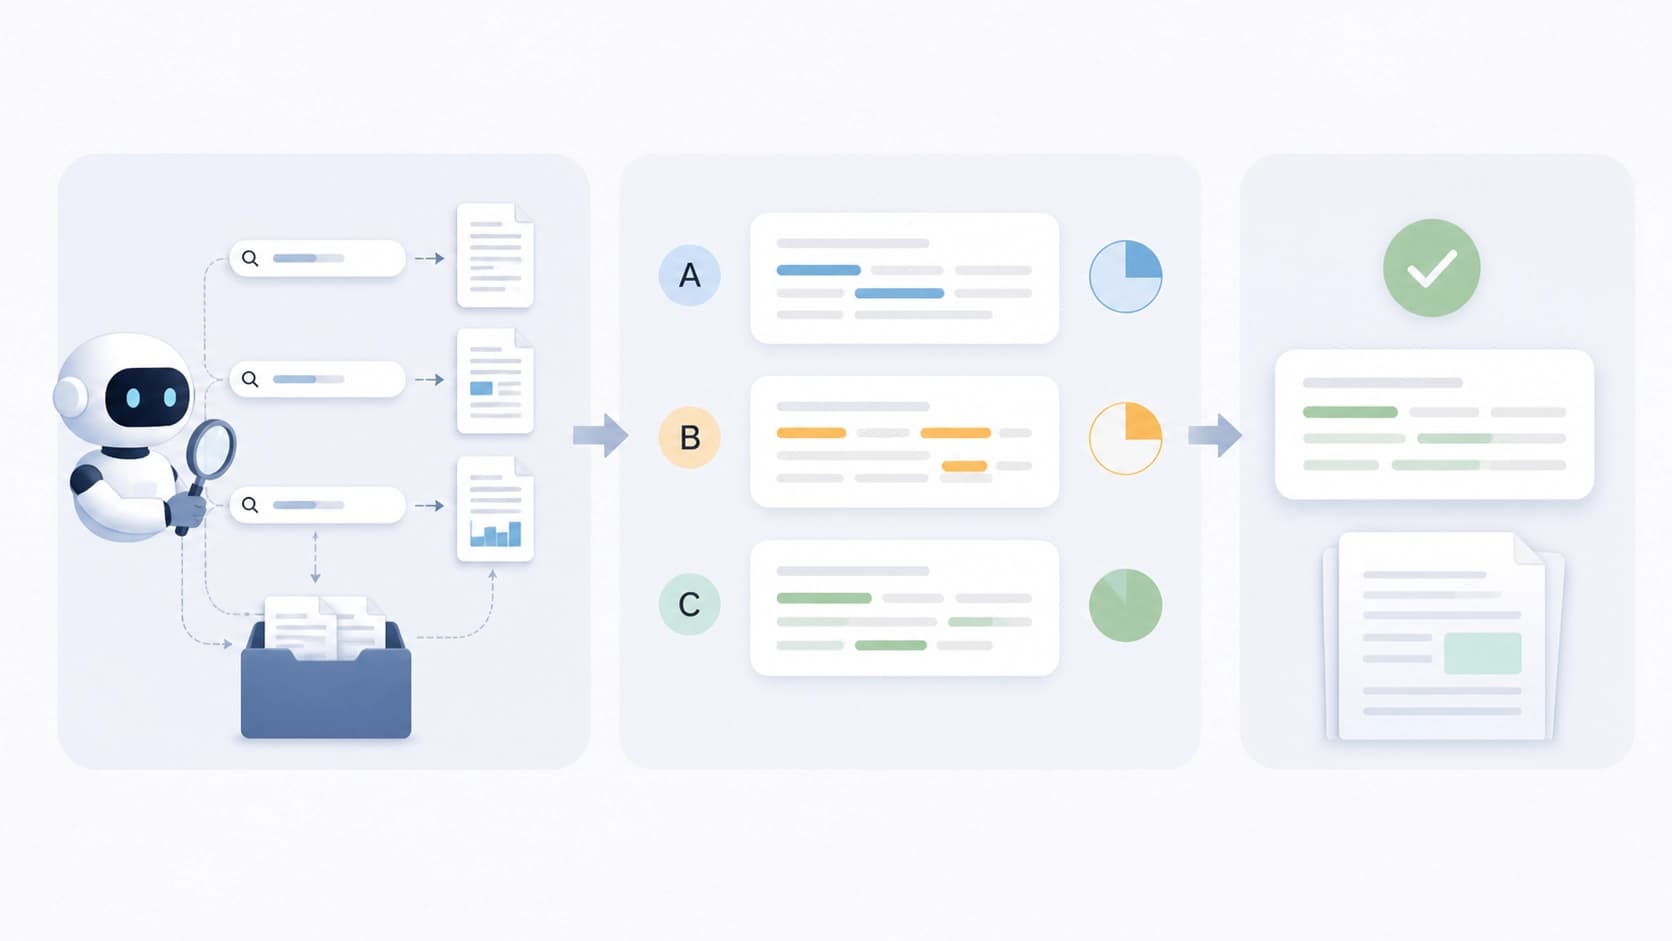
كبديل يقترح المؤلفون طريقة Retrieval-Grounded Voting (RGV). وهي أيضًا تقيّم كل تشغيل على حدة، لكنها لا تنظر إلى داخل النموذج، بل إلى خارجه — إلى الصلة بين الإجابة النهائية والمستندات التي جلبها هذا التشغيل بنفسه.
المقياس بسيط عن قصد: التقاطع اللفظي بين نصّ الإجابة ونصّ المصادر المستخرجة. فكلما استندت الإجابة بقوة إلى المادة المستخرجة، ارتفع سجلّها. أما التشغيل الذي اختلق شيئًا من عنده أو انحرف جانبًا، فيتقاسم مع مستنداته كلمات أقل وينال وزنًا أدنى.
لماذا تنجح الإشارة
المنطق هنا كالتالي: إذا وجد الوكيل فعلًا صفحات ذات صلة وبنى استنتاجه عليها، فستتقاطع حتمًا صياغات الإجابة مع صياغات المصادر — مصطلحات وأسماء وتعبيرات. وهذا ليس دليلًا مثاليًا على الصحة، لكنه مستقر حيث تكون اللوغاريتمات الاحتمالية قد فسدت بالفعل.
الميزة الجوهرية لـ RGV أنه يحسب الإشارة خارج السياق الملوّث. فالتقييم يُبنى على زوج «الإجابة — المستندات»، لا على حالة النموذج لحظة التوليد، ولذلك لا يؤثر فيه copy inflation. وفي الوقت نفسه تستغني الطريقة عن الوصول إلى اللوغاريتمات الاحتمالية للرموز وعن استدعاءات إضافية للنموذج اللغوي الكبير: لا نموذج حَكَم، ولا مرور ثانٍ، بل مجرد عدّ التقاطعات — عملية يمكن تنفيذها بكود عادي وبكلفة شبه معدومة.
النتائج
أُجريت التجارب على أربعة معايير تقييم لوكلاء البحث وعلى خمسة نماذج لغوية مختلفة. والصورة تتكرر: يتقدّم RGV بثبات على التصويت القائم على الثقة.
أكثر قياس دالّ هو على أسئلة «minority-correct»، حيث تظهر الإجابة الصحيحة في تشغيل واحد أو اثنين فقط من أصل ثمانية. وهنا بالتحديد يفشل الترجيح بالثقة أشدّ فشل: فالاحتمالات المتضخمة تجرّ التصويت نحو النسخة الشائعة لكن الخاطئة. ويبلغ التحسّن من RGV على هذه الأسئلة +35%، وعلى الدقة عمومًا حتى +5.4%.
تجدر قراءة الأرقام بتحفّظ: فهي ليست «زيادة خمسة بالمئة في جودة أي نظام بحث»، بل تحسين لإجراء التجميع عند تثبيت النموذج ومجموعة التشغيلات. أي أن الطريقة لا تغيّر شيئًا في الوكيل نفسه — إنها فقط تختار بعناية أكبر من بين ما ولّده الوكيل بالفعل.
ماذا يعني هذا عمليًا
إذا كنت تبني وكيلًا متعدد الخطوات وتستخدم بالفعل self-consistency أو أي تصويت قائم على الاحتمالات، فلـ RGV ثلاث مزايا عملية:
- لا يكلّف شيئًا على صعيد الاستدلال. لا حاجة إلى استدعاءات إضافية للنموذج، إذ يُحسب الوزن لاحقًا من الإجابات والمستندات الجاهزة.
- يعمل مع النماذج المغلقة. فاللوغاريتمات الاحتمالية للرموز ليست متاحة دائمًا، وأحيانًا تكون مخفية تمامًا خلف الـ API. ومقارنة النصوص بمنأى عن هذا القيد.
- قابل للضبط بشكل متوقّع. المقياس شفاف: يمكن النظر إلى الكلمات التي حققت التطابق وفهم لماذا نال التشغيل هذا الوزن.
أين قد يتعثر الأسلوب
نقطة الضعف واضحة من البنية نفسها: فالتقاطع اللفظي يكافئ تطابق الكلمات لا تطابق المعنى. والإجابة المعاد صياغتها لكنها الصحيحة ستنال وزنًا منخفضًا بغير إنصاف؛ كذلك النتيجة الرقمية أو الخلاصة القصيرة لن تتقاطعا تقريبًا مع النصّ الأصلي، حتى لو طابقته تمامًا. والحالة المعاكسة أكثر إزعاجًا: فالتشغيل الذي يقتطف الموجود بإسهاب سيجمع سجلًّا مرتفعًا دون أن يضيف شيئًا إلى الحل.
ومن هنا الاستراتيجية المعقولة — ألّا يُنظر إلى RGV كبديل عن كل الإشارات، بل كصوت إضافي مفيد تحديدًا حيث تتوقف ثقة النموذج عن الدلالة على أي شيء. ومن المنطقي أيضًا دمجه مع فحوص من أنواع أخرى: مقارنة المعاني، والتقييم بنموذج منفصل، والتحقق من الوقائع. ويبدو أن المؤلفين، استنادًا إلى صياغة المسألة، ساروا في هذا الاتجاه بالضبط — من «الثقة في الإحساس الداخلي للنموذج» إلى «تقييم ما فعله فعليًا».
الخلاصة
قصة copy inflation توضيح جيد لمشكلة عامة في خطوط معالجة الوكلاء: فالأساليب التي جرى ضبطها بمعزل على نموذج واحد وبخطوة استدلال واحدة تنهار بهدوء عندما تُضاف إلى الحلقة عمليات البحث والسياق ونصوص الآخرين. وتتوقف ثقة النموذج عن كونها مقياسًا للصحة وتتحول إلى مقياس لسهولة النسخ.
يقدّم RGV مسارًا جانبيًا يبدو مملًا تقريبًا — حساب تقاطع الكلمات بين الإجابة والمصادر. لكن هذه المملّية نفسها هي ما يجعل الطريقة جاذبة: فهي رخيصة وشفافة ولا تحتاج إلى داخل النموذج، وتقدم مكسبًا ملحوظًا حيث تغرق الإجابة الصحيحة في الضجيج. وبالنسبة للفرق التي تبني وكلاء بحث من واجهات API جاهزة، فهذه حالة نادرة من تحسين مفيد لا يتطلب إعادة تدريب ولا ميزانيات جديدة للاستدلال.


