
المتجه الجزيئي كبنية تحتية
في الكيمياء الحاسوبية، لم يعد تضمين الجزيء تفصيلاً تقنياً منذ زمن. إنه بنية تحتية قابلة لإعادة الاستخدام: التمثيل المتجهي نفسه يخدم التنبؤ بخصائص المركّب، والفحص الافتراضي، والبحث عن جزيئات مشابهة. تحسبه مرة واحدة — فتستخدمه في عشرات السيناريوهات، من ترتيب المكتبات إلى اختيار المرشحين للمختبر.
الطريق المسدود لتمثيل واحد
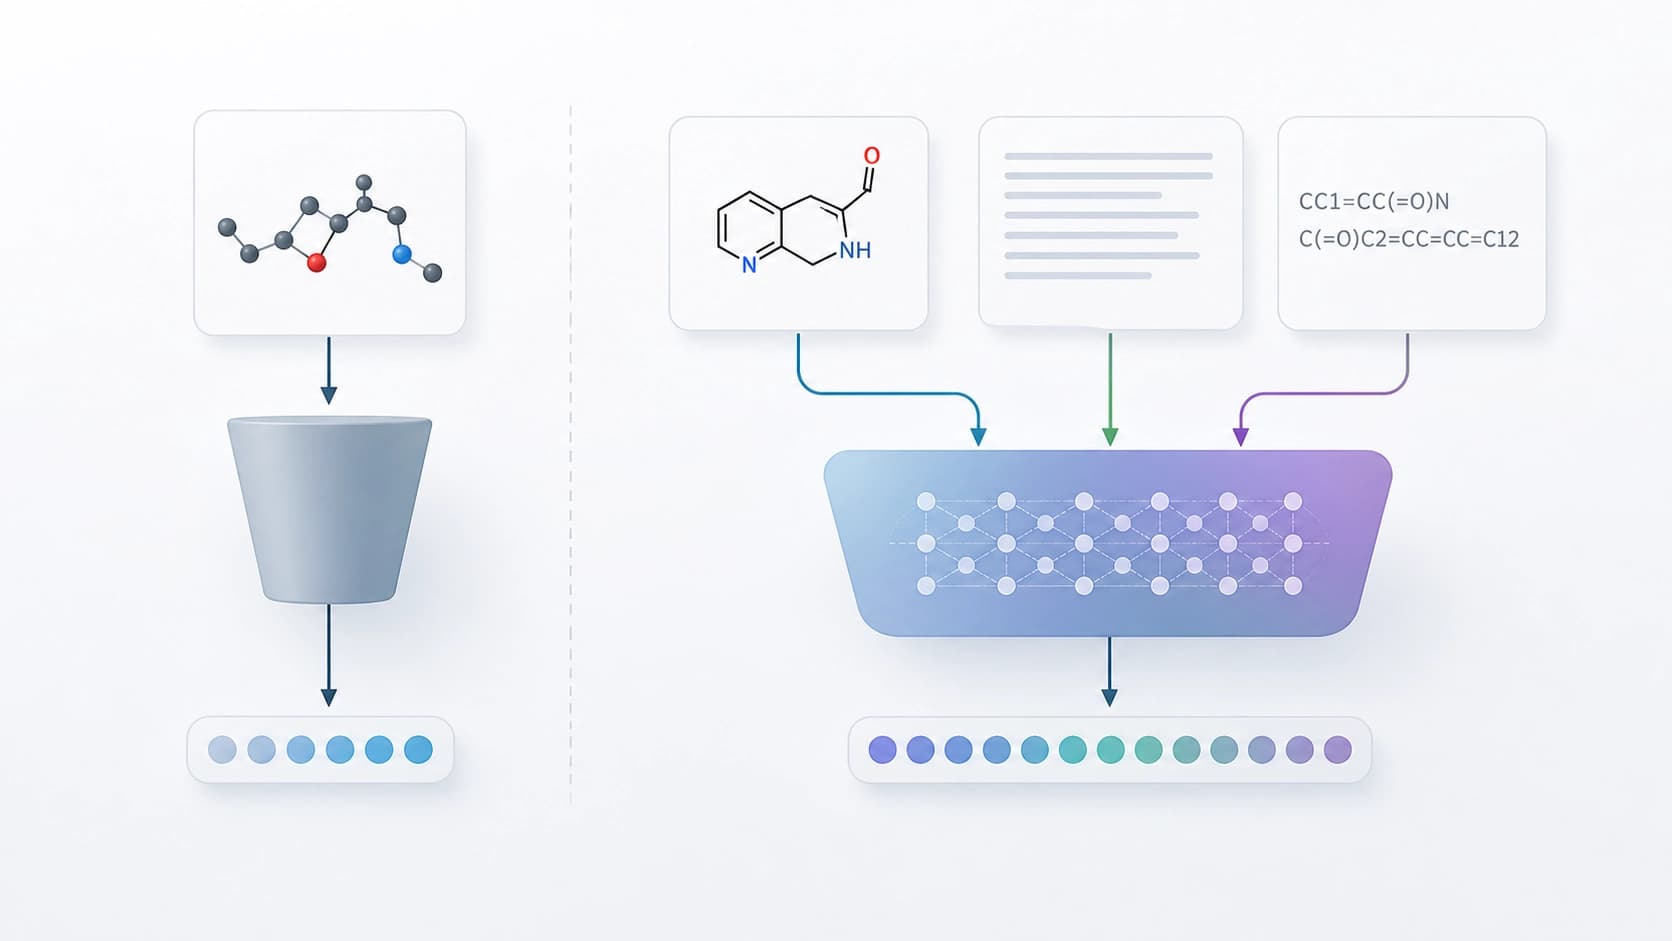
صُمّم معظم مُرمِّزات الجزيئات وفق مخطط واحد: تُختار نمطية واحدة — رسم بياني للذرات، أو سلسلة SMILES، أو مجموعة من الواصفات الفيزيائية الكيميائية، أو تشكيل ثلاثي الأبعاد — وتُدرَّب النموذج عليها حصراً. فيكون المتجه الناتج غير مشروط. لا توجد له واجهة يمكن من خلالها توضيح الطلب: «أريد نظيراً بحسب آلية التأثير، لا بحسب الهيكل الكربوني» أو «مركّب مشابه، لكن بهدف الذوبانية».
وينتج عن ذلك أثر مزعج. فالنموذج نفسه يرى الجزيء الواحد بطرق مختلفة، ولا يمكن مقارنة تمثيلاتها مباشرة — إذ إن الفضاءات غير متوافقة. ويُضطر الكيميائي حينها إلى الاحتفاظ في ذهنه بأي مُرمِّز يصلح لأي مهمة، بدلاً من أن يصوغ المهمة بالكلمات فحسب.
السؤال الذي طرحه المؤلفون
يبدأ عمل Xinjian Zhao وXiangru Jian وYaoyao Xu وXiaozhuang Song وWei Pang وLei Bai وTianshu Yu (arXiv:2608.23646، 24 أغسطس 2026؛ قُدِّم في ورشة FM4LS ضمن ICML 2026، غير أرشيفي) من هذا الاستياء تحديداً. يتساءل الباحثون: لماذا نبني أصلاً مُرمِّزاً منفصلاً لكل تمثيل للجزيء، إذا كانت النماذج اللغوية الكبيرة متعددة الأنماط قادرة بالفعل على التعامل أصلاً مع الصور والنصوص والتمثيلات الرمزية؟
المنطق بسيط. إذا كانت النموذج «يرى» أصلاً صورة الصيغة البنيوية، ويقرأ الوصف، ويحلل SMILES، فيمكن تحويله لا إلى مساعد مستشار، بل إلى مولّد للمتجهات. بل ومتجهات مشروطة — لا تعتمد على الجزيء نفسه فحسب، بل أيضاً على ما يُسأل عنه باللغة الطبيعية.
كيف يعمل الإطار
MolEmb إضافة خفيفة، لا نموذج كبير جديد. فهو يكيّف نموذجاً لغوياً كبيراً متعدد الأنماط موجوداً بالفعل بحيث تصبح الملامح الجزيئية وأوصافها النصية في فضاء تضمين مشترك واحد. العنصر الأساسي هو هدف تقابلي ثنائي الاتجاه: يقرّب أزواج «جزيء — نص» من بعضها، وفي الوقت نفسه يباعد بين الأزواج غير المتوافقة.
لماذا هذا أهم مما يبدو
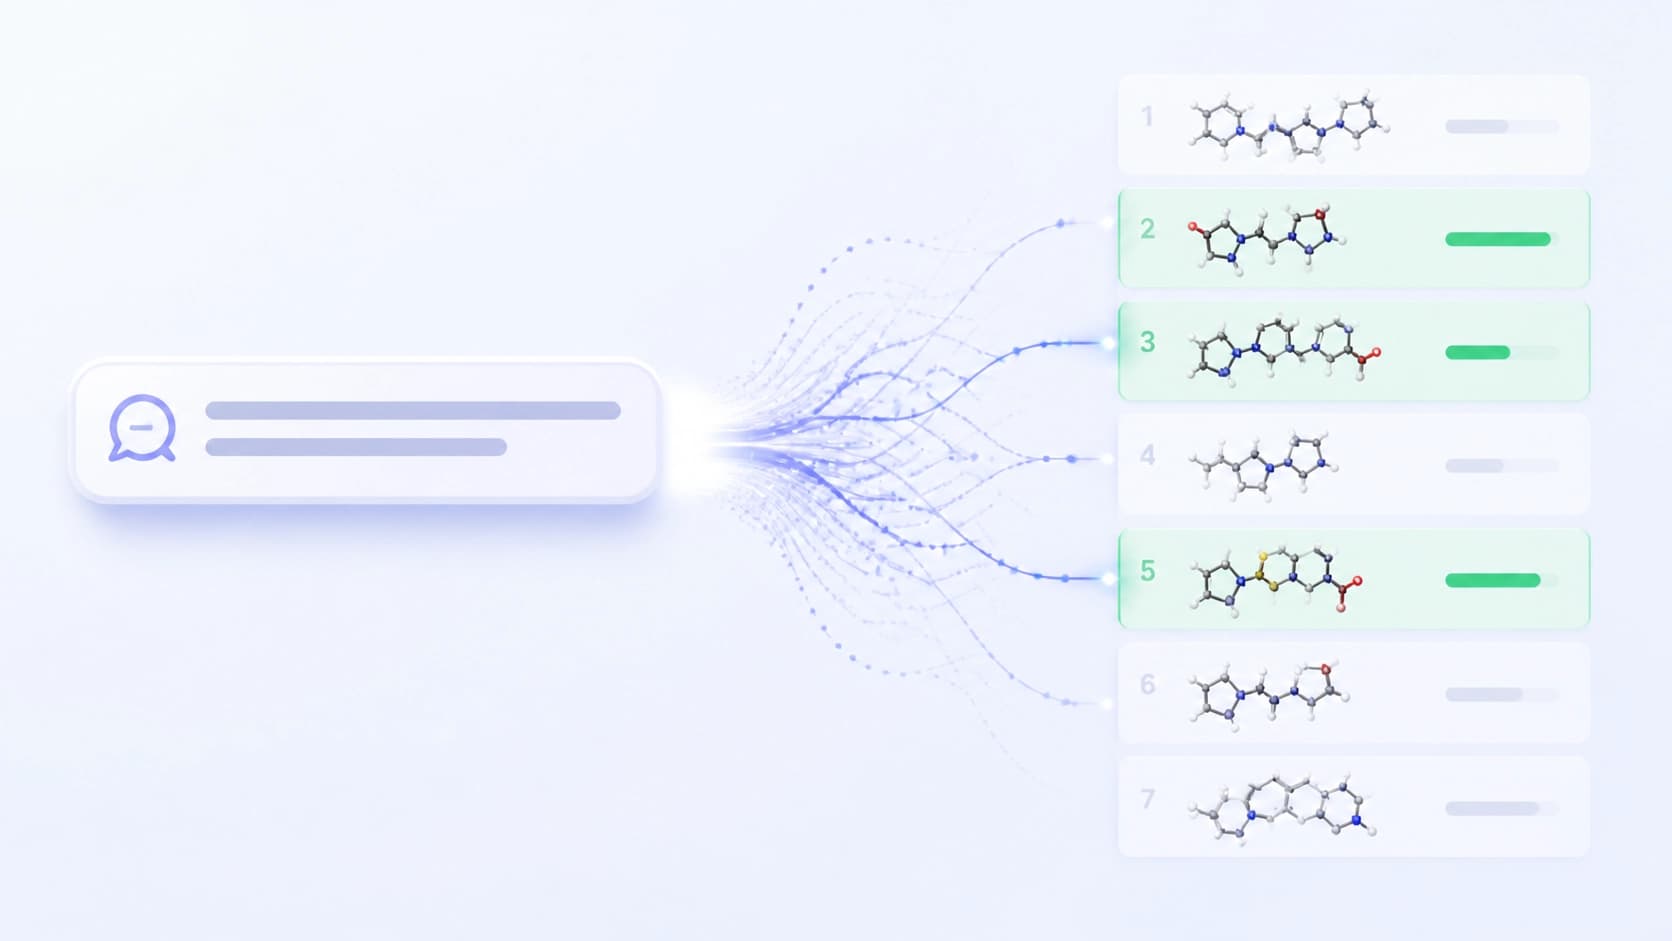
يحل التعلم التقابلي هنا مهمتين في آن واحد. أولاً، يحدد نظام إحداثيات مشتركاً: فيصبح متجه الجزيء ومتجه وصفه قابلين للمقارنة. ثانياً، يتيح بحثاً عابراً للأنماط في الاتجاهين — العثور على النص انطلاقاً من الجزيء، والعثور على الجزيء انطلاقاً من النص، وذلك داخل الفضاء نفسه، دون وسطاء بين الأنماط.
النتيجة المعلنة أكثر تواضعاً من «تجاوزنا كل المعايير المرجعية»، وهي لذلك أكثر مصداقية: التمثيلات الناتجة منافسة في التنبؤ بخصائص الجزيئات، وفي الوقت نفسه تدعم البحث بين الأنماط. أي أن الواجهة اللغوية لم تُشترَ بثمن تدهور المهام التقليدية.
اللغة كرافعة تحكم
الفرق الجوهري عن المُرمِّزات التقليدية يكمن في الشرطية. النموذج المتخصص يُخرج للجزيء متجهاً ثابتاً واحداً. أما الإطار فيتيح صياغة شرط بالكلمات والحصول على تمثيل منزاح نحو هذا الشرط. ويمكن تمثيل الجزيء نفسه بطرق مختلفة بحسب ما إذا كان يهمك السمية أو الذوبانية أو القرب من فئة مركّبات محددة.
البحث الجزيئي المعتمد على السياق
جزء منفصل من العمل هو المعيار التشخيصي MolCAR. أُنشئ للتحقق من البحث المعتمد على السياق، أي الحالات التي تتغير فيها الإجابة الصحيحة بحسب صياغة الطلب. وهذا أصعب جوهرياً من البحث الكلاسيكي عن هياكل مشابهة: هناك المرجع واحد، وهنا يعتمد على صياغة المهمة.
أكثر استنتاج مثير للاهتمام
ربما تكون أثمن ملاحظة للمؤلفين تبدو شبه عادية: التضمين الجزيئي المعتمد على السياق هو قبل كل شيء خاصية لبيانات الإشراف، لا حيلة معمارية. بعبارة أخرى، يبدأ النموذج في التمييز بين السياقات لا لأنه أُدمج فيه وحدة ذكية، بل لأنه دُرِّب على أزواج يختلف فيها السياق فعلاً.
الاستنتاج مُفِق ومفيد في آن واحد. فهو ينقل التركيز من سباق المعماريات إلى جودة بنية بيانات التدريب: إذا كانت أوصاف الجزيئات في مجموعة البيانات نمطية، فلن تمنح أي نمطية متعددة النموذج حساسية تجاه دقائق الطلب.
ما الذي يغيّره هذا عملياً
إذا كان هذا النهج قابلاً للتوسع، فالمكسب يبدو هكذا:
- بنية تحتية موحدة بدلاً من حديقة حيوانات من المُرمِّزات. نموذج واحد يغطي الخصائص والبحث والطلبات العابرة للأنماط.
- طلب بالكلمات بدلاً من اختيار النموذج. لا يحتاج المستخدم إلى معرفة أي مُرمِّز أفضل لحالته.
- فضاءات متوافقة. متجهات الجزيئات والنصوص تعيش معاً، ما يعني إمكانية مقارنتها ودمجها.
- إعادة استخدام نماذج MLLM الجاهزة. الإطار يكيّف نموذجاً موجوداً، لا يدرّب من الصفر.
الحدود والأسئلة المفتوحة
العمل مصنّف كغير أرشيفي، ما يعني أننا أمام اتجاه أكثر من كونه منتجاً جاهزاً. تبقى أسئلة كثيرة: إلى أي مدى يصمد النهج خارج مجموعات البيانات المختبرة، وكيف يتصرف مع فئات المركّبات النادرة، وهل يبدأ الجزء اللغوي في الهيمنة على الجزء الكيميائي، وهل يحوّل ذلك المتجه إلى إعادة صياغة للنص لا إلى تمثيل ذي معنى فيزيائي.
مع ذلك، تُصاغ الفكرة الرئيسية بوضوح. النماذج اللغوية الكبيرة متعددة الأنماط ليست مجرد مساعدين كيميائيين ولا مجرد مولّدات للإجابات. إنها تطمح إلى دور الآلية العامة للتضمينات الجزيئية: قابلة للتوسع، ومُدارة بالكلمات، ومفتوحة للتدريب الإضافي على مهام جديدة.


