
المشكلة: أثر الوكيل سجلّ وليس نموذج سلوك
يترك وكيل LLM متعدد الخطوات خلفه أثرًا طويلًا: استدعاءات الأدوات، الاستدلالات الوسيطة، التصحيحات، المحاولات المتكررة. قراءة هذا بالعين شبه عبثية — مئات الأسطر من النص، حيث تتوزع الإشارة المفيدة على كامل الحجم. وبالنسبة للمطوّر الذي يُطلق وكيلًا في بيئة الإنتاج، يتحول هذا السجل إلى صندوق أسود: لا يتضح أين انحرف التشغيل عن المسار، ولا ما الحالات الشائعة أصلًا في النظام.
وهذا بالضبط ما تتناوله ورقة arXiv:2608.23670 (cs.AI) «Automata from Agent Traces: Failure and Next-Step Prediction» — إذ يقترح مؤلفوها Seonglae Cho وFranklin Cardenoso Fernandez وUmar Mohammed وZekun Wu وKleyton Da Costa وIlham Wicaksono وAdriano Koshiyama النظر إلى الآثار لا كنص، بل كبيانات عن الانتقالات بين الحالات. المنطق بسيط: إذا تكرر سلوك الوكيل من تشغيل إلى آخر، فخلف الفوضى الظاهرة بنية، ويمكن استعادتها.
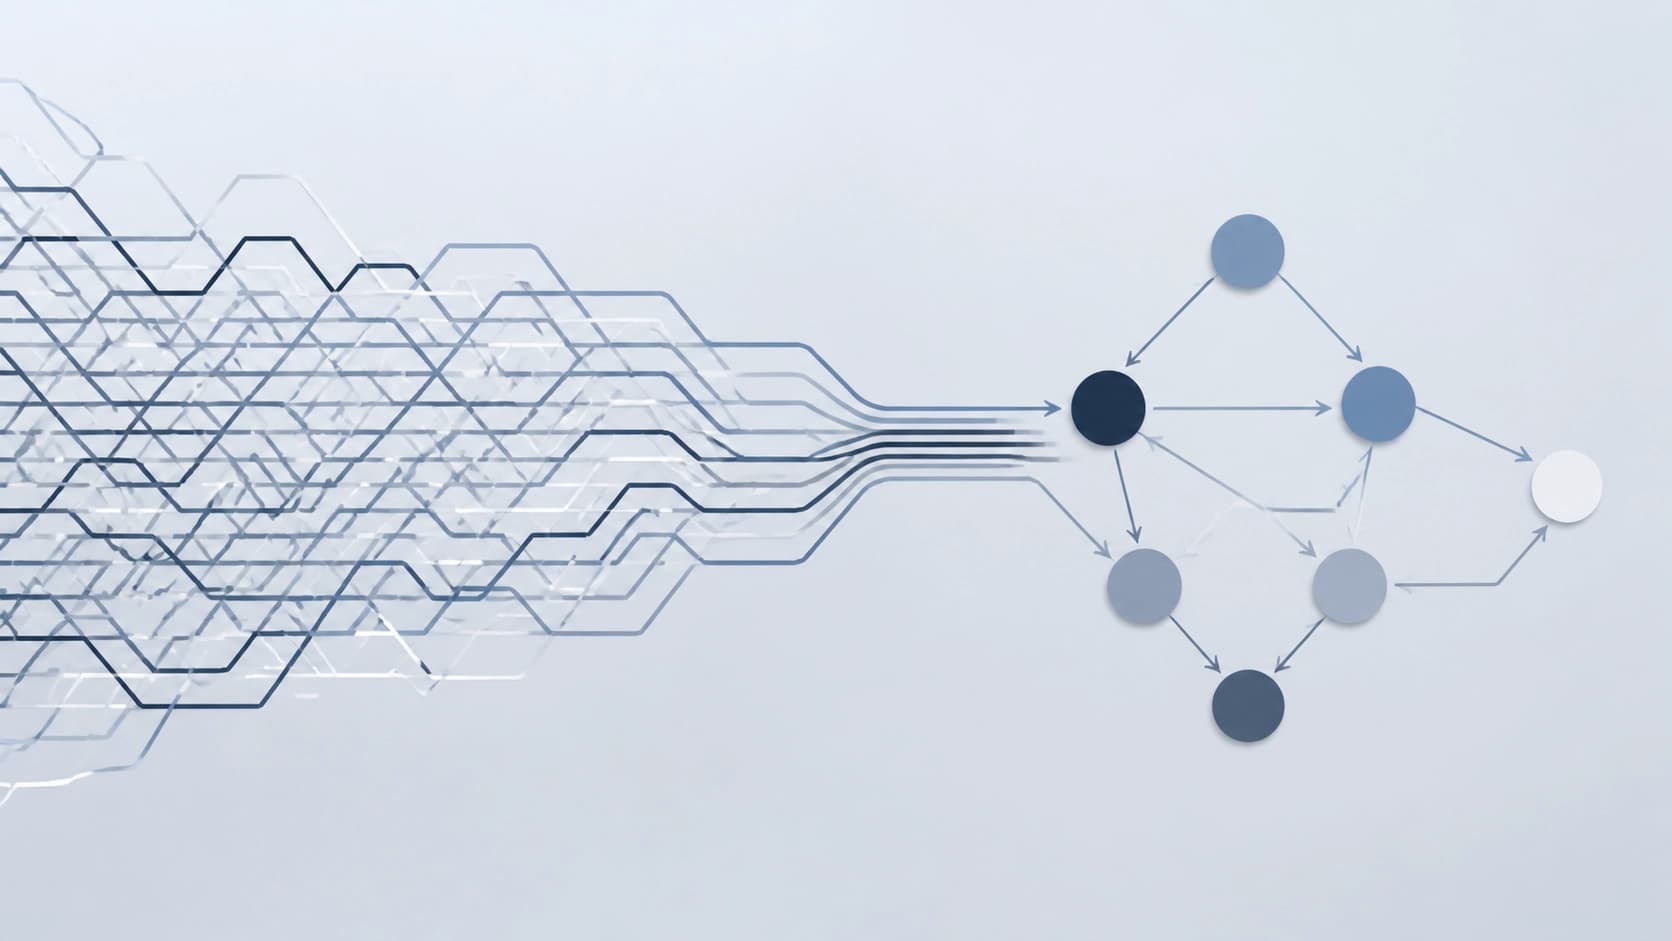
يجدر التنويه بما كانت تفتقده المقاربات السابقة. كان التحليل يُجرى عادةً على أثر واحد في كل مرة، أو يعتمد على التشغيلات الناجحة فقط. وفي الحالتين تضيع الصورة الكلية — تلك الطوبولوجيا التي تربط بين التنبؤ بالخطوة التالية والتنبؤ بالفشل. وهي تحديدًا ما نحتاجه لتدقيق الأمان والمراقبة في الوقت الفعلي.
آلة واحدة لكل المجموعة
فكرة الطريقة: أخذ مجموعة الآثار كاملة وطيّها في آلة حالات منتهية (FSM) واحدة مدمجة. ليست شجرة قرارات لكل تشغيل، ولا تضمينات في فضاء متجهي ما، بل رسم بياني عادي بحالات وانتقالات — ذلك الركيزة البنيوية ذاتها التي تجعل سلوك الوكيل، إن لم يكن قابلًا للتنبؤ، فعلى الأقل قابلًا للوصف.
تبدو النتائج على اثنتي عشرة مجموعة بيانات عامة مبشّرة:
- الآلات تأتي صغيرة — من 7 إلى 43 حالة، أي أنه يمكن رسمها ومناقشتها في اجتماع فعلًا؛
- على البيانات المحجوزة تعيد إنتاج الآثار بدقة fitness لا تقل عن 0.997 — تطابق شبه مثالي؛
- الطوبولوجيا المبنية على تقسيمات مختلفة من مجموعة البيانات نفسها تكاد تكون متطابقة؛
- البناء نفسه يستغرق أجزاء من الثانية، لا ساعات من التدريب.
النقطة الأخيرة أهم مما تبدو. فالطريقة التي تُبنى فورًا يمكن إعادة بنائها بعد كل تعديل على الـ prompt أو الإعدادات — ورؤية ما إذا تغيّر سلوك النظام على الفور.
لماذا هذا ليس مجرد تصوّر جميل
الاكتناز هنا ليس غاية في ذاته. عندما تكون لديك 20 حالة بدلًا من آلاف الأسطر من النص، تنشأ إمكانية التفكير في أنماط عمل الوكيل: هنا حلقة «جرّب — واجه خطأً — أعِد المحاولة»، وهنا فرع «انحرفت المهمة إلى أسئلة توضيحية»، وهنا حالة نادرة لا تكاد توجد مخارج منها. وبعد ذلك يمكن التعامل مع هذه الأنماط هندسيًا — مثل بناء سمات تُحسب لكل حالة.
التنبؤ بالخطوة التالية: الحالة أهم من الذاكرة
للتنبؤ بالإجراء التالي للوكيل، يستخدم المؤلفون سياق حالة FSM. ويتفوق هذا النهج على Agent Workflow Memory في كل مجموعة بيانات تكون فيها التسميات متوافقة مع مسار التنفيذ الفعلي. بعبارة أخرى، تبيّن أن معرفة «في أي نمط يوجد الوكيل الآن» أنفع من الذاكرة المتراكمة عن الحلقات السابقة.
هناك فارق دقيق مثير للاهتمام هنا. فسياق الحالة ليس مجرد رقم العقدة، بل وصف مضغوط لما حدث بالفعل وما سيحدث لاحقًا وبأي احتمال. والنتيجة أشبه بخريطة للاستمرارات المحتملة، مبنية لا على دلالات النص، بل على إحصاءات الانتقالات. وعمليًا، يعني هذا أنه يمكن تدريب متنبئ الخطوة التالية بتكلفة أقل: فهو لا يحتاج إلى الوصول إلى الحالات المخفية للنموذج، بل تكفيه البنية.
التنبؤ بالفشل والمراقبة عبر أثر جزئي
النصف الثاني من العمل يتناول التشخيص. فالسمات المحسوبة على حالات الآلة الفردية تعطي AUROC يصل إلى 0.94 على البيانات المحجوزة. أي أن نموذجًا لا يعرف شيئًا عن داخل LLM يميّز، عبر الخصائص السلوكية، بين التشغيلات التي ستنتهي بالفشل وتلك التي ستصل إلى النهاية.
وأكثر ما هو عملي هنا هو المراقب الفوري. فهو ينظر إلى أثر غير مكتمل ويرتّب التشغيلات المعطوبة أعلى من الناجحة، دون انتظار الخاتمة. وهذا يكفي لتفعيل الإيقاف المبكر قبل أن ينحرف الوكيل نهائيًا: لتوفير الرموز والوقت، والأهم، لمنعه من إلحاق الضرر. وبالنسبة لوكلاء يكتبون في قواعد البيانات أو يستدعون واجهات الدفع أو يديرون البنية التحتية، فإن هذه القدرة على قطع التنفيذ في منتصفه ليست ترفًا، بل شرطًا.
الخلاصة الرئيسية: السلوك تحدده البنية المحيطة، لا النموذج
ولعل أكثر أطروحات المقالة إثارة للجدل هي هذه: الطوبولوجيا السلوكية للوكيل تُحدَّد إلى حد كبير لا بالنموذج اللغوي نفسه، بل بـ deployment harness — تلك البنية المحيطة التي يعمل فيها النموذج. فقالب الـ prompt، ومجموعة الأدوات، وقواعد معالجة الأخطاء، وحدود الخطوات — هذه هي ما يشكّل رسم الانتقالات.
ويترتب على ذلك عدة استنتاجات. أولًا، قد لا يغيّر استبدال النموذج بآخر مع بقاء البنية المحيطة نفسها بنية السلوك جذريًا — ومن ثمّ يجدر اختبار الآلة المبنية على نموذج ما على نموذج آخر. ثانيًا، غالبًا ما يكون تحسين الوكيل عبر تغييرات في harness أكثر فعالية من ترقية الأوزان. ثالثًا، يظهر بذلك عنصر بنيوي محايد تجاه النموذج: النهج نفسه يصلح لتدقيق الأمان وللمراقبة أثناء التشغيل بغض النظر عن واجهة من تستدعي.
ما يجدر أخذه في الحسبان
لا يلغي هذا النهج الحذر. فاثنتا عشرة مجموعة بيانات لا تزال عيّنة محدودة، وfitness 0.997 يقول كم تصف الآلة جيدًا الآثار المجمّعة بالفعل، لا أنها ستتنبأ بسلوك النظام في بيئة غير مألوفة. كما أن ارتفاع AUROC للتنبؤ بالفشل مُحصَّل أيضًا على مهام محددة: في مجالات جديدة سيلزم إعادة حساب السمات.
ومع ذلك يبدو الاتجاه سليمًا. فبدلًا من توسيع نافذة السياق بلا نهاية والأمل في أن النموذج «سيتدبر الأمر بنفسه»، يمكن بناء نموذج سلوك مدمج للبنية المحيطة مرة واحدة — ثم استخدامه كمخطط: النظر إلى أين يتعثر الوكيل، وأي الحالات تؤدي إلى الفشل، وما الذي سيتغير إذا صُحّح الإعداد. الآلة ليست أذكى من LLM، لكنها أصدق: يمكن استيعابها بالكامل في الذهن، وهذا وحده نصف النجاح في التنقيح.


