
البروتوكول الذي لا ينفّذه أحد حرفيًا
نادرًا ما يُنفَّذ بروتوكول المختبر حرفيًا. بين النشر والتجربة الفعلية يقف دائمًا تقريبًا شيء من التكييف: سلالة خلوية مختلفة، كاشف مُستبدَل، عينات أقل، جهاز من مختبر آخر، ميزانية مقتطعة. بالنسبة لشخص يعمل على الطاولة الرطبة، هذا روتين، لكنه روتين خادع — فأي تعديل يجرّ خلفه سلسلة من العواقب. تغيّر حجم الكاشف في خطوة مبكرة، فيتعيّن عليك أن تتذكر ما سيترتب على ذلك في مرحلة الغسل وكيف يتوافق مع ما جرى سابقًا. وهذه القدرة بالتحديد — الإمساك بالبروتوكول كاملًا في الذهن وتعديله بوعي — هي ما تختبره مجموعة المهام الجديدة.
صدر البحث بعنوان BenchBench-Protocol في نسخة أولية على arXiv:2608.23898v1 (cs.AI)، قُدّمت في 24 أغسطس 2026. المؤلفون هم Aditya Sivakumar وAshu Singhal وNicholas Larus-Stone وNithin Parsan. يقع في 21 صفحة و15 شكلًا، أي أن المادة منهجية أكثر منها دعائية.
كيف جُمعت 149 مهمة من تعديلات مسودة
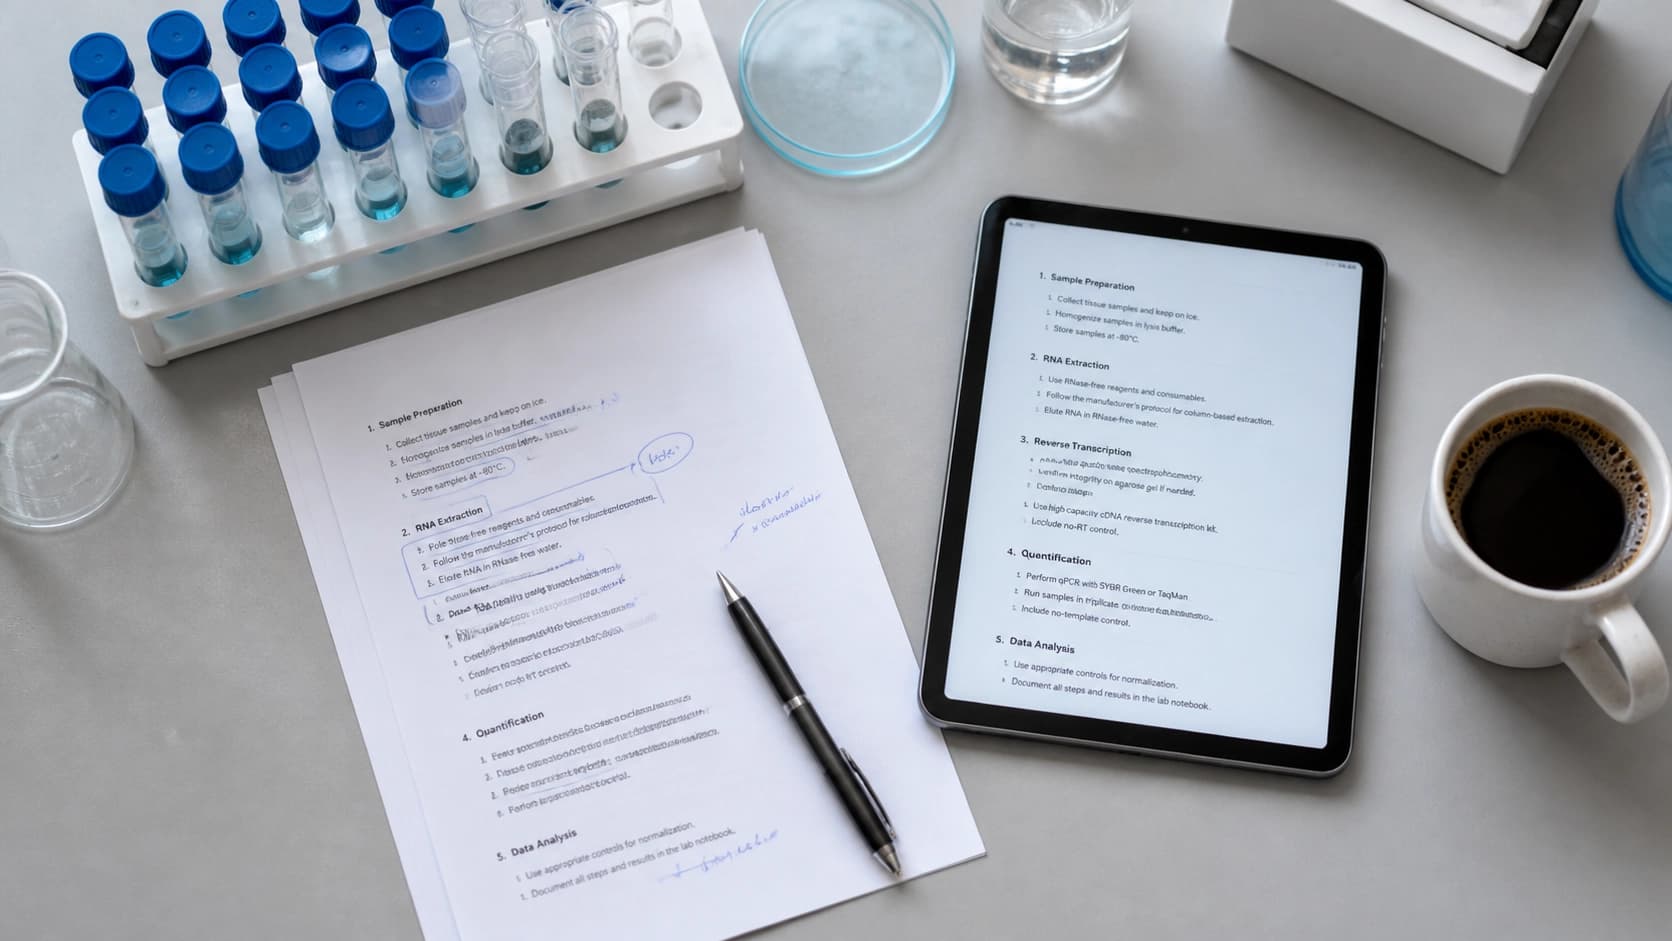
آلية BenchBench-Protocol غير معتادة. لم يجلس المؤلفون لكتابة الأسئلة — بل أخذوا أثر عمل موجودًا بالفعل. لكل بروتوكول منشور وُجدت نسخة عدّلها الباحث بما يناسب تجربته الخاصة. والفرق بين هذين المستندين هو ما صار مهمة: يُعرض على النماذج البروتوكول الأصلي وظروف التجربة الجديدة، وعليها أن تقترح التعديل الصحيح.
من هذا النهج ينبع مباشرة تفصيل مهم: للمهمة ليس «إجابة صحيحة» مجردة، بل معيار تقييم موزون. لأن التعديل الذي أجراه باحث حقيقي معروف — يمكن تفكيكه إلى عناصر وتقييم مدى تطابق اقتراح النموذج مع الحل الفعلي بالمعنى لا بالصياغة. وهذا يرفع المشكلة الأبدية في اختبارات الطب الحيوي، حيث قد يعطي النموذج إجابة معقولة لكنها لا تطابق النموذج المرجعي فينال صفرًا.
جاءت القاعدة متينة: 96 بروتوكولًا أصليًا من تسعة مجالات في بيولوجيا التجارب المختبرية الرطبة. ولم تدخل المجموعة النهائية إلا المهام التي اجتازت مراجعة الخبراء بتقييمات عالية، بينما استُبعد الباقي. والنتيجة هي تلك المهام الـ149 نفسها.
لماذا ليست مجرد مجموعة أسئلة أخرى من الخبراء
يوضح المؤلفون السياق بشكل منفصل. في السنوات الأخيرة، تحوّلت معايير التقييم في الطب الحيوي فعلًا نحو مهام مفتوحة تُقيَّم بمعايير موزونة — وهذا تقدّم. لكن المهام نفسها لا يزال الخبراء في أغلب الأحيان هم من يبتكرها: يجلسون ويكتبون أسئلة بناءً على خبرتهم. هذا النهج محدود لأن الخبير يجيب عن سؤال صاغه هو نفسه، أي أنه يتكيّف ضمنيًا مع تصوّره الخاص لدرجة الصعوبة.
هنا المنطق معكوس. تنشأ المهمة حيث اصطدم إنسان حقيقي بمشكلة حقيقية وأنفق وقتًا في حلّها. هذا لا يضمن نقاءً مثاليًا للبيانات، لكنه يضمن أن المهمة لم تُختلق من أجل صياغة أنيقة.
من نجح ومن لم ينجح
شاركت في الاختبار تسعة نماذج — مغلقة ومفتوحة. وتباينت النتائج بشكل ملحوظ، وإن لم يكن دراماتيكيًا.
سجّل Claude Opus 5 أفضل نتيجة — 59.2% من الدرجة المعيارية الموزونة. أما بقية النماذج فتراوحت بين 34.1% و47.1%. وبعبارة أبسط، لم يبلغ أحد مستوى المتصدر، لكن لا يوجد أيضًا انهيار إلى النصف: كل النماذج تجيد شيئًا ما، لكنها تفعله بطرق مختلفة وليس دائمًا حتى النهاية.
وثمة سطر منفصل في التقرير — اختبار التشبّع. منح المؤلفون النماذج عشر محاولات واختاروا أفضلها (best-of-10). وحتى مع هذا المخطط السخي، لم «ينطوِ» المعيار: لم يُبلَغ السقف. وهذه بشرى طيبة للتقييم — أي أن مجموعة المهام لن تتقادم بعد صدور الجيل التالي من النماذج.
ما الذي يترتب على ذلك عمليًا
الاستنتاج الأول عملي وفيه شيء من الإفاقة. لا يمكن بعد اليوم أن نأتمن النموذج اللغوي كليًا على تكييف البروتوكول. فحتى أفضل نتيجة عند 59.2% تعني أن نحو أربع حالات من كل عشر يتطلب فيها الاقتراح تدخلًا بشريًا. يصلح النموذج كمسودة، كمولّد خيارات، كوسيلة للتحقق السريع مما ربما أغفلته. لكنه لا يحمل المسؤولية النهائية عن أنبوب الاختبار.
الاستنتاج الثاني منهجي، وهو أكثر إثارة للاهتمام من الأول. يرى المؤلفون عملهم ليس فقط كتقييم للاستدلال في المختبر الرطب، بل كدليل على فكرة أعم: التجارب الحقيقية مصدر مُقلَّل من قيمته للمهام في معايير التقييم. فإذا كان في المختبر أصلًا تاريخ من التعديلات، فثمة مادة لاختبار النماذج — مادة يستحيل ابتكارها من خلف مكتب.
أما الاستنتاج الثالث فيتعلق بوجهة المضي قدمًا. الفارق بين 59.2% و47.1% لا يبدو كهاوية في ضوء صعوبة المهمة نفسها. إنه أقرب إلى تلميح بأن عنق الزجاجة ليس في حجم معرفة النموذج بعلم الأحياء، بل في قدرته على بناء سلسلة: مراعاة القرارات السابقة والتنبؤ بما ستؤدي إليه في الخطوات التالية. وهذه الصفة بالتحديد، لا حفظ الحقائق، هي ما تتناوله مجموعة التعديلات الـ149.


