
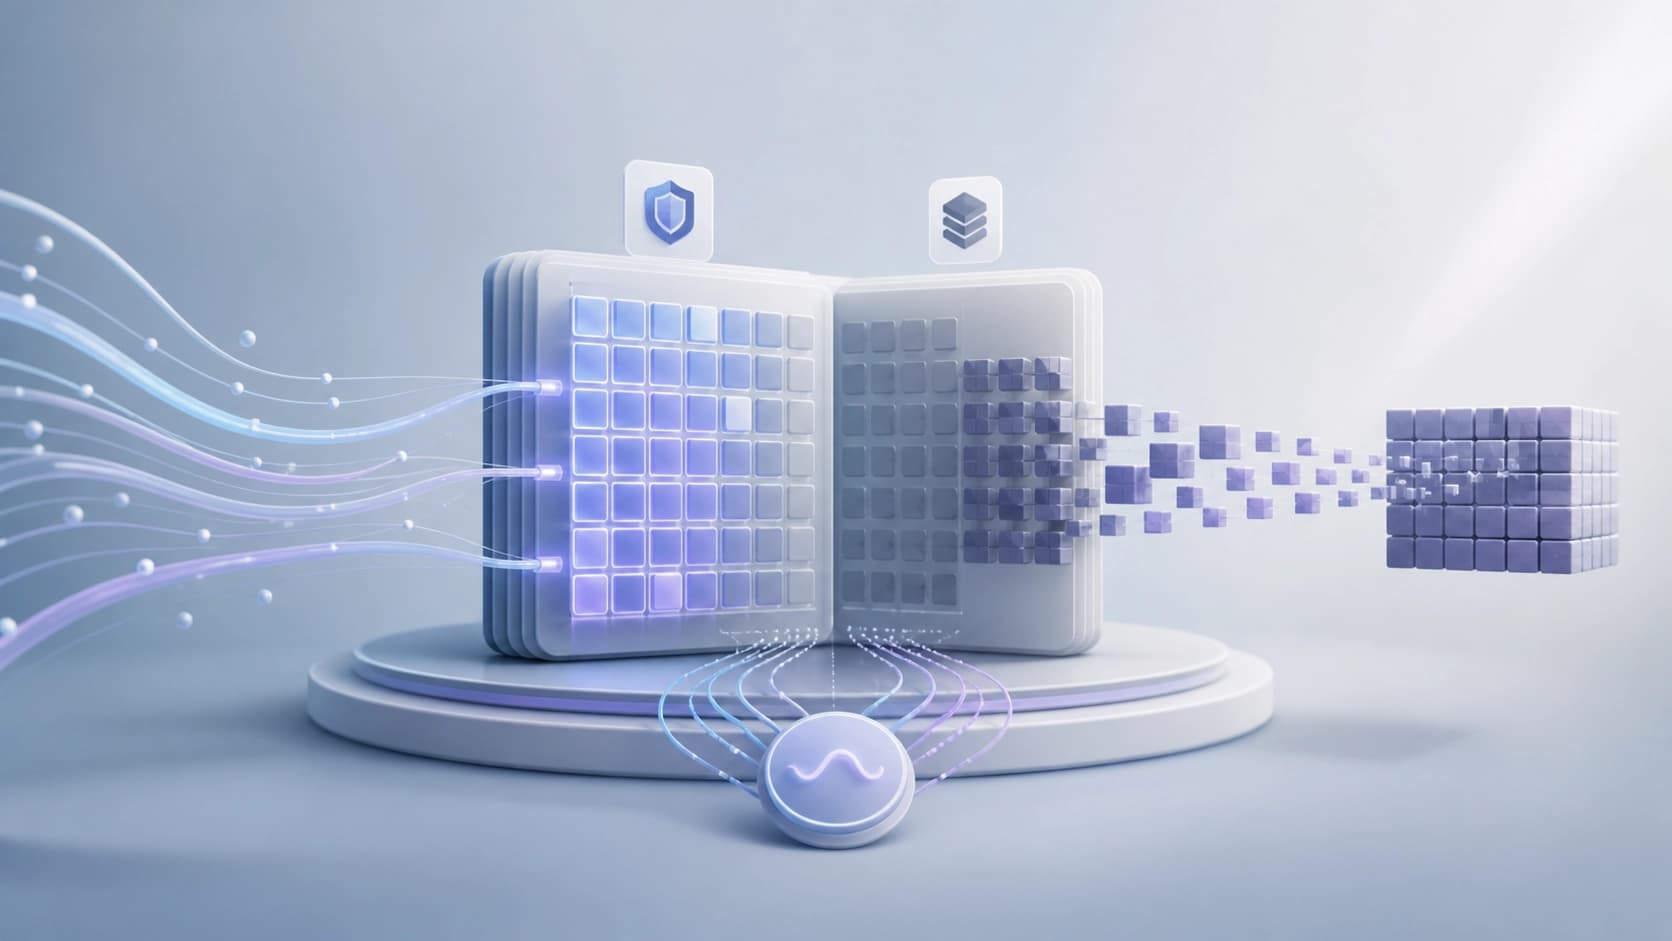
ملخص: أين تكمن المشكلة بالتحديد
عندما تخدم نموذجًا ذا سياق طويل طلبًا ما، لا تذهب النفقات الأساسية إلى الأوزان، بل إلى ذاكرة KV المؤقتة — المفاتيح والقيم المحفوظة لجميع الرموز المقروءة بالفعل. وكلما طالت الوثيقة أو المحادثة، زاد عدد الموترات التي يجب الاحتفاظ بها في الذاكرة، وزادت البيانات التي يجب إعادة قراءتها في كل خطوة توليد. ومن هنا تنشأ المعضلة النموذجية: إما اقتطاع السياق، أو دفع ثمنه من الذاكرة وسرعة الاستدلال.
عادةً ما تختار الحلول القائمة أحد طرفين متطرفين. فإما أن تضغط الحالة بأكملها، مع خطر فقدان المعلومات الحديثة التي تكون بالتحديد مطلوبة للإجابة التالية، وإما أن تبقي كل شيء بدقته الأصلية فتصطدم بسعة المسرّع.
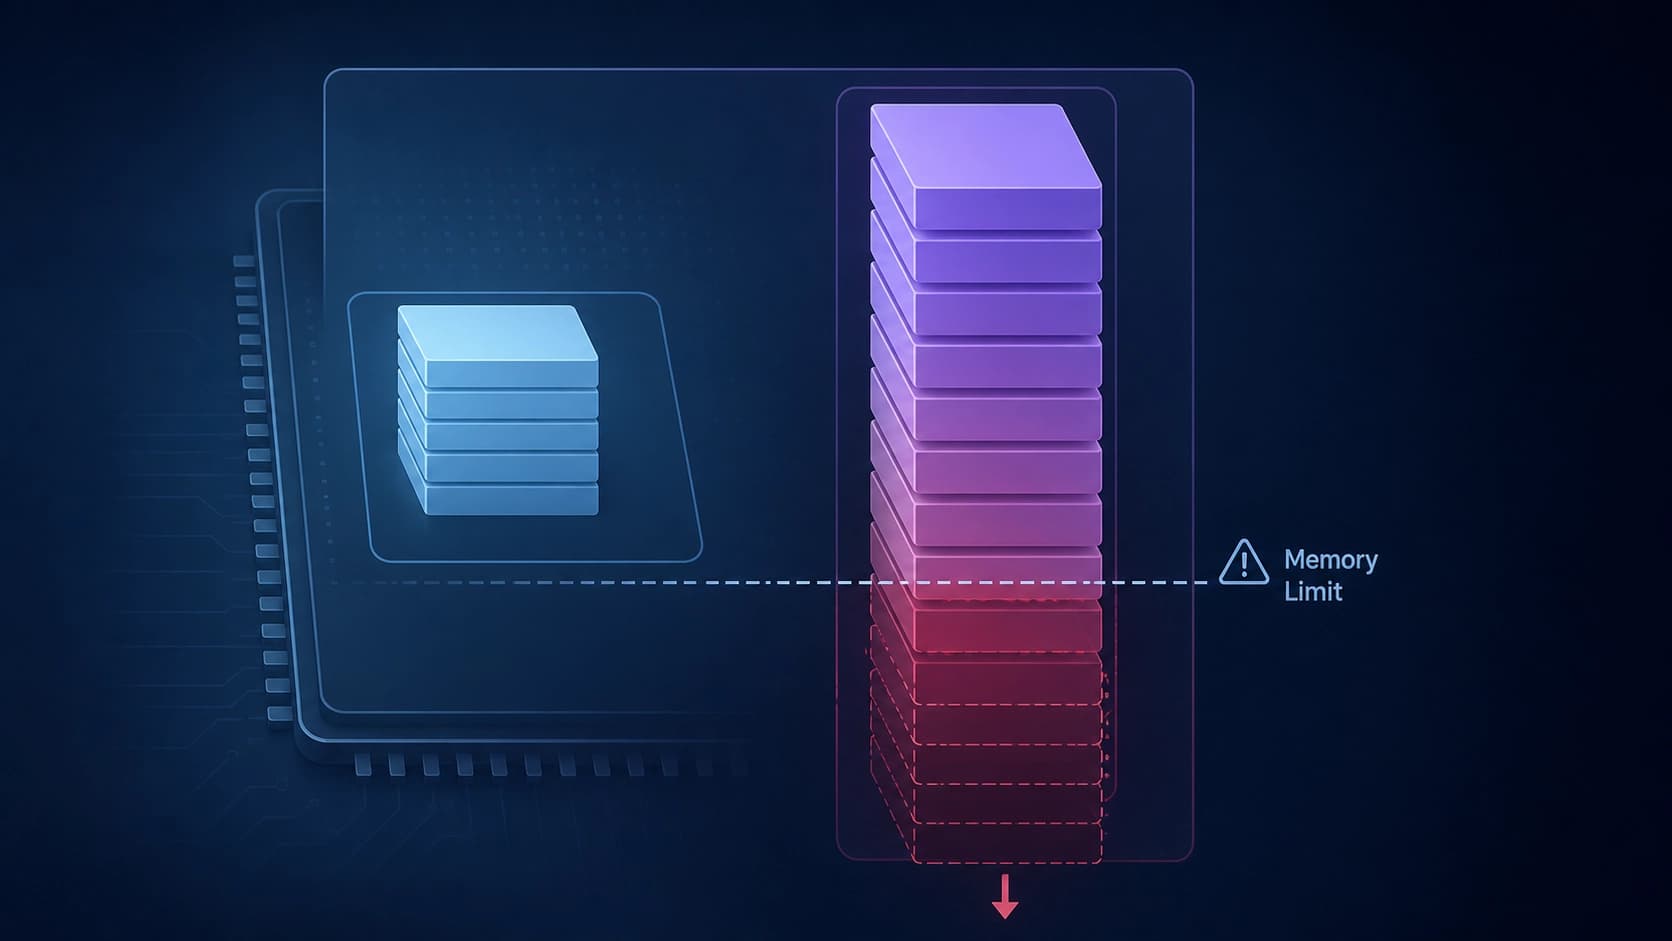
وفي هذا المفترق بالتحديد يحاول العمل الذي نتناوله أدناه أن يتدخل.
ما الذي يقترحه المؤلفون
قُدّمت الورقة «Minima-KV: Retention-Preserving KV Cache Compression with Mixed-Format Paged Attention» إلى arXiv في 24 أغسطس 2026 تحت الرقم 2608.23834، في قسم cs.AI، وتقع في 13 صفحة و3 أشكال، برقم DOI 10.48550/arXiv.2608.23834. والمؤلفان هما Sergii Kozyrev وDavyd Maiboroda من Minima AI, Inc. ومن التفاصيل الطريفة: في كتلة رابط PDF على صفحة المسودة الأولية تشير التسمية إلى المؤلف الأول «ومؤلفَين آخرَين»، مع أن الوصف الببليوغرافي يسرد اثنين فقط. تفصيل صغير، لكنه يذكّر بأن بيانات المسودات الأولية الوصفية تستحق التحقق.
جوهر ما تقترحه Minima-KV هو تسلسل هرمي لصفحات ذاكرة KV المؤقتة، حيث تُخزَّن صفحات مختلفة بصيغ عددية مختلفة. والكلمة المفتاحية في العنوان هي retention-preserving، أي «الحافظ للاستبقاء»: حالة الطلبات الحديثة لا تُستبعد إلى أي مكان.
مراسٍ بصيغة FP8 وأرشيف بصيغة TQ3
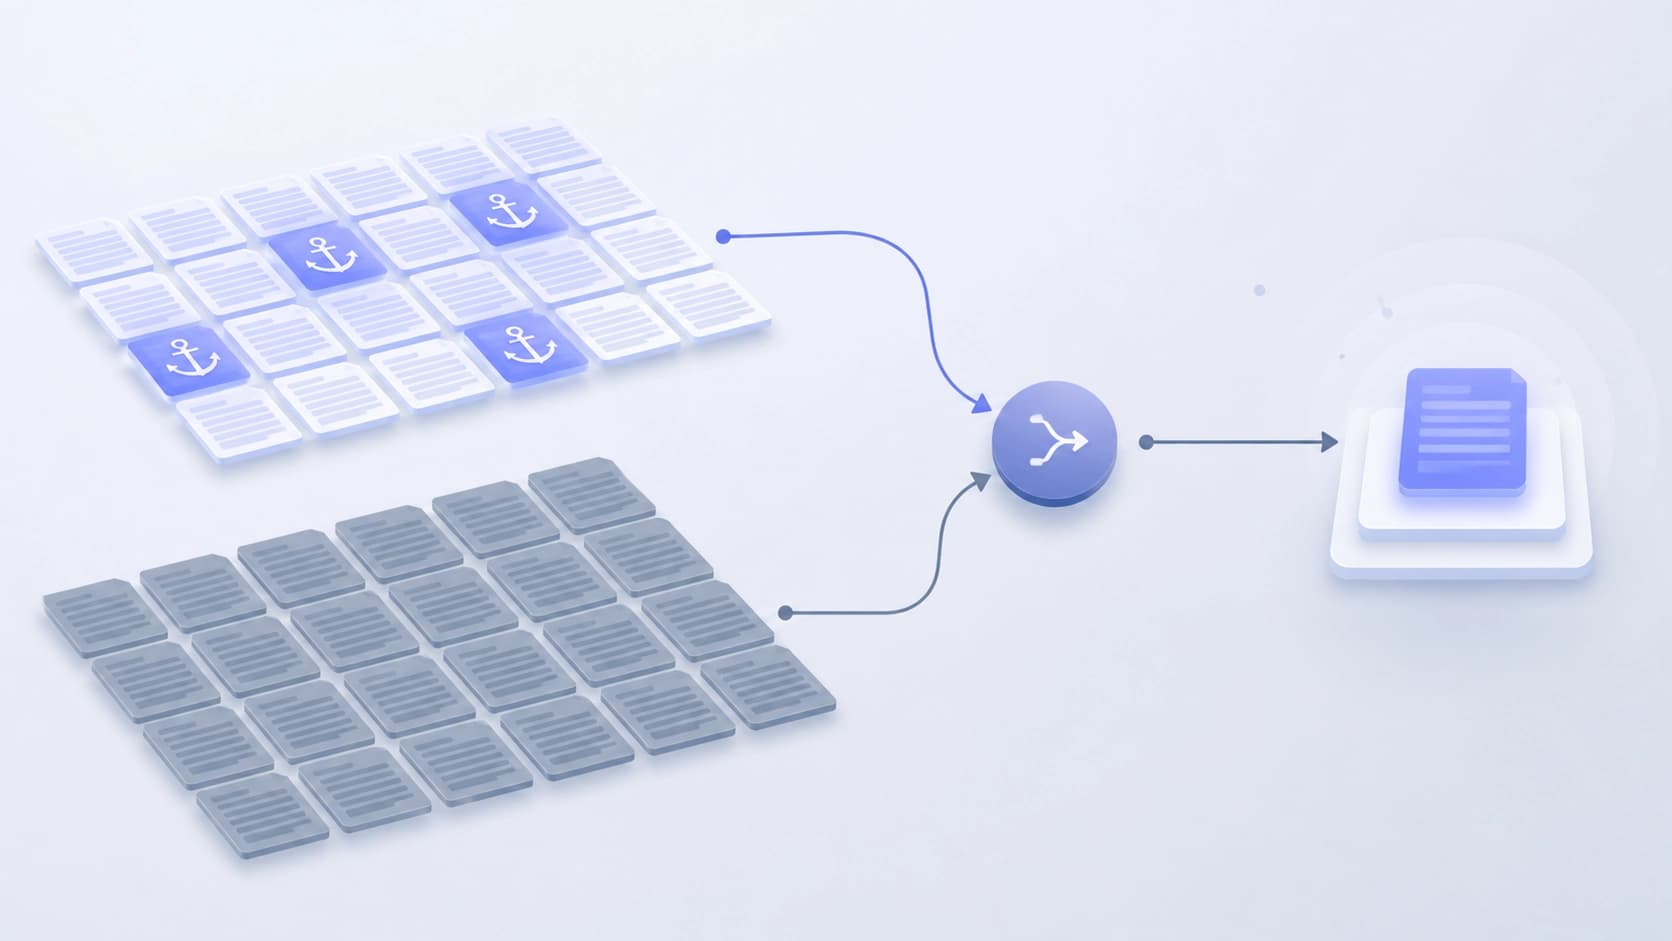
منطق التقسيم بسيط. الصفحات التي استُخدمت حديثًا والموسومة بأنها محمية (anchor) تبقى بصيغة FP8. أما الصفحات الأقدم التي لم تدخل ضمن المراسي فتُحوَّل إلى packed TQ3 — صيغة معبّأة أكثر كثافة. ومع ذلك، تظل كل صفحة من الطلب الحي قابلة للعنونة مباشرة: فلا شيء يُطرح من فضاء العنونة ولا يُستبدل بنسخة تقريبية.
كيف تُدمج النتائج الجزئية
الأكثر إثارة للاهتمام هو الحساب. تحسب نوى منفصلة لكل صيغة حالات الانتباه الجزئية الخاصة بها، ثم تُدمج عبر online-softmax merge مُطبَّع عالميًا. وبعبارة أبسط: بدلًا من توحيد جميع الصفحات على نوع واحد قبل الحساب، يحسب النظام مساهمة كل مجموعة بصيغتها الخاصة ويجمع النتائج المُطبَّعة بشكل صحيح.
وبفضل ذلك يسير فك الترميز مباشرة على ذاكرة مؤقتة غير متجانسة، دون ما يُسمى بالظل الكثيف — أي نسخة كاملة من الذاكرة المؤقتة بصيغة موحدة، وهو ما كان سيلغي كل التوفير في الذاكرة.
ما الذي تُظهره القياسات
الذاكرة والضغط
أُجريت القياسات على ملفات تعريف مرتبطة بتهيئة محددة للنموذج Qwen3.6-27B على مسرّع واحد NVIDIA RTX PRO 6000 Blackwell بذاكرة 96 غيغابايت. وكانت النتيجة 18.3 كيبيبايت من ذاكرة KV المؤقتة الانتباهية لكل رمز حي. وهذا يعني ضغطًا بمقدار 3.50x مقارنةً بـ BF16 و1.75x مقارنةً بـ FP8.
والرقم الثاني أهم مما يبدو للوهلة الأولى. فالمقارنة مع FP8 تُظهر أن المكسب لا يتحقق فقط بالانتقال من الدقة النصفية إلى صيغ أكثر اقتصادًا، بل تحديدًا بفضل المخطط الهجين للتخزين.
الجودة على السياق الطويل
تطابق الملف التعريفي المُجسِّد — الذي تُفكّ فيه الصفحات الهجينة فعليًا إلى موترات — مع ضابطه الكثيف في مهام RULER needle-in-a-haystack عند 16K. أي أنه في البحث عن إبرة في كومة قش لم يُكتشف أي فرق.
ثم تبدأ المقايضات. على مجموعة LongBench v2 المكوّنة من 503 أسئلة، جاءت الفروق سلبية: -0.80 نقطة مئوية عند 16K، و-0.60 عند 32K، و-0.40 عند 64K. ولاحظوا شكل المنحنى — فالخسائر لا تنمو خطيًا مع طول السياق، بل تتذبذب قليلًا. ولا يقدّم المؤلفون تفسيرًا، لكن هذه الحقيقة تستحق أن تُؤخذ في الحسبان عند التفسير: فالتشتت بأجزاء من النقطة المئوية يسهل الخلط بينه وبين ضجيج القياس.
اختبار الكناري
هناك اختبار منفصل — single-pair canary، حيث قُورن فكّا ترميز مباشران بطلبات من 59,008 رمزًا لكل منهما. والنتائج: انضغطت ذاكرة KV النشطة بمقدار 3.625 مرة، وبلغت الإنتاجية 0.9821x مقارنةً بالضابط، ووُجّهت جميع الطبقات الست عشرة للانتباه الكامل دون ارتداد إلى الوضع الكثيف، ولم تُحفظ أي نسخة ظل كثيفة.
والإنتاجية الأدنى قليلًا من الواحد هي في جوهرها مقايضة صادقة: نحو اثنين بالمئة من السرعة مقابل تقليص مضاعف للذاكرة المشغولة.
الاستنتاجات والتحفظات
استنتاج المؤلفين المعلن حذر: تُظهر النتائج مسارًا عمليًا لضغط حالة السياق الطويل بصيغ مختلطة دون استبعاد صفحات الطلبات الحية. وهذا بالتحديد ما كانت تفتقده المقاربات السابقة — ضغط لا يضحّي بالبيانات الحديثة في سبيل القديمة.
ما يستحق مراعاته عند القراءة:
- ملفات التعريف الاختبارية مرتبطة بتهيئة محددة. الحديث عن نموذج بعينه ومسرّع بعينه؛ ولم تُثبَت قابلية نقل الأرقام إلى معماريات أخرى.
- اختبار الكناري ضيق النطاق. زوج واحد من الطلبات، وسيناريو واحد لفك الترميز المباشر — وهذا توضيح لصلاحية العمل، لا إحصاء للحمل.
- التراجع على LongBench v2 غير صفري. أجزاء من النقطة المئوية قليلة، لكن في مهام تكون فيها كل وحدة دقة مهمة، يصبح هذا سببًا لإجراء قياس خاص.
- لا توجد بيانات عن زمن الاستجابة في ظروف الإنتاج. فالإنتاجية في اختبار الكناري، بحسب الوصف، تمرّ كلها عبر 16 طبقة دون مسار احتياطي — ومن المثير للاهتمام كيف ستتصرف عملية التوجيه في أسوأ الحالات، حين يزيد عدد الصفحات المرساة عن المعتاد.
القيمة العملية للورقة ليست في أرقام الضغط القياسية، بل في أمر آخر: فهي تُظهر أنه يمكن خدمة ذاكرة مؤقتة غير متجانسة مباشرةً، دون تجميع نسخة كاملة منها عند كل خطوة. وإذا كان هذا النهج قابلًا للنقل إلى نماذج أخرى، فسيصبح لدى سيناريوهات السياق الطويل رافعة إضافية إلى جانب التوسع العتادي.


