
اختيار المُرمِّز لا يتم بناءً على المقياس الصحيح
عادةً ما يُختار المُرمِّز المُجمَّد للمشروع بناءً على شيء واحد: مدى جودة تعلّم رأس خفيف فوق تمثيلاته — طبقة خطية، أو شبكة MLP صغيرة، أو شيء من هذا القبيل. إذا استطاع رأس بسيط استخلاص السمة المطلوبة، يُعتبر المُرمِّز ناجحًا. لكن هذا التقييم يجيب على سؤال «هل من السهل قراءة شيء ما من هذه التضمينات»، وليس على سؤال «هل تفصل هندسة الفضاء نفسها بين السمات». هذان سؤالان مختلفان، والخلط بينهما مكلف: فالرأس يُخفي ضعف التمثيل ما دامت المهام بسيطة وعدد الفئات قليلًا.
تُطرح مشكلة التوازن بشكل منفصل. ما دامت الفئات متقاربة في الحجم، يكاد لا يظهر الفرق بين «المُرمِّز قادر» و«الرأس يستخلص». وبمجرد أن تصبح إحدى الفئات نادرة، تبدأ المقاييس القائمة على أقرب الجيران في الكذب بشكل منهجي.
لماذا يكذب التنافر القائم على أقرب الجيران
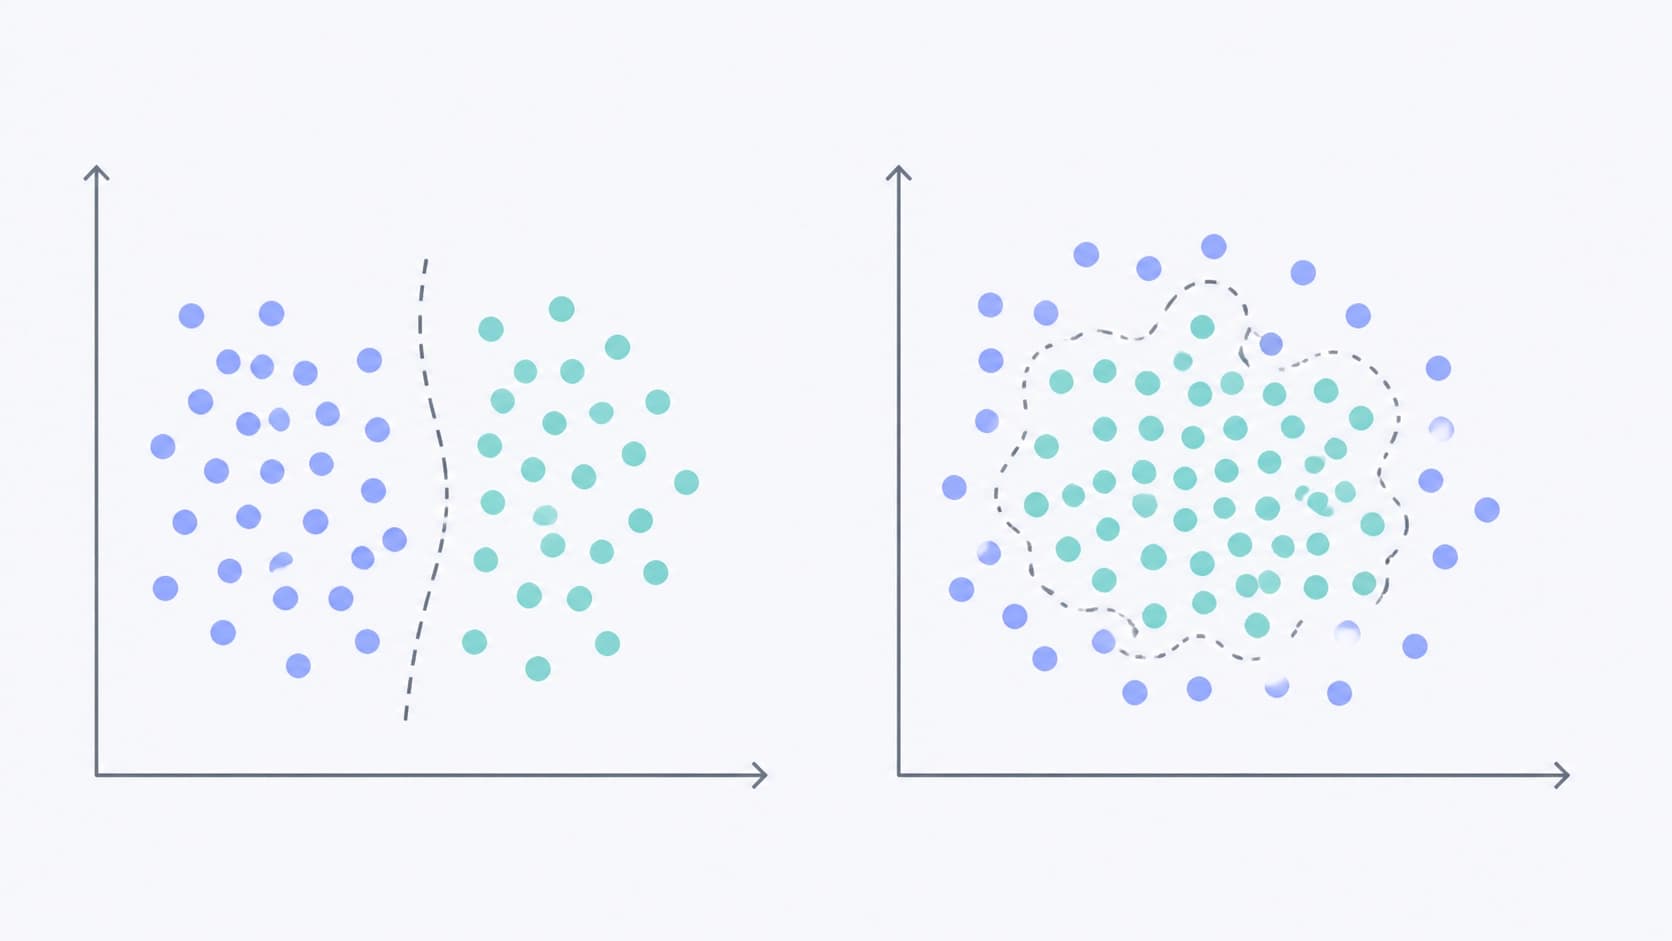
مقياس التنافر الكلاسيكي بسيط البنية: لكل نقطة يُبحث عن جيران في فضاء التضمينات، وإذا كان أقرب جار يحمل التسمية المعاكسة — تُسجَّل الحالة كحالة تنافر. داخل الفئة الواحدة تعمل الهندسة بشكل ممتاز، ولا اعتراض على الجيران.
المشكلة تكمن في لا تماثل الإجراء. فعندما يُجمع الجيران للأمثلة الموجبة والسالبة من مجموعات مختلفة الحجم، يفوز أقرب جار بالتسمية المعاكسة لا لأن الهندسة كذلك، بل لأن فئته أكثر كثافة في الجوار. بعبارة أخرى، يتسرب إلى النتيجة انتشار الفئة (prevalence) — وهي إحصاء خاص بمجموعة البيانات، لا خاصية للتمثيل. والأثر مزعج: يبدأ مُرمِّز غير مُطَّلع تمامًا بالظهور وكأنه أعمى، مع أنه في الحقيقة عديم الفائدة تمامًا كعملة معدنية عادلة، ولا أسوأ منها.
ما الذي يغيّره CANDOR بالتحديد
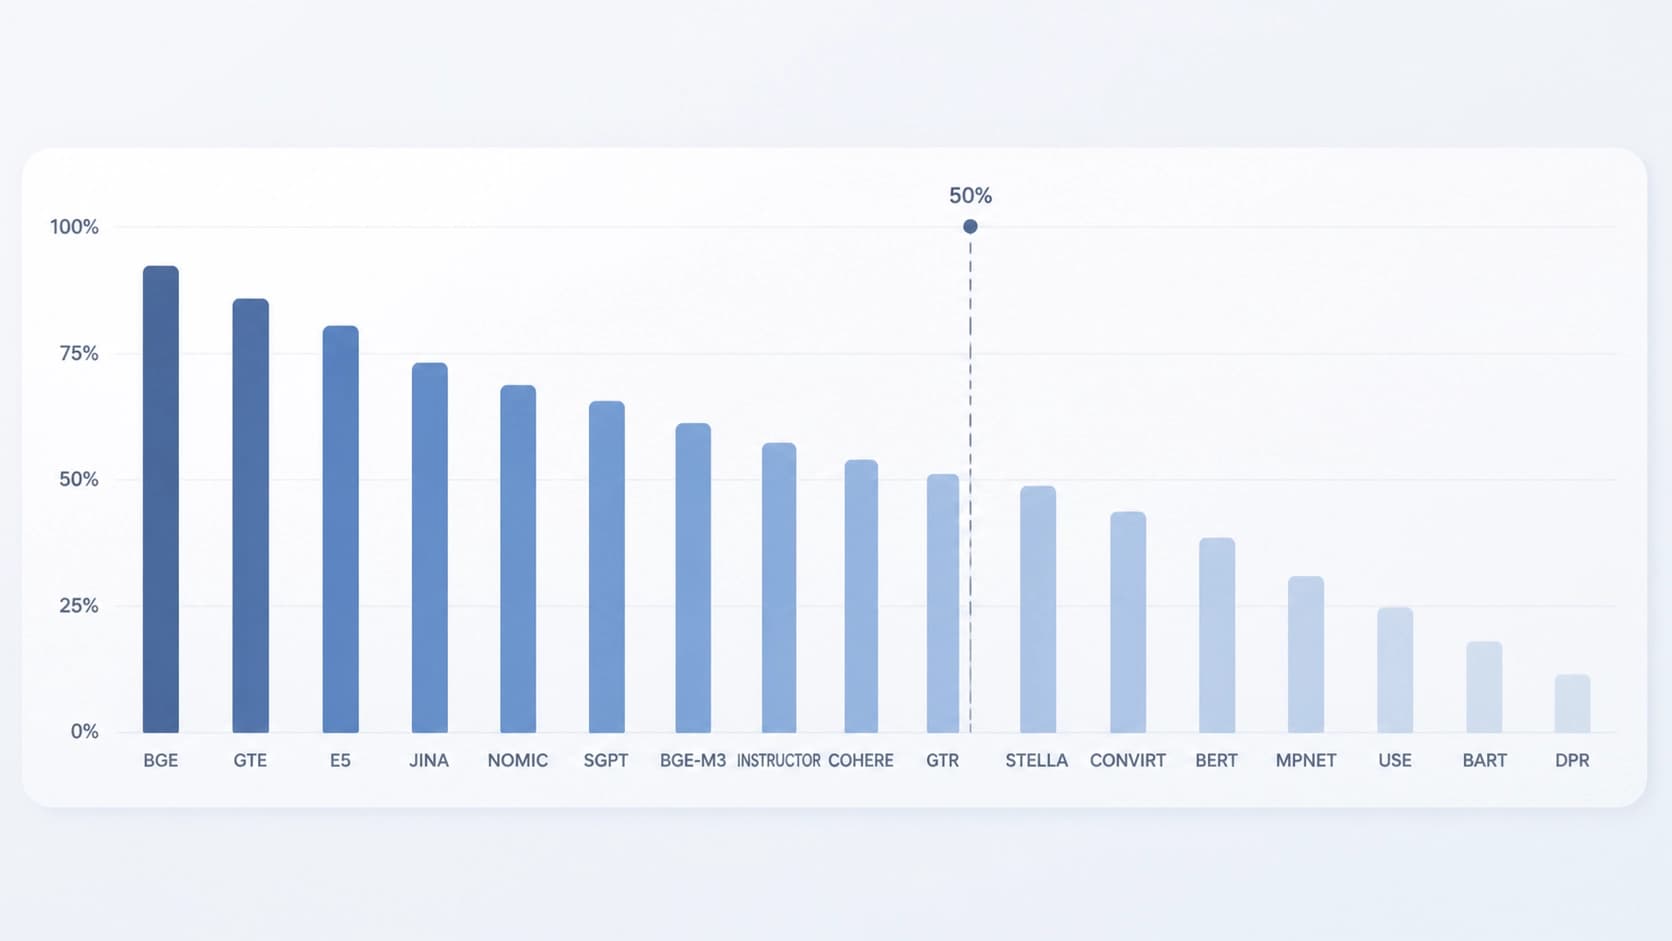
CANDOR — Chance-Calibrated Discordance in Frozen Foundation Encoders — يُعيد تعريف إجراء الحساب نفسه. فبنوك الجيران هنا تُجمع بأحجام متساوية، وبنية المقياس متماثلة بالنسبة لتبديل التسميات: بدّل الموجب والسالب، ولن تتغير القيمة. ونتيجة لذلك، يكون مستوى التخمين العشوائي مثبتًا تمامًا عند النصف — 50%. ليس «حوالي النصف، حسب مجموعة البيانات»، بل نقطة مرجعية صارمة عند 1/2.
هذا ليس تعديلًا تجميليًا. فنقطة المرجع المتغيرة تحديدًا هي ما كان يمنع مقارنة المُرمِّزات بعضها ببعض وبين مجموعات البيانات: حيث يكون الاختلال أقوى، كان التخمين العشوائي يبدو أسوأ مما هو عليه، فتحصل النموذج على ثقة غير مستحقة. وعندما تُثبَّت نقطة المرجع، تصبح المقارنة عادلة.
وثمة تفصيل آخر مهم عمليًا: بما أن نقطة المرجع ثابتة، يمكن حساب CANDOR قبل تدريب أي رأس كان. لا ضبط دقيق، ولا ضبط للمعاملات الفائقة — فالمقياس يصف التمثيلات نفسها، ويُنبئ مسبقًا بالنتائج التي يدعمها مُرمِّز مُجمَّد معيّن بشكل ضعيف.
التحقق على نطاق واسع
أجرى المؤلفون التقييم على نطاق واسع: 22 مُرمِّزًا، و20 مجموعة بيانات من 7 مجالات موضوعية، بمجموع 605,443 صورة. كان هذا الاتساع ضروريًا تحديدًا لفصل أثر المقياس عن خصائص مهمة واحدة بعينها.
النتيجة تقلب الاستنتاج الذي كان يؤدي إليه الإجراء القديم. فبعد التصحيح، يتبين أن انهيار التمثيلات أدنى من مستوى التخمين العشوائي في معظم الحالات. ويُقرأ هذا على النحو التالي: لا أحد من المُرمِّزات المفحوصة أعمى — فالمعلومات عن السمة موجودة في التمثيلات — لكنها جميعًا ضعيفة. صياغة «الجميع ضعيف، ولا أحد أعمى» تبدو ألطف من السابقة، وهي في الوقت نفسه تصف الواقع بدقة أكبر بكثير.
مثال سريري: رأس قوي مع هندسة ضعيفة
أوضح مثال على ذلك هو التصوير الطبي. أفضل نموذج للصدر يقرأ استرواح الصدر بدقة AUROC تبلغ 84.5. رقم معتبر، وهو ما يُنظر إليه عادةً عند اختيار النموذج. لكن النموذج نفسه يضع 18.4% من الحالات الموجبة أقرب إلى صورة تحمل التسمية المعاكسة من صورة تحمل النتيجة نفسها — داخل المستشفى نفسه، أي دون انزياح نطاقي يفسّر ذلك.
الفجوة بين «الرأس يحل المهمة جيدًا» و«الهندسة تخلط بين الموجب والسالب» هي ذلك التباين بعينه. فالرأس يعوّض عن تمثيل ضعيف؛ ويُظهر مقياس CANDOR أن التعويض المطلوب كبير.
ثم يأتي بعد ذلك المقارنة بين المجالات. فالمُرمِّز نفسه يميّز أنواع الطيور عند مستوى 4.5 (أي بشكل شبه مثالي)، بينما يترك نتائج الصدر عند 42.8، والزرق عند 49.8. وهذا الرقم الأخير يقف عند مستوى التخمين العشوائي، بل هو في جوهره أسوأ من الأوزان العشوائية. مُرمِّز واحد، وتدريب واحد، وثلاث جودات هندسية مختلفة تمامًا.
عجز في الانتقاء، لا في المعلومات
يترتب على ذلك سؤال طبيعي: إذن، هل التمثيلات ميؤوس منها؟ ليس تمامًا. فالعشوائية تُقيّد الهامش المُعيّر (normalized margin) لأي رأس ليبشيتزي — أي رأس ذي حساسية محدودة لإزاحة المدخل. غير أنه ضمن مجموعة من أحد عشر رأسًا يوجد رأس يكون صحيحًا في جميع الحالات إلا 2.8%، بينما يُخطئ رأس واحد بمفرده في 35.9%. فالمعلومات عن السمة موجودة في التمثيل — لكنها ليست متاحة بالقدر نفسه لأجهزة القراءة المختلفة. إذن، العجز مرتبط بالانتقاء (selection)، لا بغياب المعلومات.
وقد ظهر ارتباط مثير للاهتمام في موضع آخر أيضًا: الاحتفاظ عند المحو (erasure retention) مرتبط بالانهيار. أما مع هدف التدريب، أو حجم النموذج، أو قِدَم الإصدار، أو حجم النتيجة، فلم يُعثر على ارتباط. وبعبارة أبسط، «خذ نموذجًا أكبر وأحدث» لا يحل المشكلة — فهي ليست مسألة حجم ولا عمر.
ما الذي يترتب على ذلك عمليًا
ثلاثة استنتاجات عملية.
- احسب CANDOR قبل تدريب الرأس. إنه فحص رخيص يُظهر ما إذا كان المُرمِّز يدعم نتيجة نادرة معيّنة، ويتيح استبعاد العمود الفقري غير المناسب قبل أن تُنفق وقتك على الضبط.
- لا تخلط بين AUROC الخاص بالرأس وجودة التمثيل. 84.5 مع 18.4% من الحالات الموجبة المتنافرة — هذه حالة طبيعية، وليست نادرة، وتستحق أن تُقاس بشكل منفصل.
- لا تتوقع أن يُصلح الحجم والحداثة كل شيء. لم يُعثر على ارتباطات بالحجم أو هدف التدريب أو القِدَم؛ وضعف المُرمِّزات المُجمَّدة يبدو منهجيًا.
القيمة الأساسية لهذه القصة ليست في المقياس نفسه، بل في الاستنتاج المقلوب. كان يُظن سابقًا أن المُرمِّزات «عمياء» عن فئات معيّنة. وبعد المعايرة وفق الاحتمال، يظهر شيء آخر: إنها ترى في كل مكان تقريبًا، لكنها ضعيفة في كل مكان. هذه صورة أقل دراماتيكية بكثير، وأكثر قابلية للعمل بكثير — فمعها يتضح ما الذي يجب إصلاحه وبأي ترتيب.


