
تقييم وكلاء البحث يُبنى عادةً على سيناريوهات مكتوبة بعناية: عبارات معروفة مسبقًا، استعلامات متوقعة، ومستخدم «متوسط» واحد. هذا النهج سهل القياس، لكنه يعكس الواقع بشكل ضعيف، حيث يجلس خلف الواجهة نفسها أشخاص بإيقاع وأسلوب وصبر مختلفين تمامًا. ورقة AgentWorld: Personality-Aware Reliability Evaluation for Agentic Information Retrieval (arXiv:2608.24076، مقبولة في ورشة Agent4IR @ KDD 2026) تقترح النظر إلى موثوقية الوكيل بطريقة مختلفة — عبر شخصية المحاور وعبر محاولات كسر هذه الشخصية.
من النصوص إلى الشخصيات: أين تكمن الفجوة
المعيار الكلاسيكي للبحث الوكيلي يجيب على سؤال «هل أنجز الوكيل المهمة». لكنه يصمت بشأن ما يحدث بين الخطوات، ولا يقول شيئًا تقريبًا عن تباين النتائج. إذا كان جميع المستخدمين في الاختبار يتصرفون بالطريقة نفسها، ولم تُنمذج الهجمات على النظام إطلاقًا، فإن الاستنتاجات تصبح معقّمة: فبمثل هذا القياس يستحيل فهم أين بالضبط يبدأ الوكيل في التعثر.
هذه الثغرة تحديدًا يحاول المؤلفون — Gunja Agarwal وArup Kumar Das وArun Menon وJitesh Chandra Mishra وVignesh Divakaran — سدّها. فكرتهم الأساسية بسيطة: تباين سلوك المستخدمين ينبغي ألّا يُخفَّف، بل أن يُحوَّل إلى أداة قياس مستقلة.
ما هو AgentWorld
AgentWorld هو محاكي، وليس محرك بحث مستقلًا. فهو لا يحل المهام بدلًا عن الوكيل، بل ينشئ بيئة يمكن فيها تشغيل الوكيل عبر سيناريوهات مختلفة وأنواع مختلفة من المحاورين، مع تسجيل ليس الإجابة النهائية فحسب، بل مسار الحصول عليها أيضًا.
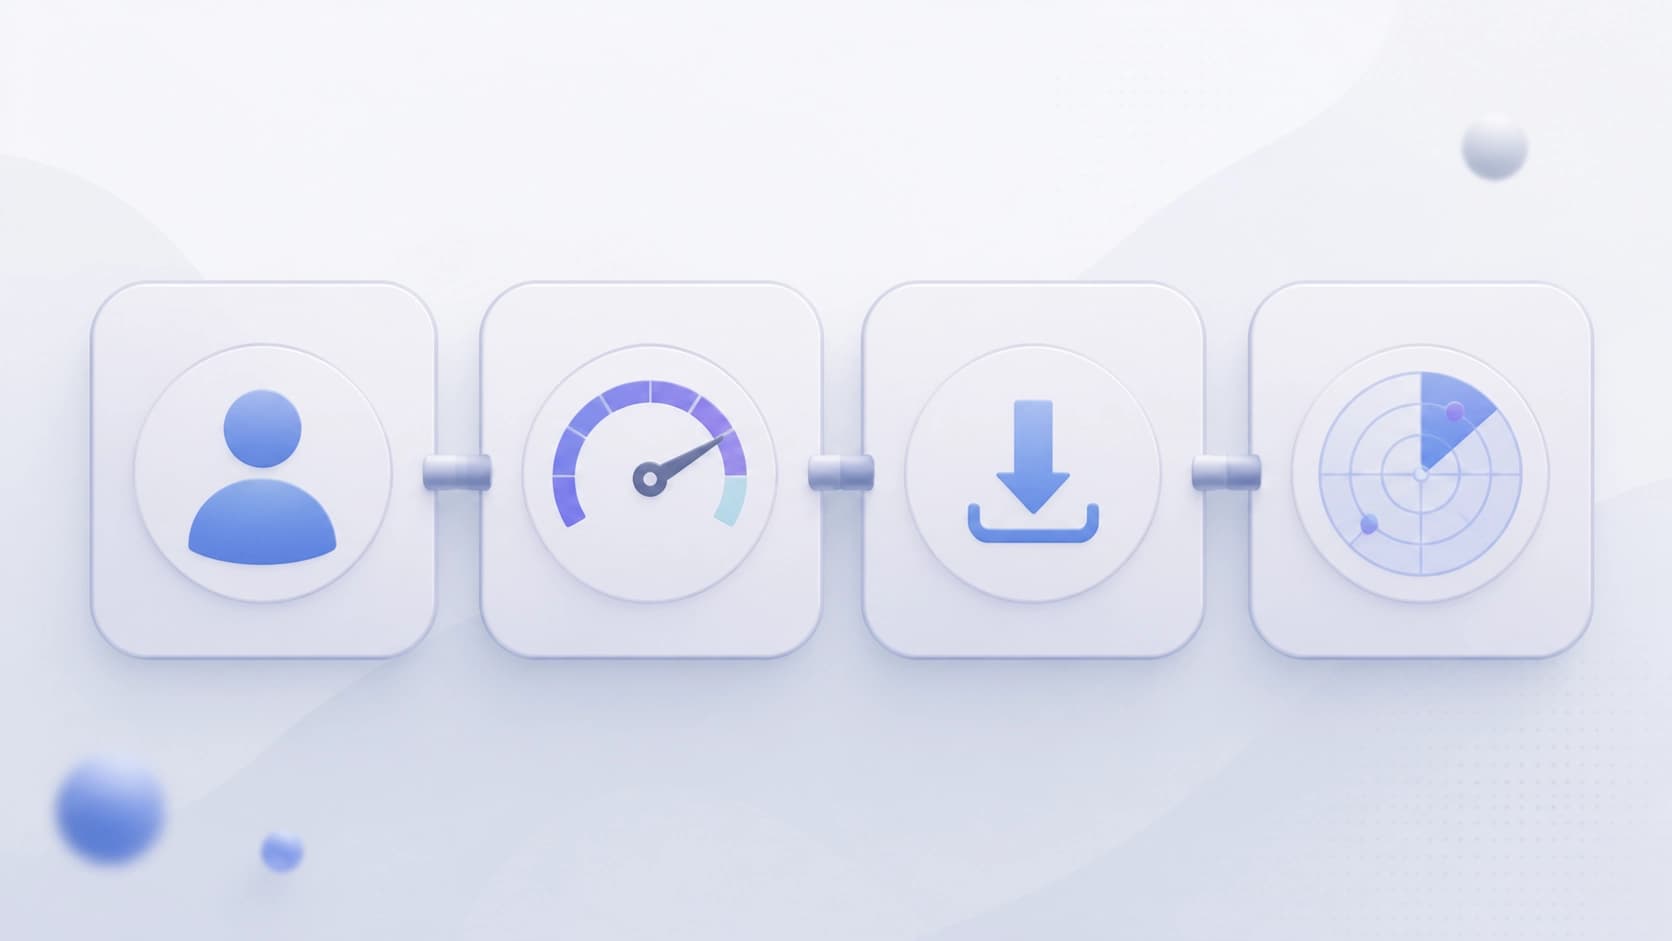
أربع كتل أساسية
- نماذج المستخدمين وفق Big Five. تُعرَّف الشخصيات وفق نموذج العوامل الخمسة (المعروف أيضًا بـ OCEAN)، وهي لا تعمل في فراغ: لكل مستخدم حالته الخاصة ومجموعته الخاصة من الأدوات المتاحة، وهذه الحالات تتغير على مدار الحوار.
- مقياس الاتساق pass^k. هذا ليس مجرد «كم مرة نجح الأمر». فإلى جانبه تصنيف بنيوي للأعطال، ومنح جزئي للنقاط عن تقدم ناقص لكن ذي معنى، وفحص مزدوج لتسليم التحكم — أي التحقق بشكل منفصل مما إذا كان الوكيل قد سلّم الدور إلى الإنسان أو نظام آخر بشكل صحيح.
- تصدير البيانات للتدريب الإضافي. يستطيع المحاكي تصدير الدورات المتراكمة، مع استبعاد الضعيفة منها وفق التقييم، مباشرةً بست صيغ صالحة للضبط الدقيق.
- محلل المخاطر التنافسي (Risk Analyser). تأخذ هذه الوحدة بصمات من «أعمدة» الحالات الوسيطة التي يجب على الوكيل المرور بها، ثم تفرّع الدورات بطريقة مونت كارلو عبر أربعة أنواع من الاضطرابات المرتبطة بمهمة محددة. وتُحسب المخاطر النهائية عبر نسبة ΔP / ΔT، ودمج الأدلة وفق Dempster—Shafer، وإسناد فئات الهجمات وفق Shapley.
لاحظ المنطق: الكتل الثلاث الأولى تتعلق بالقياس والتدريب، والرابعة بالتنبؤ بالأعطال. فالإطار مبني منذ البداية كأداة ليس للتشخيص فحسب، بل لاختبار الإجهاد أيضًا.
ثلاث دورات: من التحليلات إلى الهجوم التنافسي
يتكون الجزء التجريبي من ثلاثة أجزاء بدرجات متفاوتة من «الحمل».
- وكيل تحليلي حواري شُغِّل ضد عشر شخصيات OCEAN. ولوسم الجودة جُمعت 240 تقييمًا تحكيميًا.
- وكيل دعم العملاء اختُبر على خمس مهام، كل منها بأربعة أنماط للشخصية.
- اختبار إجهاد تنافسي للمهام الخمس نفسها: أُضيفت هنا اضطرابات لرؤية مدى سرعة انهيار المسارات.
كانت الدورة الثالثة الأكثر دلالة. فحتى في غياب الاضطرابات، بلغ الحد الأدنى لاستقرار المسار V_min = 0.375 — أي أن الظروف «النظيفة» نفسها لا توفر هامش أمان. وعندما شُغِّلت الهجمات، اتضح أن أخطر الضربات ليست على محتوى الاستعلام، بل على الأدوات والبنية التحتية: فإسناد Shapley يمنح المستوى النظامي نحو 46%، ومستوى الإجراءات نحو 38%.
هذا تحوّل مهم في التركيز. فالنقاش حول أمان الوكلاء غالبًا ما يختزل في حقن الأوامر في النص، بينما تقول الأرقام إن الخطر الأساسي يكمن في الطبقة المسؤولة عن استدعاءات الأدوات وحالتها.
الشخصية كمصدر للتباين
الأكثر إثارة في الورقة ليس التقييمات المطلقة، بل التباين بين الشخصيات. ففي المهمة نفسها اختلف معدل النجاح اختلافًا جذريًا: 50% مقابل 100%. هذا ليس ضجيج قياس، بل إشارة إلى أن الوكيل يتعامل بشكل مختلف مع أنماط تواصل مختلفة.
وقد أُدرجت بشكل منفصل أنماط الفشل التي لا يُظهرها الاختبار الموحّد إطلاقًا:
- تسريبات عبر النطاقات — عندما يتسرب سياق مهمة إلى أخرى؛
- انجراف سياقي — تحوّل تدريجي في الموضوع والأهداف على مدار حوار طويل؛
- فجوة في الجودة بين الشخصيات بمقدار 0.27 نقطة.
يشدد المؤلفون على أن Risk Analyser قادر على قياس الهشاشة على مستوى المسار — حيث يعجز المقياس الفردي pass^k، لأنه يسجل فقط حقيقة النجاح أو الفشل ولا يميّز بين «انهار في الخطوة الأولى» و«وصل إلى ما يقارب النهاية لكنه لم يحافظ على الحالة».
فيمَ يفيد هذا عمليًا
إذا نظرنا إلى الاستنتاجات كوصفة، فهي تبدو هكذا: اختبر الوكيل ليس على مستخدم «متوسط» واحد، بل على مجموعة من الشخصيات، وانظر إلى التباين بينها، لا إلى المتوسط. فقد يكون متوسط الدرجات مقبولًا تمامًا، بينما يفشل نصف الشخصيات في السيناريو بشكل ثابت.
الطبقة العملية الثانية هي البيانات. فبما أن المحاكي قادر على وسم الدورات الناجحة والفاشلة وتصديرها بصيغ جاهزة، تصبح الشخصيات ليس اختبارًا فحسب، بل مصدرًا لمواد التدريب أيضًا. والضعف هنا واضح: جودة هذه المجموعة تعتمد كليًا على جودة الوسم، والتقييمات التحكيمية هي أغلى وأكثر أجزاء العملية ذاتية.
وأخيرًا، الطبقة الثالثة هي أولويات الحماية. فبما أن الحصة الأساسية من المخاطر تقع على المستوى النظامي والإجراءات، لا على الصياغات، فإن ما يجب تعزيزه أولًا هو صلاحيات الوصول، والتحقق من الاستدعاءات، وصحة تسليم التحكم، لا مجرد مرشحات على النص المُدخل.
ما يجدر أخذه في الحسبان
يجدر تذكر النطاق: الحديث يدور عن ثلاث مجموعات تجريبية، وعشر شخصيات في إحداها، وخمس مهام في المجموعتين الأخريين. أرقام مثل 50% مقابل 100% تبدو مثيرة، لكنها مبنية على عينة صغيرة — وهي أقرب إلى إشارة على الاتجاه من حكم نهائي. علاوة على ذلك، فإن محاكاة المستخدم وفق Big Five تجعل الشخصية الحقيقية أكثر خشونة حتمًا: فالإنسان الحقيقي غير متسق، بينما الشخصية في المحاكي تتبع الملف المحدد لها.
ومع ذلك، تبدو الفكرة المنهجية متينة وقابلة للنقل. فموثوقية الوكيل ليست رقمًا واحدًا، بل توزيع عبر أنواع المحاورين وأنواع الأعطال. ويخطو محاكي AgentWorld خطوة جدية أولى نحو جعل هذا التوزيع قابلًا للقياس، لا للتخمين.
ظهرت النسخة v1 من الورقة في 25 أغسطس 2026، والنسخة الحالية v2 بتاريخ 26 أغسطس 2026 (الحجم 1,710 KB)؛ DOI — 10.48550/arXiv.2608.24076، التصنيف — cs.AI.


