
Zero2Repo 基准测试:从空目录自主构建项目的极限
研究建议在完整的仓库构建任务中评估编码智能体:输入包括规格说明、接口契约和空白环境,评估则通过隐藏测试进行,不使用 LLM 评判。即使是领先的智能体,也很少能通过所有检查;大多数失败都源于遗漏了个别需求项。
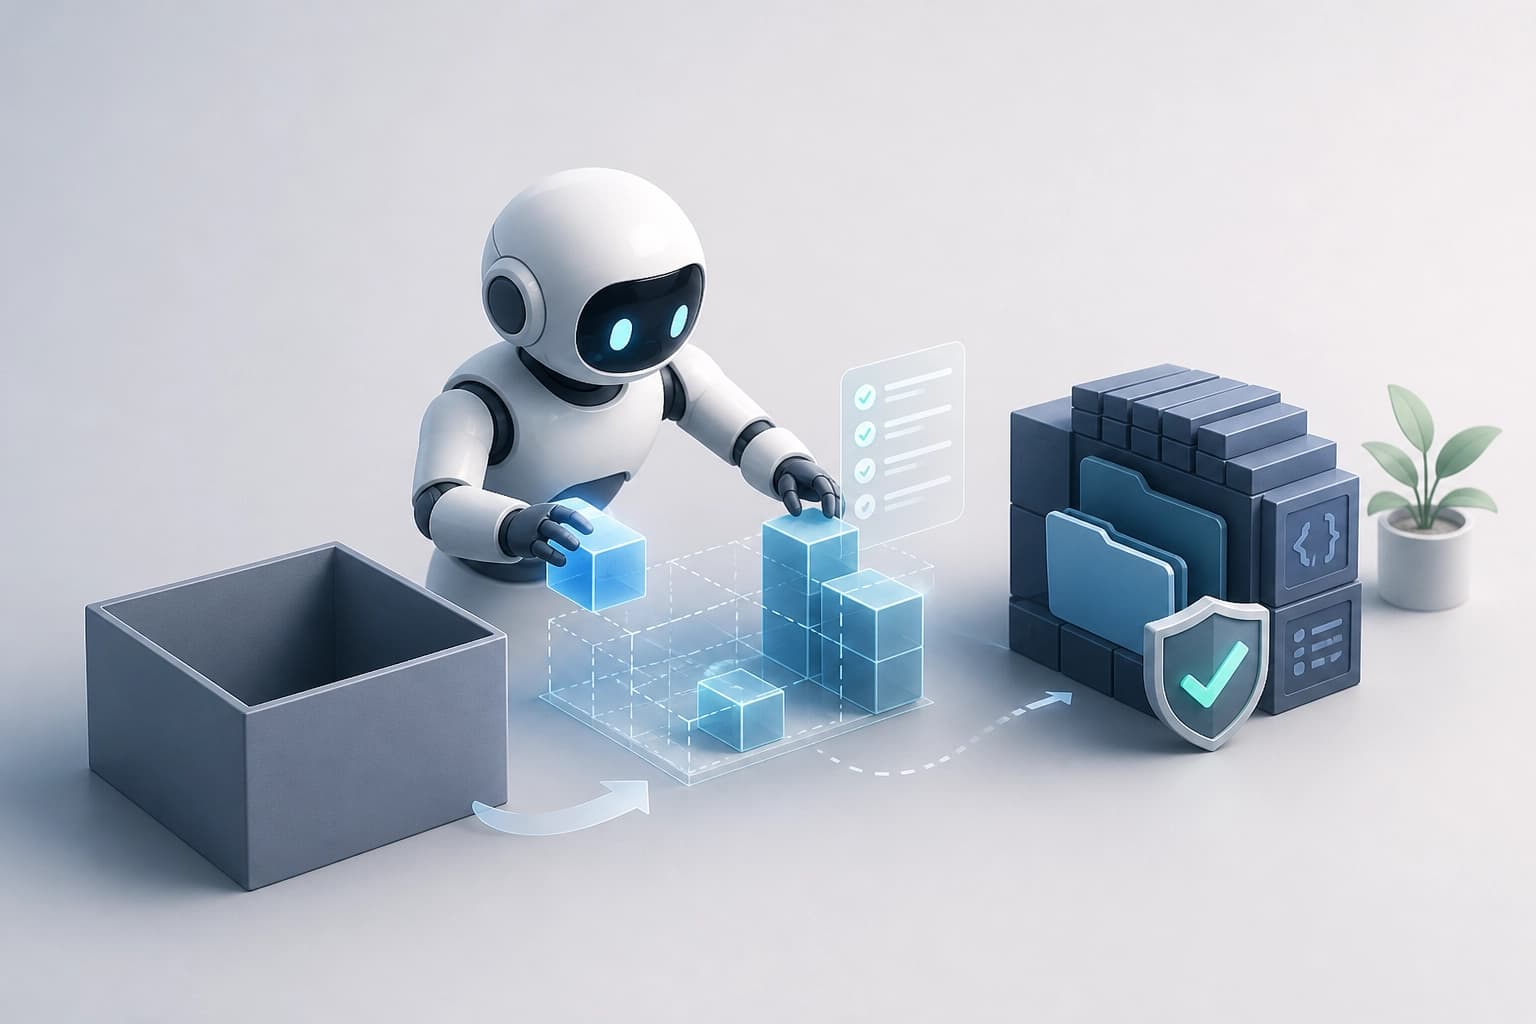
Zero2Repo 检测什么
该基准测试评估编码智能体能否从零开始创建一个代码仓库。智能体会收到一份产品需求文档、一份接口契约和一个空的工作区。智能体必须在适合项目的原生生态系统中提供完整的代码仓库。
测试涵盖整个项目的构建过程。评估依据是最终完成的代码仓库。
- 输入:产品需求文档、接口契约、空的工作区。
- 输出:在适合项目的原生生态系统中的完整代码仓库。
- 评估内容:从零开始创建代码仓库的能力。
结论:该基准测试检验的是从空目录自主构建项目。实用标准:将其用于评估智能体完成整个项目构建任务的能力。
任务如何生成
该流程以与编程语言无关的方式创建任务。它选取真实的开源项目及其固定版本。然后将这些项目转换为行为规范、可复现的环境和隐藏的验收测试。
步骤:
- 选取真实的开源项目及其固定版本。
- 将项目转换为行为规范。
- 准备可复现的环境。
- 构建隐藏的验收测试。
验证:
- 源项目的参考实现能够通过测试。
- 对抗性验证确认测试会拒绝不正确的实现。
结论:任务以参考实现和通过对抗性验证的测试为基础。实用标准:检查测试是否经过验证,而不仅仅是查看任务描述。
如何评估智能体
该基准测试在隔离容器中评估用于生产环境的编码智能体。在明确提交解决方案之前,验收测试始终处于隐藏状态。奖励是二元的:只有通过所有测试才会获得奖励。该基准测试不使用 LLM 评判器。
标准:
- 为智能体提供隔离容器。
- 在提交解决方案之前隐藏测试。
- 通过所有测试才能获得二元奖励。
- 不使用 LLM 评判器。
结论:部分通过测试不会获得奖励。实用标准:若要比较智能体,应采用只有通过全部隐藏测试才能取得成功的评估方式。
当前版本的语言与覆盖范围
该流程和测试系统不限定特定编程语言。当前版本包含 Python、TypeScript、Go 和 C++ 任务。
版本构成:
- Python。
- TypeScript。
- Go。
- C++。
结论:该基准测试不局限于一种语言,但当前任务集仅涵盖四种语言。实用标准:将项目所用语言与当前版本的语言范围进行比较。
从结果中可见的局限
这些局限体现在由 11 个任务构成的任务集上。这些任务来自一些代码仓库,前沿模型很可能在训练期间接触过它们。
结果显示:
- 表现最强的智能体解决了 11 个任务中的 10 个。
- 每个失败的提交都通过了 90-99% 的隐藏测试。
- 两个最强智能体有 67-100% 的失败测试与遗漏一项内容或规范中的罕见规则有关。
- 失败源于对规范遵循得不够准确,而非缺少某个子系统。
- 作者将每一类此类失败都视为明确的改进目标。
结论:自主构建的局限体现在对规范中罕见规则和完整性的把握上。实用标准:检查智能体能否把握规范中的罕见规则,而不仅仅是能否构建子系统。
常问问题
相关材料
所有材料
FedSocket:多模态异构环境下可交换模型须确保接收方可执行
提出了 FedSocket:一种要求交换的模型必须能在接收方一侧计算的方法,并通过统一的预测接口 Q 连接异构的私有模型。文章介绍了基于成员归属的聚合、仅转发 Q 的参数及计数器,并在六个数据集上进行了实验,展示了在模态缺失时准确率的提升,以及 Joint 推理相较于独立集成的优势。
13 十一月 2026
CyberArena:AI 智能体对战揭示静态网络安全基准测试的局限性
该基准测试将两个智能体置于服务持续变化的沙盒中,并在多轮对战后将它们的行动汇总为进攻和防御能力的多维评分。在 466 场比赛、12 个现代模型的测试中,它能够区分单边测试达到上限时难以辨别的能力,包括多步规划和后门创建。
13 十一月 2026
检测器对改写后机器文本的鲁棒性:测试揭示了什么
本文汇总了对可将生成内容片段改写得更自然的工具进行测试的结果。经过处理后,内容被检测出的概率明显降低,而仍然存在的误报意味着不能将检测器的判定视为证据。
13 十一月 2026