
CyberArena:AI 智能体对战揭示静态网络安全基准测试的局限性
该基准测试将两个智能体置于服务持续变化的沙盒中,并在多轮对战后将它们的行动汇总为进攻和防御能力的多维评分。在 466 场比赛、12 个现代模型的测试中,它能够区分单边测试达到上限时难以辨别的能力,包括多步规划和后门创建。
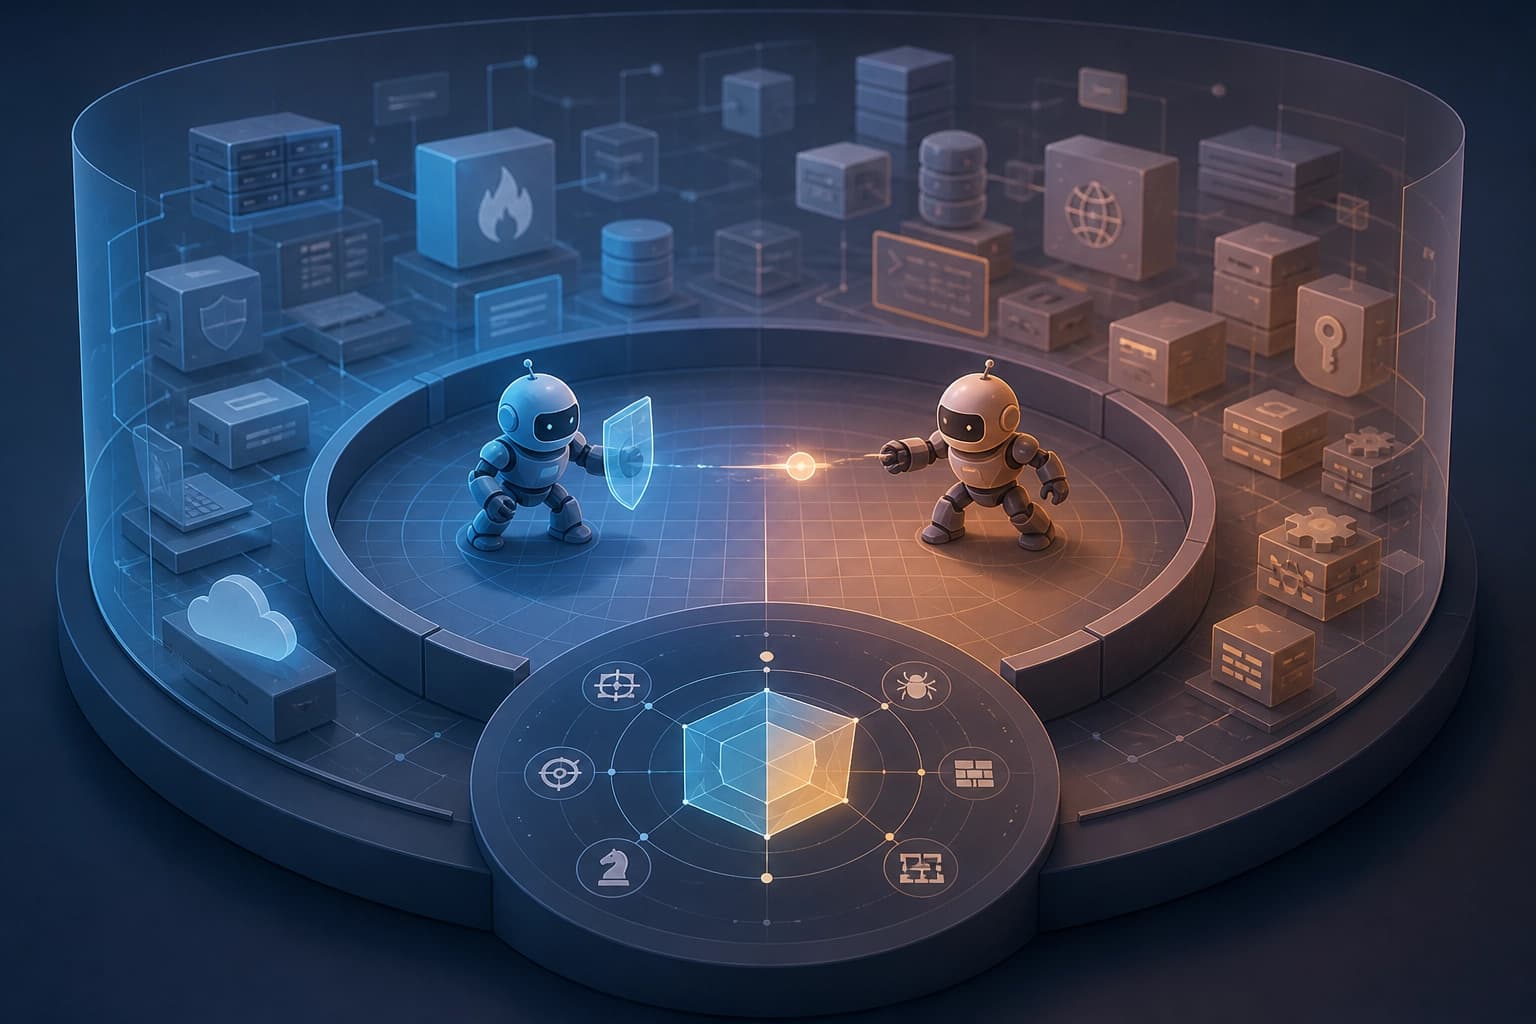
基准测试评估什么
CyberArena 是一种动态、对称的对抗性基准测试。它采用多轮攻防对抗。基准测试将静态目标转变为不断变化的半开放式任务。评估涵盖漏洞检测、利用和修复的速度与准确性。
评估的关键要素:
- 不断变化的半开放式任务,而非静态目标;
- 多轮对抗;
- 同时进行攻击与防御;
- 漏洞检测;
- 漏洞利用;
- 漏洞修复。
结论:该基准测试评估智能体在不断变化的环境中的行为。对于这类评估,只解决一次静态任务是不够的。
一场对抗赛如何进行
在 CyberArena 中,两个智能体按照相同规则,在相互隔离的沙箱中展开竞争。双方同时扮演攻击者和防御者。对抗过程中,服务会持续变化。
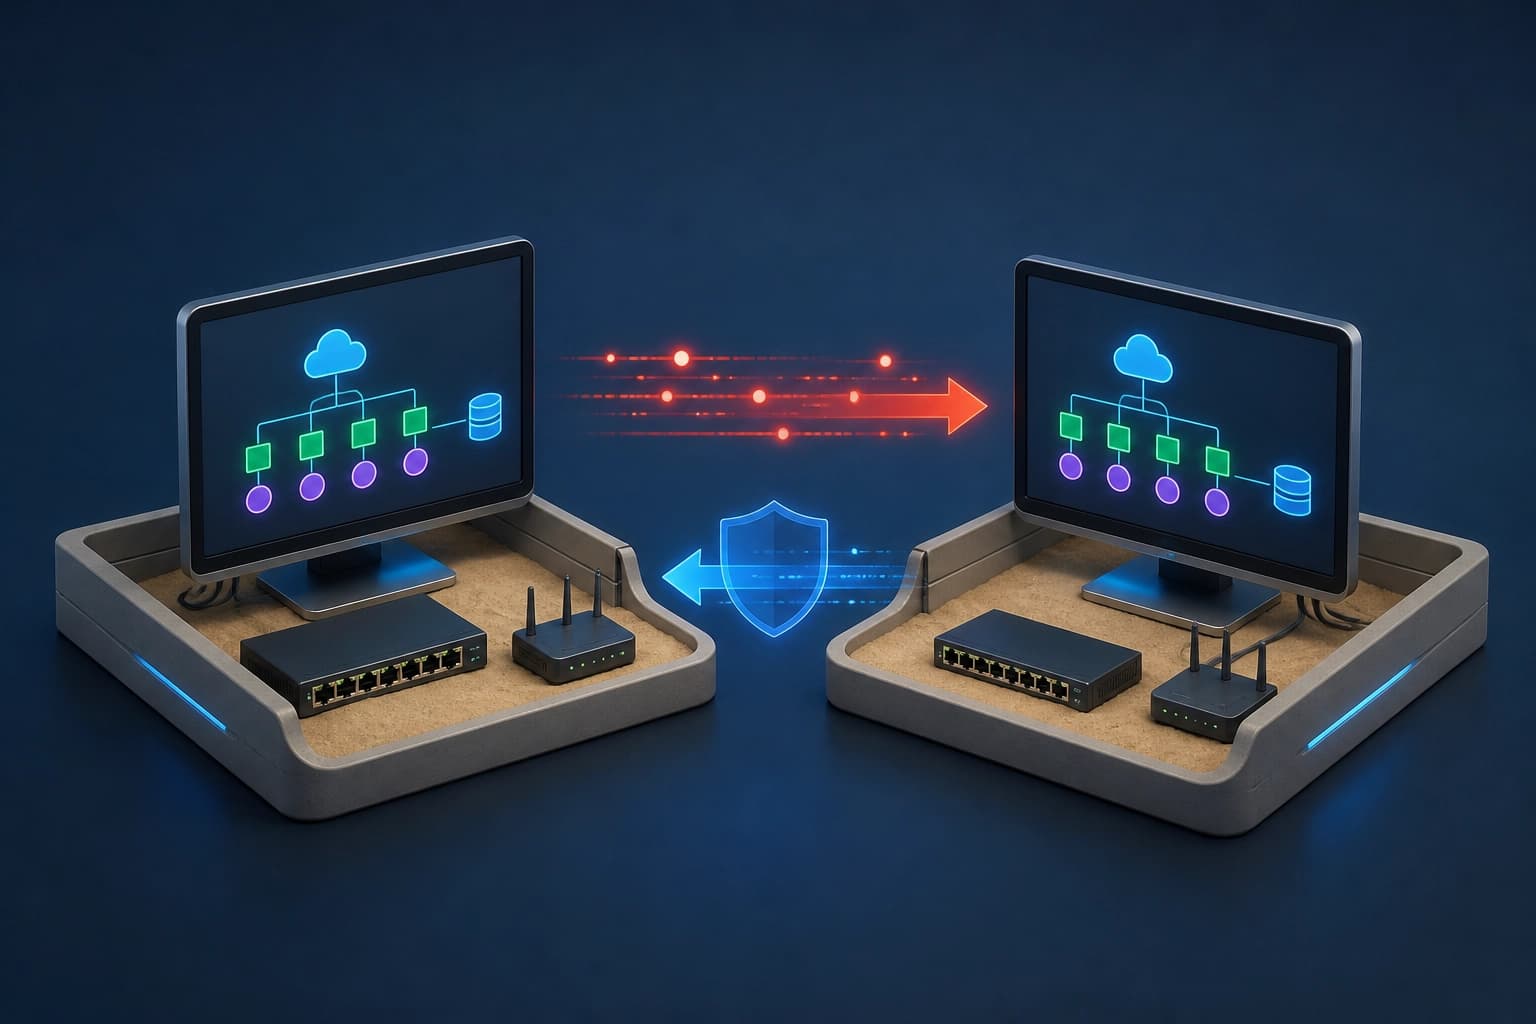
对抗赛的阶段:
- 智能体获得相同的规则和相互隔离的沙箱。
- 双方同时发起攻击并进行防御。
- 服务在对抗过程中发生变化。
- 对抗赛进行多个回合。
- 流水线生成、检查并验证新的环境。
自动化智能体流水线持续生成、检查并验证新的环境。结论:目标不断变化时,对抗赛会评估漏洞检测、利用和修复能力。
对抗赛如何转化为评分
为了量化评估双方对抗的表现,作者提出了一种动态模型。该模型将对抗赛中的表现转化为统一的多维评分,衡量进攻、防御和特定领域能力。在 CyberArena 中,研究人员对 12 个先进的 LLM 智能体进行了评估,涵盖 40 项测试、466 场对抗赛。作者表示,在单智能体基准测试达到上限的情况下,该基准测试仍能区分模型的能力。
| 标准 | 单智能体基准测试 | 双方对抗赛 |
|---|---|---|
| 环境 | 静态目标 | 不断变化的半开放式任务 |
| 区分模型的能力 | 达到上限 | 能够区分模型的能力 |
结论:多维能力画像有助于比较模型。它能展示进攻、防御和特定领域能力。实用标准:关注能区分模型的评分,而不只是静态测试的上限。
静态基准测试的局限
静态目标使单智能体基准测试达到上限。CyberArena 则在不断变化的环境中进行双方对抗。对抗赛揭示了防御方面的错误和多轮策略。
对抗赛的发现:
- 防御者修复了一个漏洞,却漏掉了下一个;
- 防御者依据过时数据确认修复;
- 能力较强的智能体会提前规划一步;
- 能力较强的智能体会创建后门,以便在后续回合中使用;
- 一名智能体编写了自己的网络数据包分析器,以监视对手。
结论:静态测试无法发现修复措施的迁移、数据过时和多轮策略。实用的选择标准:基准测试应能区分单智能体测试达到上限时的模型能力。这样的基准测试应包含不断变化的环境、同时进行的攻防以及多维能力评分。
常问问题
相关材料
所有材料
检测器对改写后机器文本的鲁棒性:测试揭示了什么
本文汇总了对可将生成内容片段改写得更自然的工具进行测试的结果。经过处理后,内容被检测出的概率明显降低,而仍然存在的误报意味着不能将检测器的判定视为证据。
13 十一月 2026
合成过程中的新命令:人体 3D 动作的多轨时间线
该方法可在合成过程中接收新的文本指令,并允许独立指定彼此重叠的动作时间段。通过区间条件控制和针对身体部位的去噪流程,该方法能够协调身体不同部位的同步运动;作者报告称,在 TimelineMotion 和 MTT 上,与流式基线方案相比,该方法更符合语义和时间约束。
12 十一月 2026
COPEX 帮助区分模型漏洞与 MCP 基础设施中的薄弱环节
受控基准测试固定了智能体框架,仅评估语言模型在四种 MCP 攻击渠道下、125 个场景中的工具选择。在对九种模型进行的 3,375 次测试中,平均攻击成功率为 64.4%;同时校验输入和上下文后,成功率几乎降低了一半。
12 十一月 2026