
检测器对改写后机器文本的鲁棒性:测试揭示了什么
本文汇总了对可将生成内容片段改写得更自然的工具进行测试的结果。经过处理后,内容被检测出的概率明显降低,而仍然存在的误报意味着不能将检测器的判定视为证据。
改写如何改变文本和检测器信号
经人性化处理的 AI 内容,是经过改写、听起来更自然的机器生成文本。工具会改变用词、句长和语气。有些工具还会加入不规则的节奏,或反复改写文本。这些变化会改变检测器所依赖的信号:用词的可预测性和句长的变化。
- 用词;
- 句长;
- 语气;
- 不规则的节奏;
- 反复改写。
结论:改写会改变检测器用来区分机器生成文本的那些特征。
改写文本测试的结果
测试考察了改写后检测器能否保持稳定。2025 年的一项研究涵盖了 19 种人性化处理和改写工具。
| 测试 | 结果 |
|---|---|
| 2025 年研究,19 种工具 | 许多检测器无法识别经过人性化处理的文本。 |
| Google Research | 改写模型保留了原意,并在很大程度上避开了检测。 |
| 使用 QuillBot 改写 ChatGPT 文本 | 检测器对 ChatGPT 文本的准确率降至 49%。 |
| 另一项测试 | ChatGPT 改写文本至少在一半情况下绕过了每一种检测器。 |
| Stanford,文学化语言 | 当要求 ChatGPT 使用更文学化的语言时,AI 文本识别率从 100% 降至 13%。 |
结论:检测器对改写后的机器生成文本的识别能力较弱。
检测器会捕捉文本中的哪些特征
检测器依赖的特征不一定与文本是否由机器生成有关。Carnegie Mellon 的研究人员发现,对于 GPTZero 和 Pangram 来说,基础模型的文本往往看起来像是人类写的;而经过微调以遵循指令的模型所生成的文本则不会。研究团队认为,检测器追踪的更可能是模型训练留下的痕迹,而不是机器写作的可靠标志。
- 基础模型:文本往往会被 GPTZero 和 Pangram 判定为像是人类写的;
- 经过微调以遵循指令的模型:文本不会被这样判定;
- 研究团队的结论:检测器追踪的是训练留下的痕迹。
Stanford 使用七种检测器测试了 91 篇由英语非母语者撰写的文章。平均误报率为 61.3%。至少一种工具标记了超过 91% 的文章。英语母语者撰写的文章,检测指标则接近于零。研究人员将这一差异归因于用词简单且可预测,而检测器会将其误认为机器生成文本。
结论:检测器信号不等于文本由机器生成,因此评估时需要结合上下文。
宣称的准确率与实际局限
独立测试和开发者自行测试得出的准确率各不相同。测试条件会影响结果。
- 独立测试综述:Turnitin、GPTZero 和 Originality.ai 的准确率为 70%–85%。这些工具仍然存在误报问题。
- Turnitin 声称准确率为 98%,误报率低于 1%。这一说法仅适用于 AI 生成文本占比超过 20% 的文档。
- OpenAI 于 2023 年 7 月关闭了自己的分类器。该分类器仅能识别出 26% 的 AI 生成文本。
- 2025 年研究的作者使用经过人性化处理的样本训练了一个模型。该模型能够识别经过人性化处理的文本,且误报率较低。面对试图欺骗模型的做法,它仍能保持有效。结果由模型作者自行得出;还需要独立测试。
结论:宣称的准确率取决于测试条件,而独立测试揭示了检测能力的局限。
如何实际评估检测器
专家建议将检测器的评估结果视为提示,而非证据。核查时可以参考草稿记录、提出简短的口头问题,并与课堂上完成的作业进行比较。专家建议作者和出版商索取来源、访谈记录和原始数据。
- 草稿记录;
- 简短的口头问题;
- 与课堂上完成的作业进行比较;
- 作者和出版商可索取来源、访谈记录和原始数据。
实用标准:检测器只能作为进一步核查的信号,而不能作为得出结论的唯一依据。
常问问题
相关材料
所有材料
FedSocket:多模态异构环境下可交换模型须确保接收方可执行
提出了 FedSocket:一种要求交换的模型必须能在接收方一侧计算的方法,并通过统一的预测接口 Q 连接异构的私有模型。文章介绍了基于成员归属的聚合、仅转发 Q 的参数及计数器,并在六个数据集上进行了实验,展示了在模态缺失时准确率的提升,以及 Joint 推理相较于独立集成的优势。
13 十一月 2026
CyberArena:AI 智能体对战揭示静态网络安全基准测试的局限性
该基准测试将两个智能体置于服务持续变化的沙盒中,并在多轮对战后将它们的行动汇总为进攻和防御能力的多维评分。在 466 场比赛、12 个现代模型的测试中,它能够区分单边测试达到上限时难以辨别的能力,包括多步规划和后门创建。
13 十一月 2026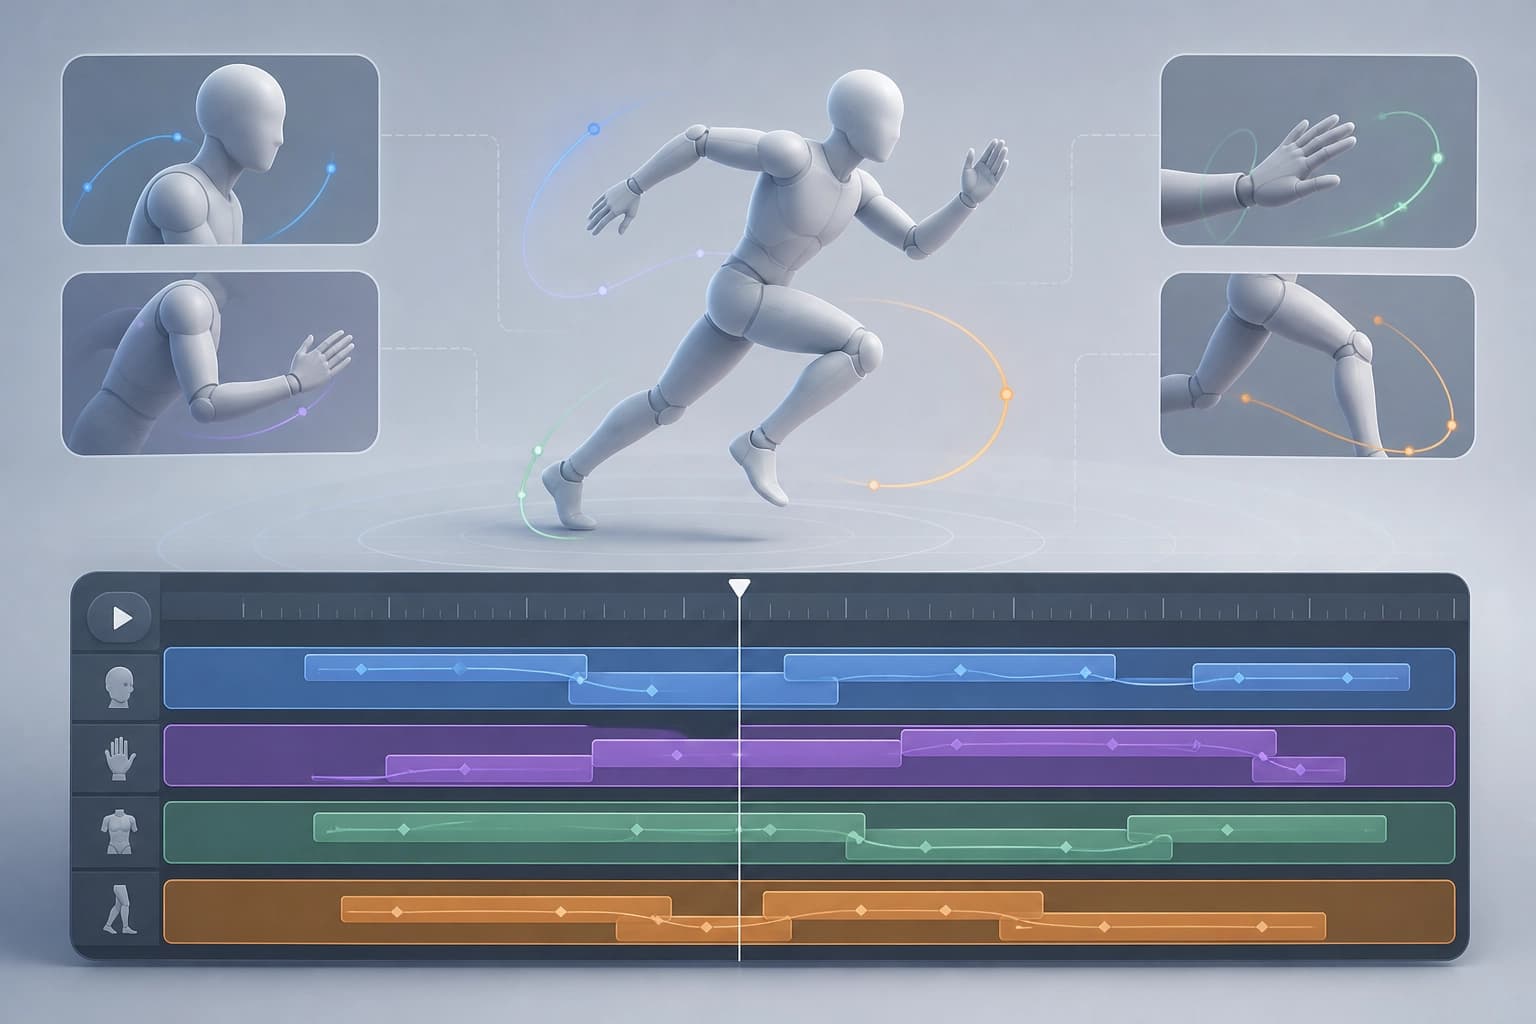
合成过程中的新命令:人体 3D 动作的多轨时间线
该方法可在合成过程中接收新的文本指令,并允许独立指定彼此重叠的动作时间段。通过区间条件控制和针对身体部位的去噪流程,该方法能够协调身体不同部位的同步运动;作者报告称,在 TimelineMotion 和 MTT 上,与流式基线方案相比,该方法更符合语义和时间约束。
12 十一月 2026