
问题:不同信号的过时速度各不相同
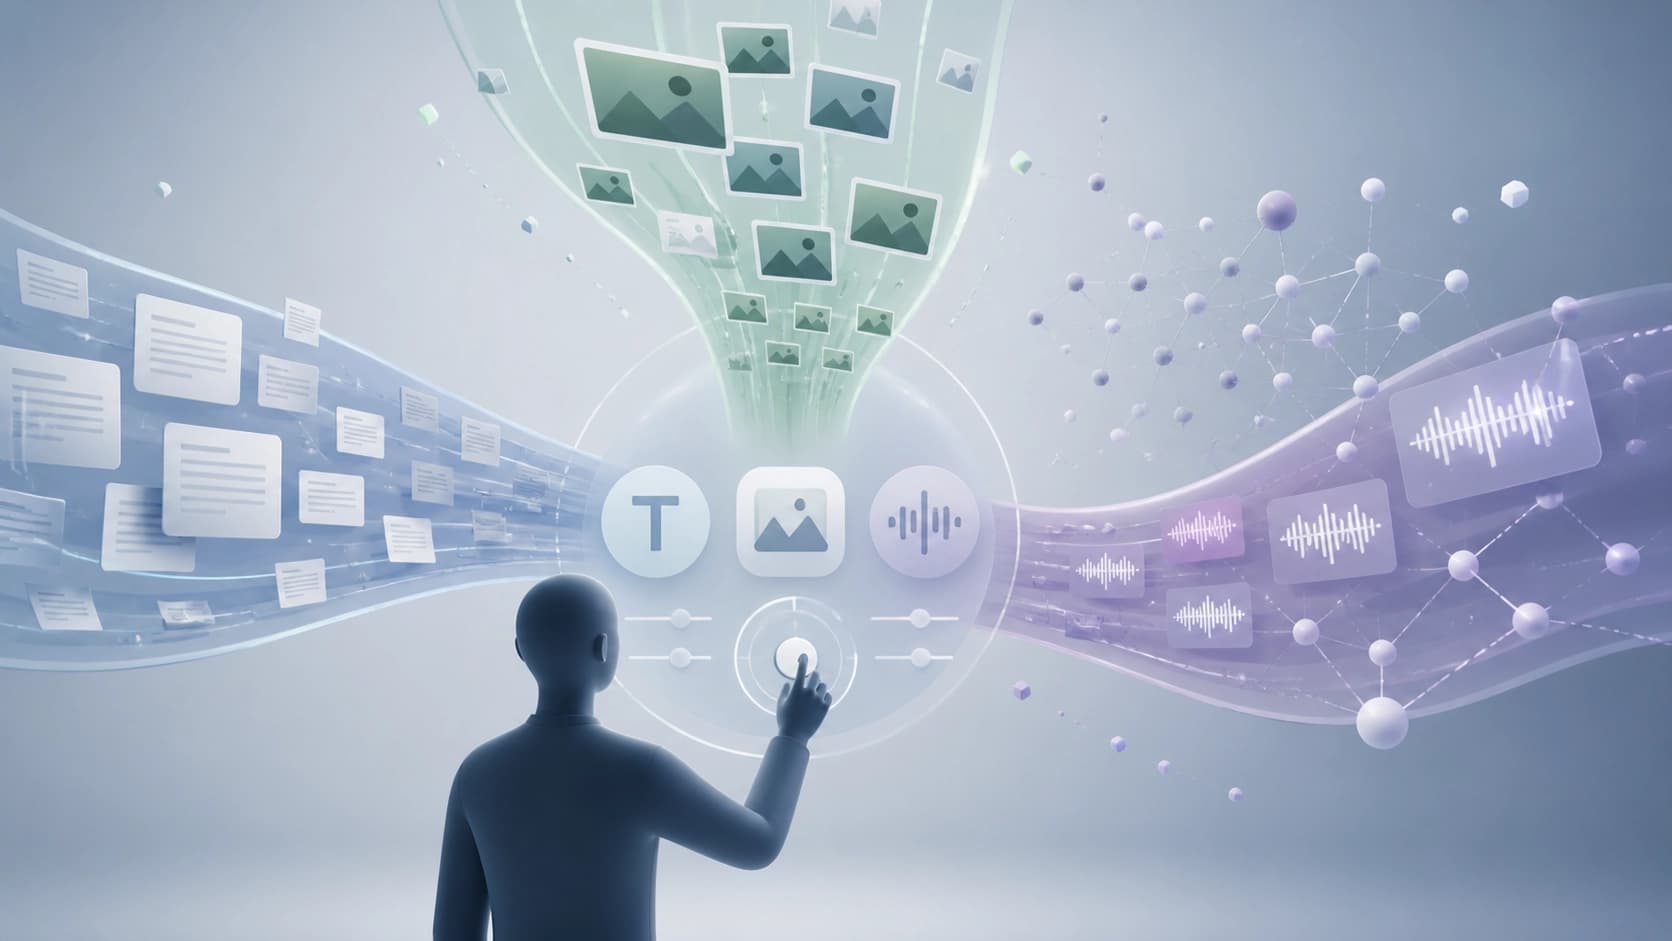
多模态推荐系统早已不再只依赖点击历史。它们会在“用户—物品”交互中混入物品本身的内容:描述、图片、声音。逻辑很简单——信息渠道越多,预测越准确。但实践中要复杂得多:每个渠道的贡献并非恒定,它会随时间变化,而且各自的变化速度也不相同。
论文 arXiv:2608.10983(Pengyu Zhang、Yangqin Jiang、Klim Zaporojets、Congfeng Cao、Paul Groth;第一版于 2026 年 8 月 11 日,第二版于 8 月 24 日)的作者将这一现象称为 modality time-scale mismatch——模态时间尺度失配。他们举的例子是:临近情人节时,人们在挑选巧克力时更少阅读配料表,而更多关注包装和卡片的音效。文本特征权重下降,视觉和音频特征权重上升。两周后,这一比例又会发生变化。
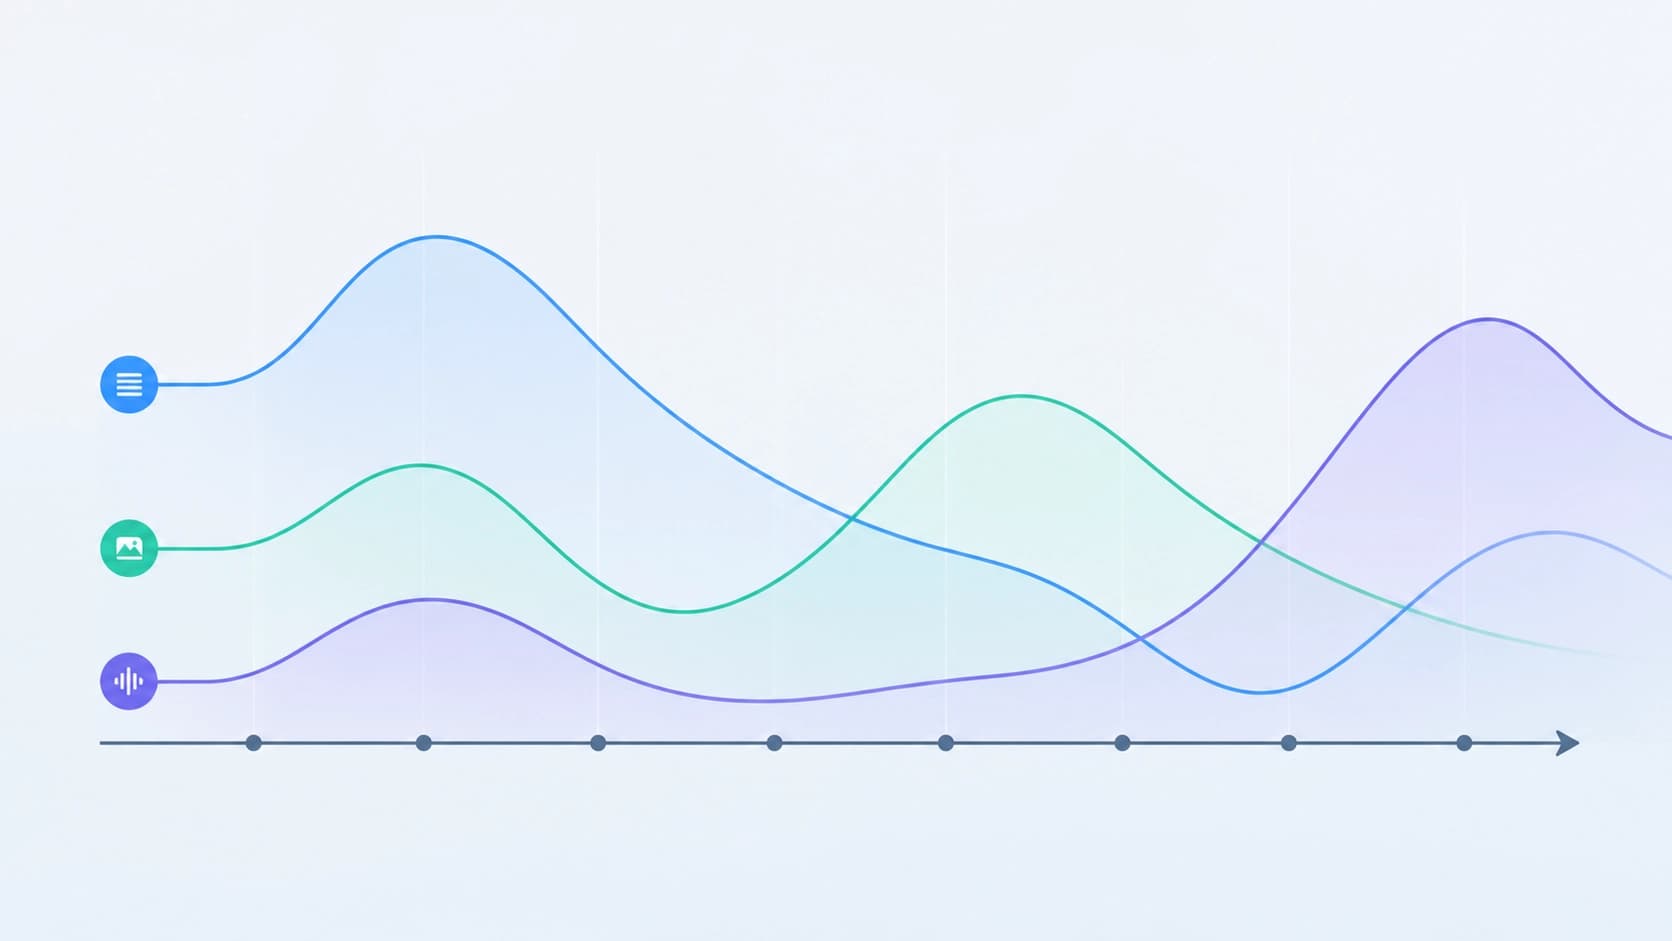
从这一观察中衍生出两个独立的问题。第一:人们的行为节奏各不相同,一个用户需要一种模态比例,另一个用户则需要完全不同的比例。第二,不那么显而易见:一个失去时效性的模态不只是不再有帮助——它还会主动造成危害,向模型注入过时且具有误导性的信号。
TimeRoute:面向具体用户的路由
这两个问题的解决方案被整合在同一个扩散架构中——TimeRoute。其核心在于摒弃多年来作为标准的通用融合系数:比如文本权重永远是 0.4,图片是 0.35,其余的都是零头。
用个性化分布取代通用权重
关键要素是时间模态路由器。它将具体用户的行为聚合为紧凑的时间画像,并将其转化为按模态划分的个性化权重分布。也就是说,“这里应该优先看什么”这个问题不是为整个系统全局决定,而是针对每个时间行为画像单独决定。
两个去噪视野
第二部分是图扩散重建器。同一个时间画像通过 Feature-wise Linear Modulation(FiLM)输入其中,而去噪被拆分为两个头流:长期和短期。缓慢的趋势和快速的爆发由不同分支处理,这一点至关重要——把它们混在同一个通道里,恰恰会丢失当初做这件事所要捕捉的那种区别。
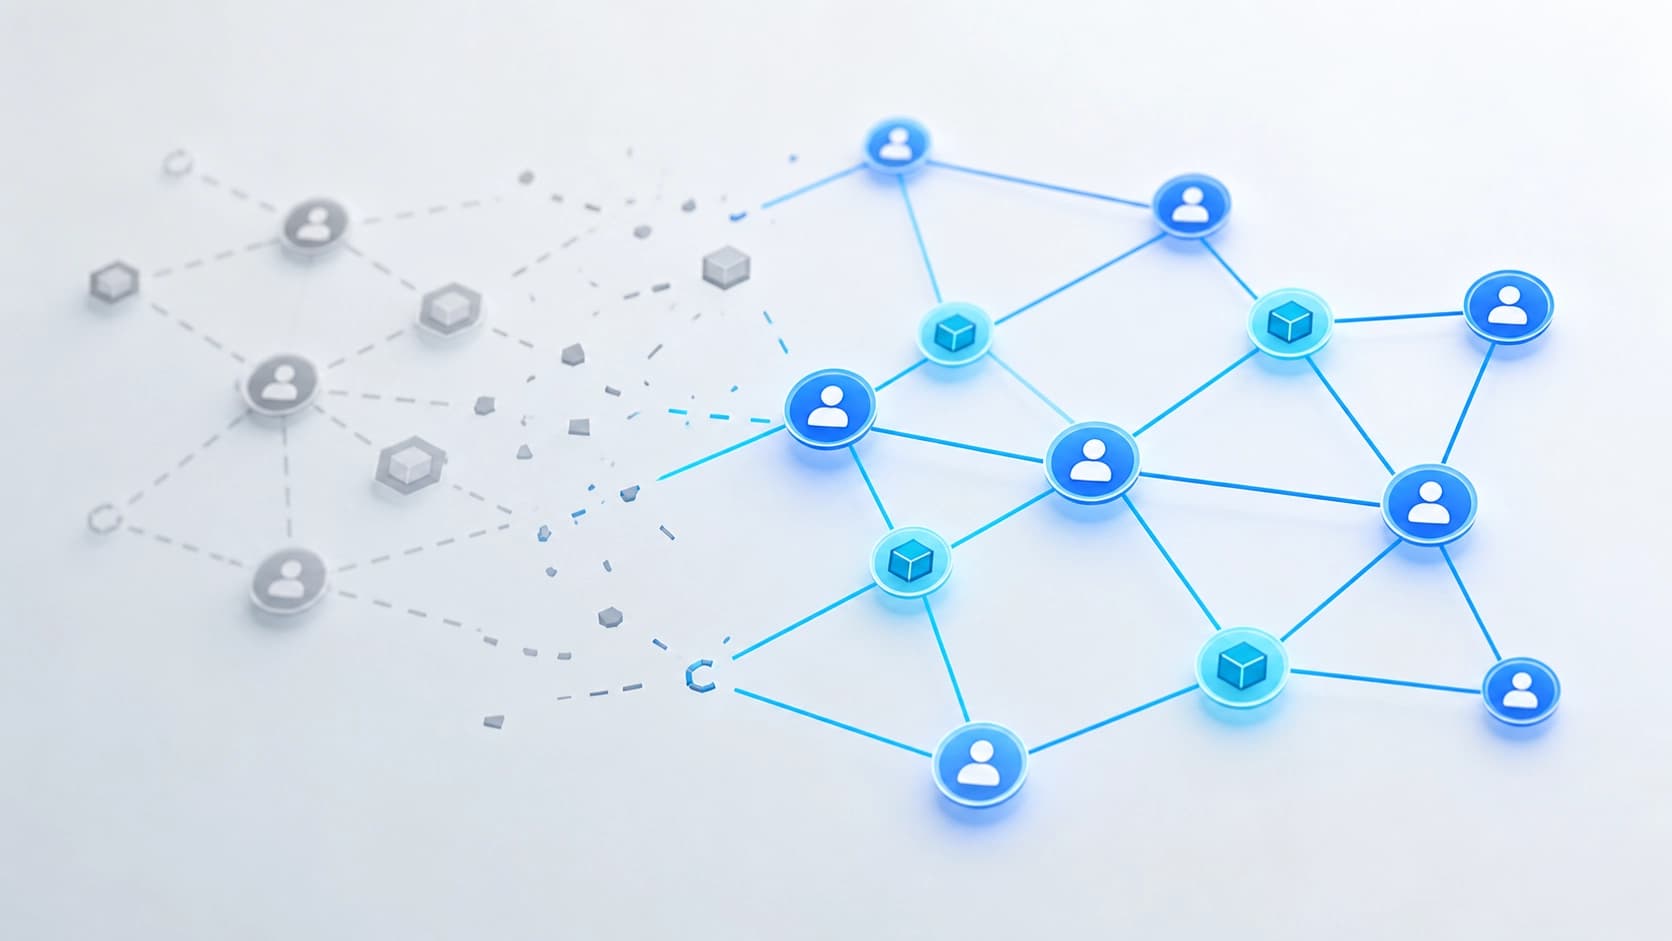
为什么这里需要扩散?它能够在模态边进入传播图之前就将其筛除。过时的连接不会被事后削弱——它根本不会被建立。这与对已构建好的图进行加权是根本不同的方法。
实验:三个数据集,十次运行
作者在三个数据集上验证了该系统——TikTok 短视频、Amazon-Baby 和 Amazon-Sports。每个结果都在十次随机初始化上取平均,这对推荐基准来说相当严格:这里不同运行之间的波动通常会吃掉一半的提升幅度。
相对于强基线模型的改进在 Recall@K、Precision@K 和 NDCG@K 上都很稳定。记录到的最显著结果是 Amazon-Baby 上 P@20 最高提升 9.8%。重要的是,这一提升不是一次性的,也不局限于单一指标:它体现在整套度量上。
Attribution:验证机制,而不只是数字
这项工作的另一部分是受控的 attribution 研究。这是试图回答一个常常被忽略的问题:究竟是什么带来了提升——是所提出的想法,还是架构中的偶然巧合?
结论相当严苛。提升需要同时具备新机制和时间输入。如果把同一个时间画像交给普通骨干网络,而不改变路由流程,就不会有收益。而如果给路由器输入随机噪声,结果不会比从模型中完全移除路由器更好。
简而言之,起作用的不是系统中存在时间数据这一事实本身,而是“画像 → 模态分布 → 可控去噪重建”这一具体组合。去掉任何一个要素——整个结构就会瓦解。
这在实践中意味着什么
这项工作的核心思想超出了推荐系统的范畴。多模态通常被理解为一种累积:增加一个数据来源——效果就更好。TimeRoute 提醒我们,这些来源之间是相互竞争的,它们的比例和模型中的任何权重一样,都是可调节的量。
第二个实践结论涉及过时问题。在推荐系统中,通常是在用户偏好层面应对旧信号——重新计算历史、遗忘久远的点击。而在这里,同一个问题被提升到了模态层面:过时的可能不是人的口味,而是整个信息渠道的相关性。而在进入图之前就应对它,比等垃圾已经扩散到整个结构之后再处理更合理。
第三点是分布的个性化。模态比例应当从具体个人的时间画像中推导出来,而不是为整个平台一次性设定——这一想法看起来具有可迁移性。同样的原则适用于多种异构信号交汇的地方:搜索、信息流排序、内容类型混合的目录。作者已开源代码,因此完全可以在自己的数据上验证这一方法。


