架构如何运作
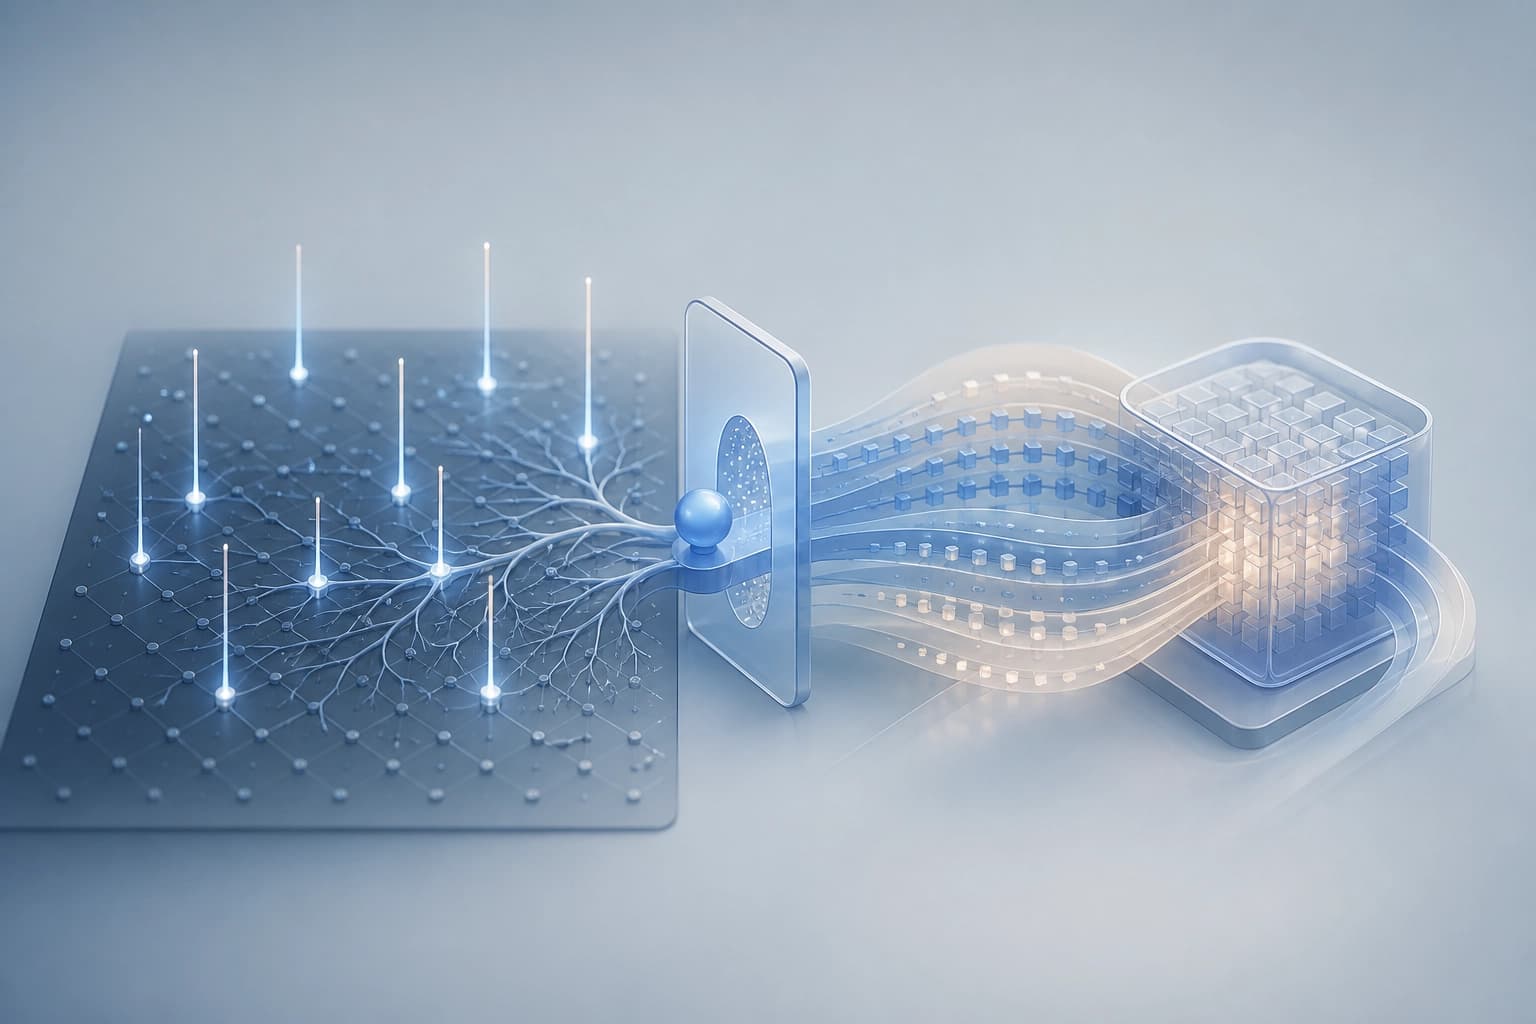
SymbolicLight V1 是一种采用双路径的语言模型:二元 Leaky Integrate-and-Fire (LIF) 动态和连续残差流。
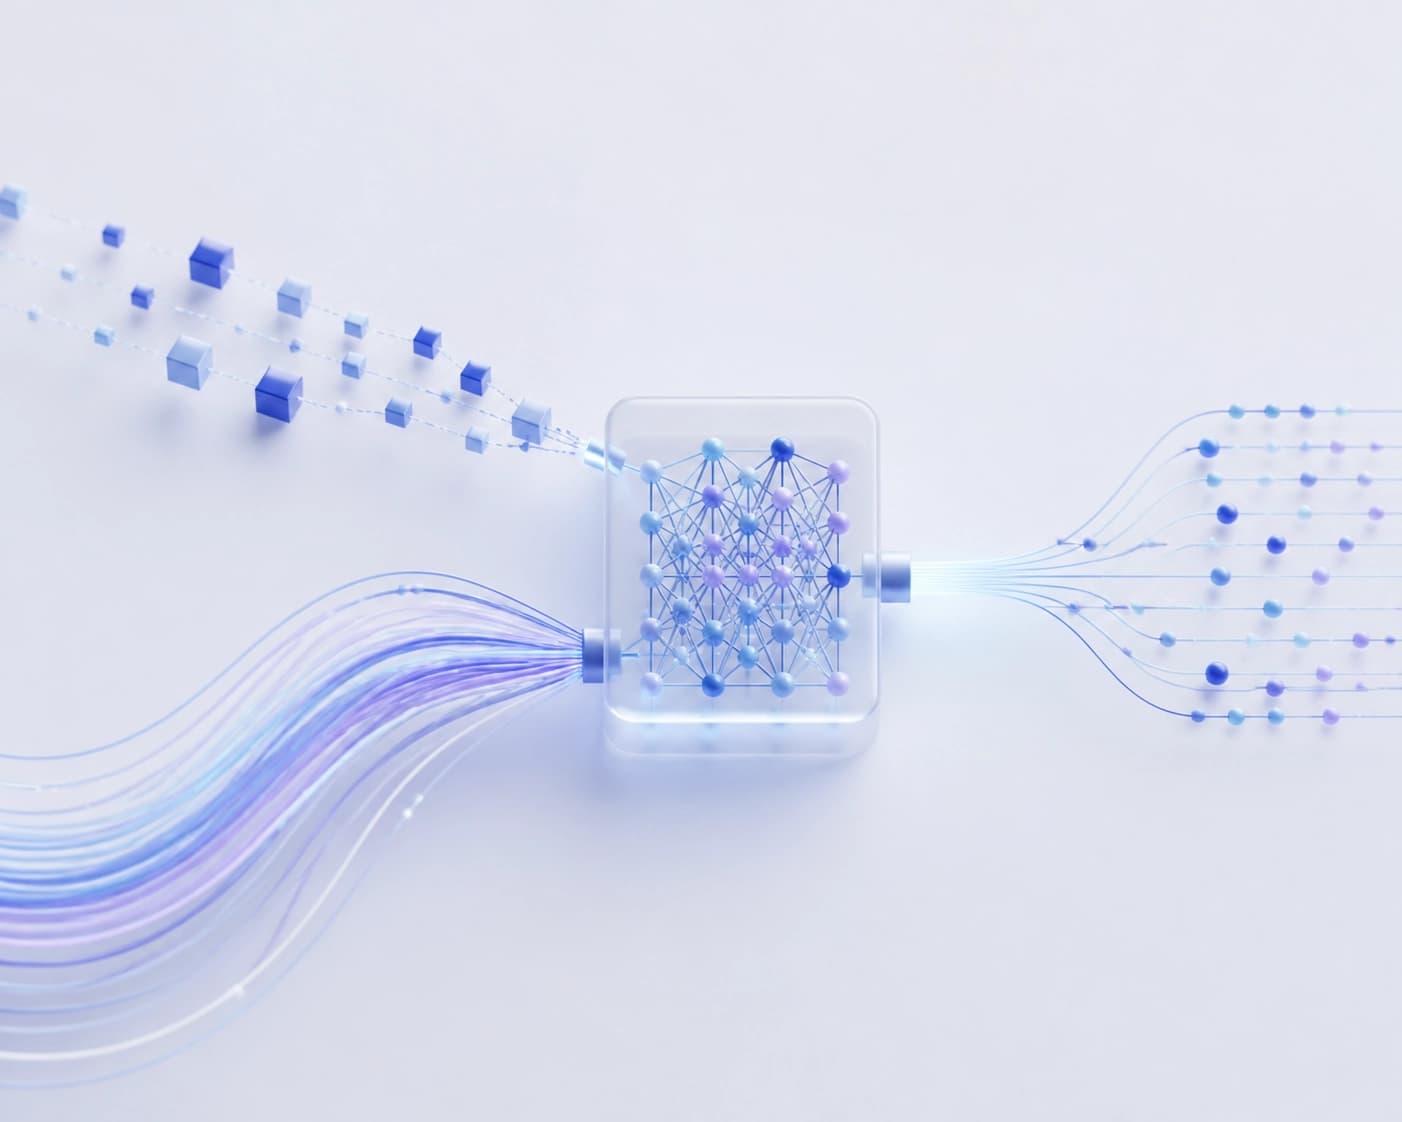
- Dual-Path SparseTCAM 混合器将一阶指数衰减状态与局部窗口注意力相结合。
- 两个组件都在连续残差流中运行。
- 混合器之后,模型使用上下文条件解码头。
实践标准:该架构值得用于研究稀疏脉冲动态与连续流的结合方式。架构本身并不能证明其在速度或准确率方面具有优势。
模型使用哪些数据进行训练和评估
四个 SymbolicLight V1 模型均从零开始训练,每个模型包含 194M 个参数。
- 训练语料包含 3B 个中文和英文 token。
- 语料涵盖 10 个领域。
- 在固定的 token 加权评估集上,PPL 为 8.88–8.93。平均值为 8.904,样本标准差为 0.019。
- 尚未验证评估集与训练数据流之间的划分情况。
代码 token 占评估集的 43.7%。十个领域的未加权平均 PPL 为 29.38。在编码器训练试验中,平均零脉冲比例为 89.96%;这并非整个模型的稀疏度评估。
实践标准:应结合评估集的组成和未经验证的数据划分情况来看待 PPL 结果。不能将零脉冲比例推广到整个模型。
模型与 GPT-2 的比较结果
在语料、分词器、token 预算和硬件相同的条件下,SymbolicLight V1 的 token 加权平均 PPL 比 GPT-2 201M 高 7.7%。
| 指标 | 结果 |
|---|---|
| PPL | SymbolicLight:平均值为 8.904;GPT-2 201M:8.27 |
| 零样本 | 在五个基准测试中,两款 200M 规模的模型在准确率方面没有明显差异 |
| 4-gram 重复 | 在 temperature 0.7 和 top-k 50 下,SymbolicLight 的重复更少 |
| 熵调制 | 该规则会使模型在重复方面的排名反转 |
实践标准:选择取决于所评估的指标。GPT-2 在 PPL 上占优,而重复情况的结果取决于生成规则。
速度和能耗测量结果
在 RTX 2080 Ti 上测量了 SymbolicLight V1 和 GPT-2 的生成速度。能耗估算依据生成后的功率读数得出,未对生成期间的功率进行积分。
| 模型 | 生成速度 | 能耗估算 |
|---|---|---|
| SymbolicLight V1 | 22.8 token/秒 | 约 2,848 mJ/token |
| GPT-2 | 91.5 token/秒 | 约 905 mJ/token |
在这些测量中,GPT-2 的生成速度更快,能耗估算也更低。能耗估算并非基于生成期间的功率积分。
实践标准:有关速度和能耗的比较,目前仅有这项在 RTX 2080 Ti 上进行的测量结果。