评估范围与边界
一家大型住房 marketplace 的支持系统每月处理数百万次对话。系统支持 11 种语言,标注的 P90 为 10 秒。这些指标描述了系统规模,但不能体现单个架构决策的效果。
| 参数 | 数值 |
|---|---|
| 规模 | 每月数百万次对话 |
| 语言 | 11 种 |
| P90 | 10 秒 |
迁移期间,prompts、alignment 和 serving 也发生了变化。因此,作者只将基于相同重放对话测得的效果归因于架构。
**评估标准:**在完全相同的输入对话上比较架构,而不是将迁移后的所有变化都归因于架构。
搜索、操作和生成如何划分
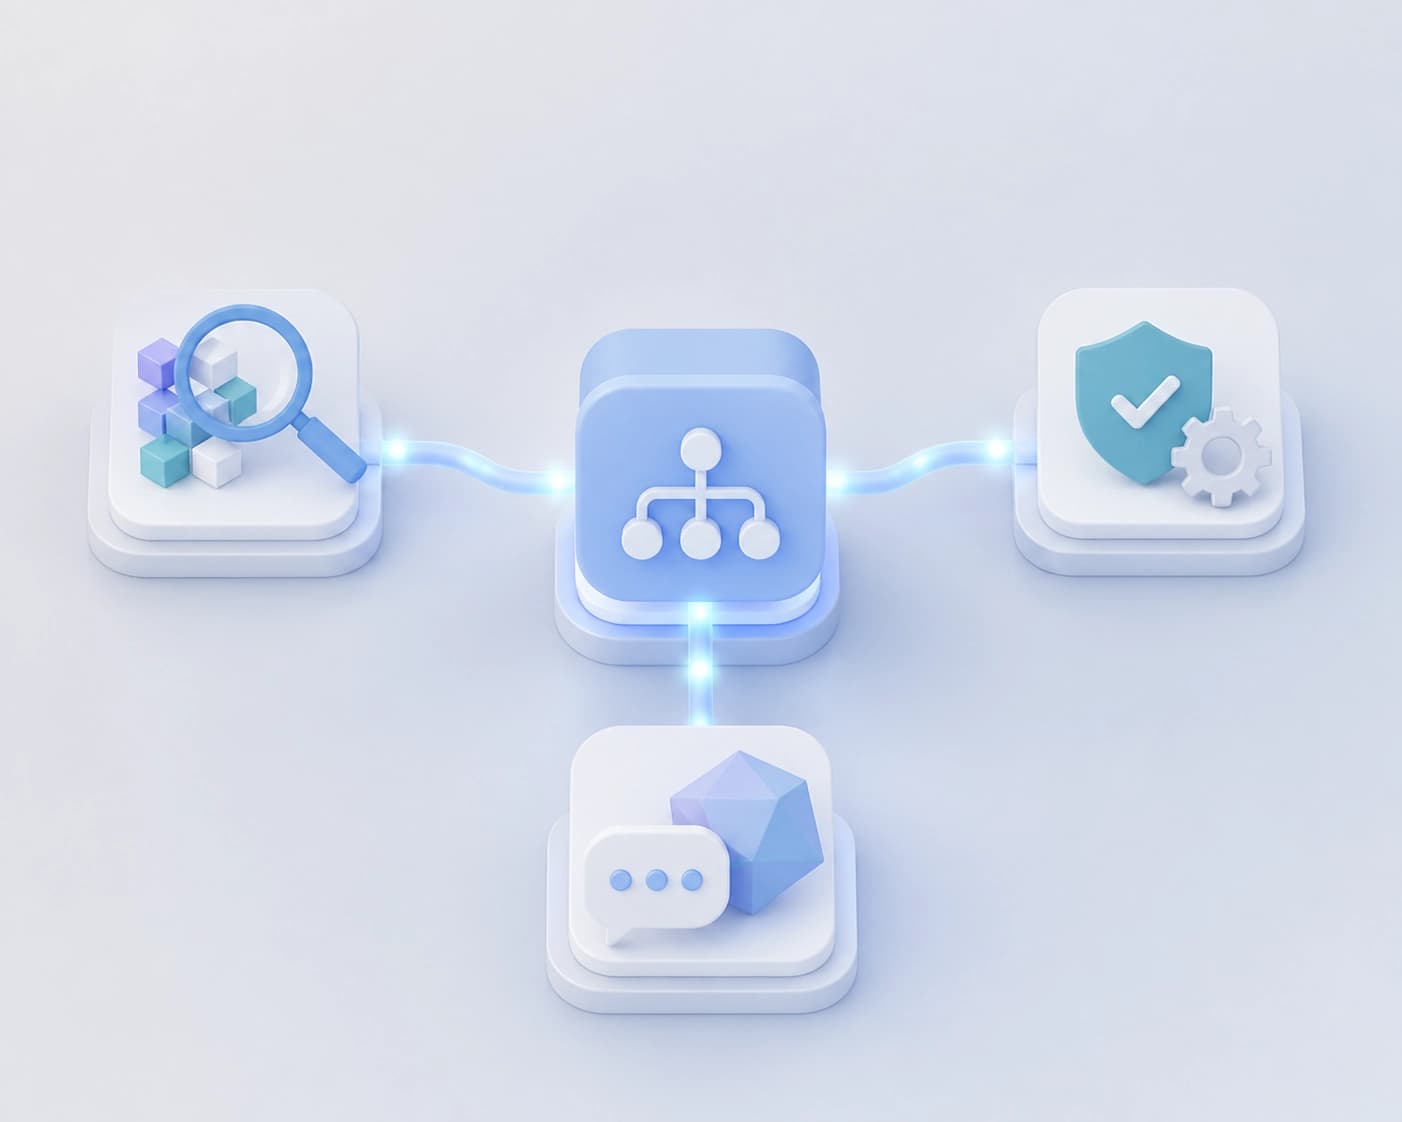
Dynamic Response (DR) 用一个受限的 ReAct 编排器取代混合式应答模型 Qwen3-235B-A22B,该编排器使用类型化工具和更小的生成器。生成器基于经后端系统验证的上下文契约构建回答。
| 系统部分 | 作用 |
|---|---|
| 搜索 | 类型化实体选择,包括预订选择 |
| 操作 | 类型化操作 ID 和归属校验 |
| 生成 | 基于经后端系统验证的上下文契约生成回答 |
| 编排 | 基于类型化工具的受限 ReAct 编排器 |
这种划分将实体选择和操作与回答措辞分离。**选择标准:**当系统需要可验证的操作,而不只是单一的回答生成器时,这种架构更合适。
实体和操作选择有哪些变化
类型化实体选择使预订选择器转向优先考虑准确率。准确率有所提高,而召回率有所下降。对类型化 ID 进行归属校验,消除了观察到的结构化操作错误。
| 指标 | 之前 | 之后 |
|---|---|---|
| 预订选择准确率 | 8,3% | 89,1% |
| 预订选择召回率 | 75,2% | 67,3% |
| 观察到的结构化操作幻觉 | 2,14% | 0,0% |
结果显示了选择准确率与召回率之间的权衡。**选择标准:**当避免错误选择比维持原有召回率更重要时,这种模式较为适用。
如何评估升级转人工和自助解决
低层级 A/B 测试在 replay 中复现了升级转人工率下降的结果。与此同时,production 中转接给人工客服的量大致保持稳定。
| 指标 | 之前 | 之后 |
|---|---|---|
| 硬性升级回答 | 5,60% | 3,08% |
| 软性升级回答 | 9,56% | 2,49% |
| 自助解决 | — | 趋势性变化:+5,1 个百分点;95% CI:−2 至 +12 |
升级转人工率下降,并未伴随转接给人工客服的量出现相应下降。作者将自助解决描述为趋势性结果,而非已明确证实的增长。
**评估标准:**分别跟踪升级回答、实际转接给人工客服的情况,以及自助解决。
serving 优化带来了什么
serving 优化将编排器的 P90 延迟从 3,87 秒降至 2,24 秒。同时,GPU footprint 减少了约三分之一。
| 指标 | 变化 |
|---|---|
| 编排器 P90 延迟 | 3,87 → 2,24 秒 |
| GPU footprint | 减少约三分之一 |
| 自托管模式下模型 serving 的预估年度成本 | 降低十倍以上 |
这些指标涉及 serving,而非实体或操作选择质量。**评估标准:**将延迟、计算资源占用和 serving 成本与回答指标分开考量。