
什么是 DSPA
DSPA(Dynamic SAE Steering for Preference Alignment,偏好对齐的动态 SAE 引导)是一种在推理阶段进行偏好对齐的方法。它不会更新基础模型的权重,而是利用偏好数据来引导生成。
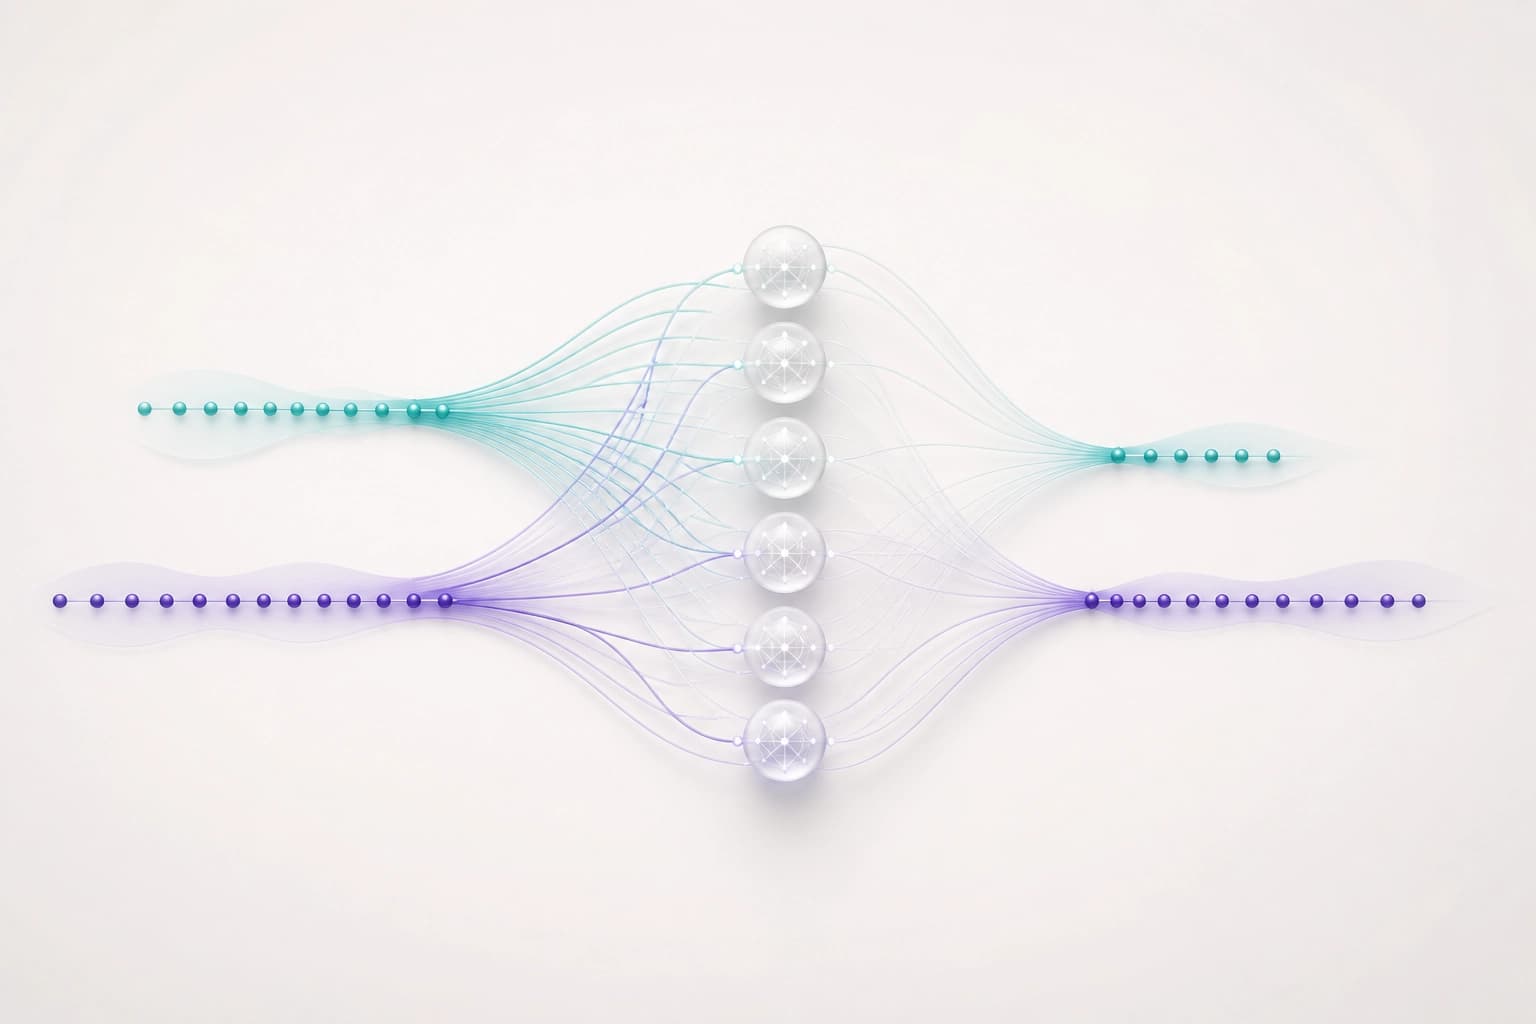
该方法需要 preference triples。DSPA 根据这些数据构建一张地图,将提示特征与生成控制特征关联起来。
DSPA 如何改变生成过程
在解码过程中,该方法只修改当前 token 激活的潜变量,不会触及其他潜变量。
主要步骤:
- DSPA 获取 preference triples。
- 构建提示特征与控制特征之间的 conditional-difference map。
- 在解码过程中修改当前 token 激活的潜变量。
实验结果
在 Gemma-2-2B/9B 和 Qwen3-8B 上,该方法提升了 MT-Bench 上的结果。在 AlpacaEval 上,DSPA 展现出竞争力,并在多项选择任务中保持了准确率。
在偏好数据有限的情况下,该方法仍然稳定,并可与两阶段流程 RAHF-SCIT 相抗衡。DSPA 用于对齐所需的 FLOPs 最多减少了 4.47×。
该论文已被 EMNLP 2026 Main Conference 接收。结果仅适用于所述模型和任务。
该方法使用哪些信号
对已修改 SAE 特征的审计表明,偏好方向主要与话语和风格信号相关。
论文还提出了一套理论,对 conditional-difference map 的估计作进一步阐释。该理论描述了 top-k 消融在什么条件下具有合理性。
何时考虑使用 DSPA
对于需要在不更新基础模型权重的情况下对齐偏好的任务,可以考虑使用该方法。该方法需要 preference triples。
实际评估时,可将任务与 MT-Bench、AlpacaEval 和多项选择任务上的结果进行对照。与 RAHF-SCIT 比较时,还应单独考虑对齐阶段的 FLOPs。


