脉冲神经网络通常是在能效的语境下被讨论的:用稀疏事件代替稠密乘法,用稀疏活动代替持续节拍。但这类模型还有第二种几乎总是被闲置的资源:随时间连续变化的膜电位。一项新研究提出,不应把它看作中间变量,而应把它视为完整的信念状态——并据此来决定接下来该考察什么。
问题:点云总是沿着同一条路线被扫描
当脉冲网络被应用于3D数据时,场景片段通常按预先设定的顺序被遍历——对所有输入都一样。遍历顺序并不取决于点云中究竟有什么。于是就出现了一种奇怪的失衡:脉冲计算最显著的特征——膜电位的时间演化——完全不影响网络会看到哪些数据、以及何时停止。决策是在动力学“之外”做出的,而不是在动力学之内。
Active Spiking Perception:由膜电位负责选择
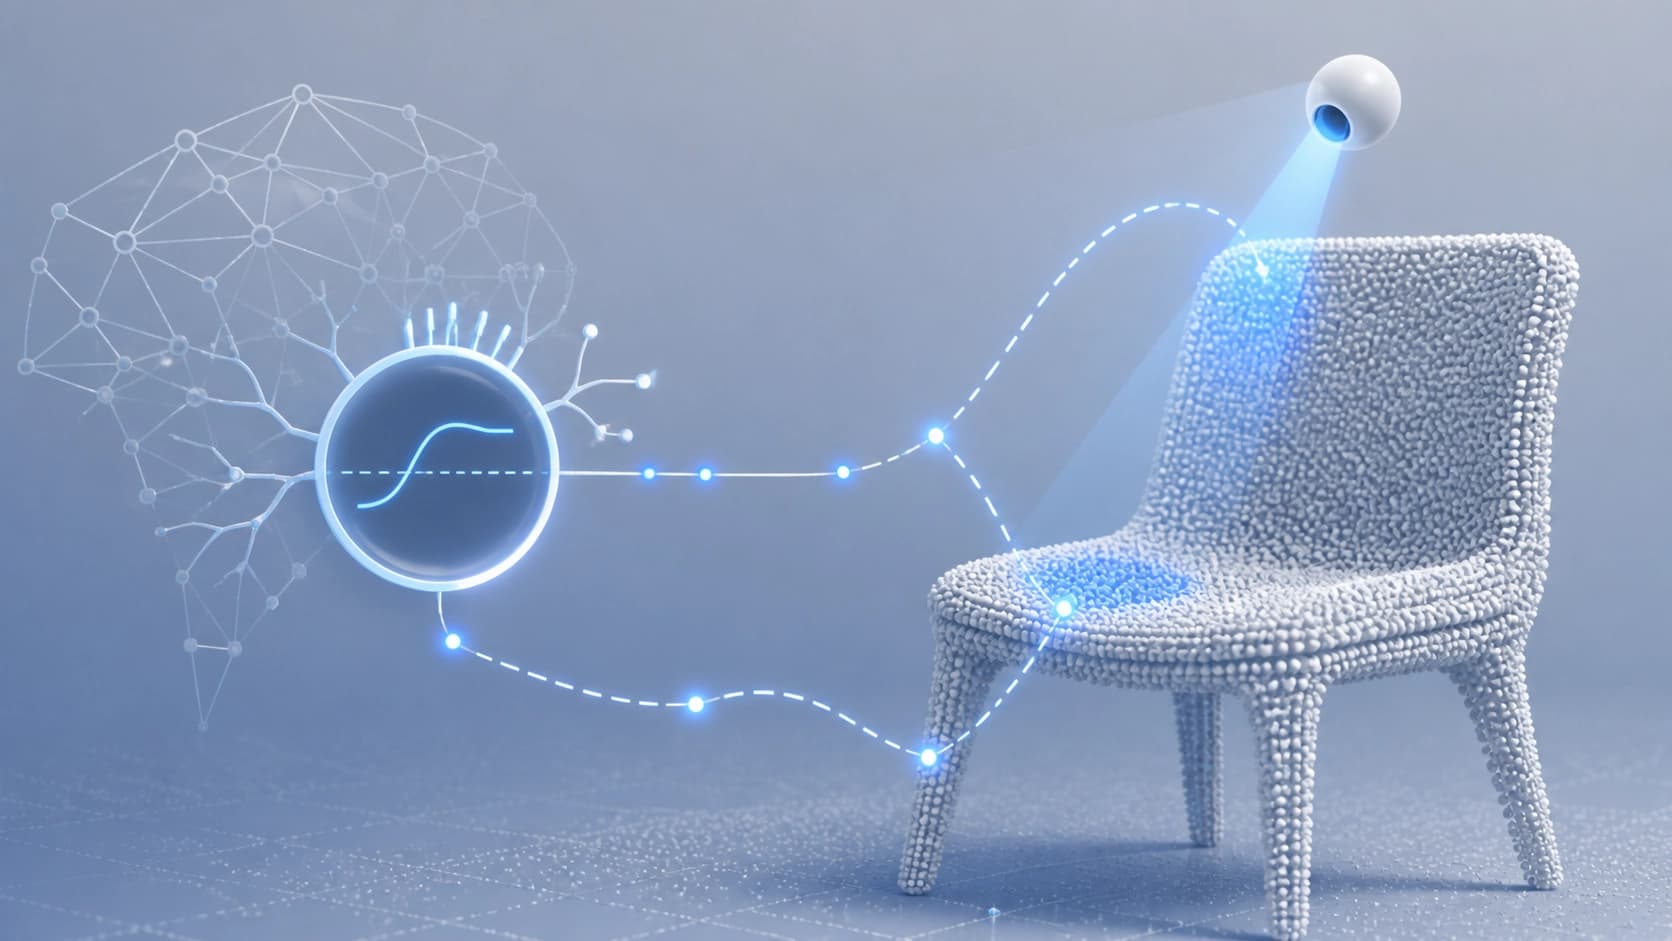
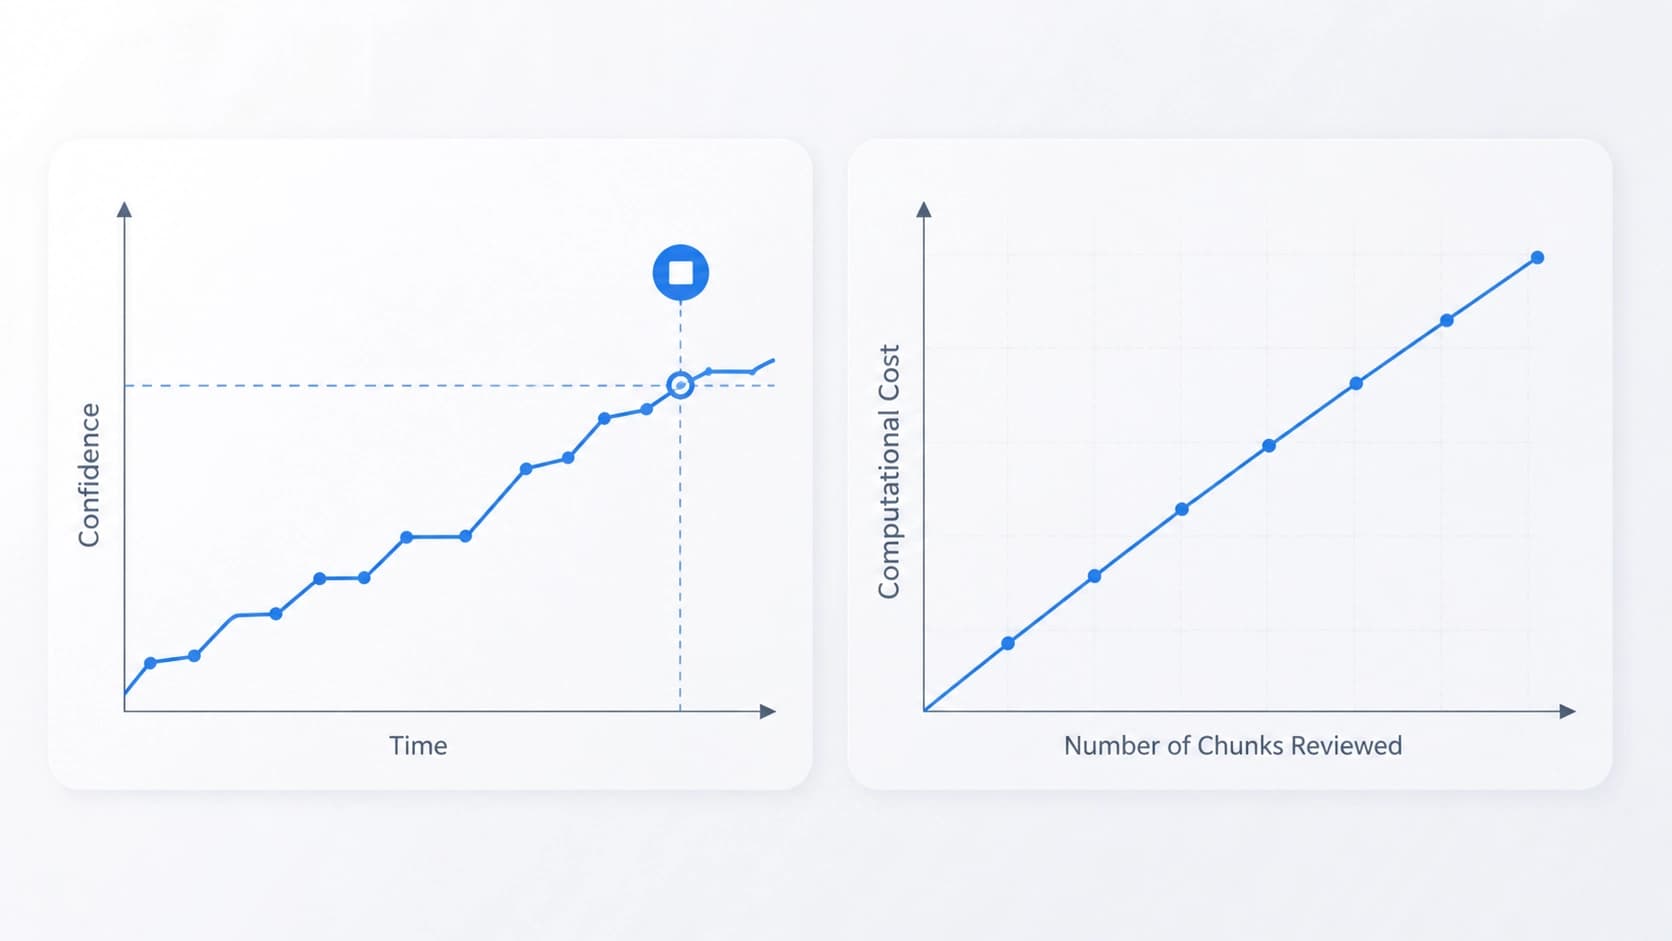
Active Spiking Perception(ASP)方法将识别展开为一个迭代循环。网络观察一个片段,更新LIF神经元(leaky integrate-and-fire,泄漏积分点火)的状态,并读取其膜电位作为当前关于类别的假设——running belief。正是这一假设决定了下一个进入视野的片段,而领先者在margin上的明显优势则成为提前停止的信号。
这个想法很简单,却改变了电位的角色:它不再是层与层之间的辅助量,而成为网络借以向自己“解释”还缺什么才能作答的接口。
选择策略是如何构成的
选择由一个轻量模块Slice-Selection Policy负责。下一次查看的候选来自farthest-point sampling(最远点采样),并依据两样东西进行评估:膜电位的当前状态和预先计算好的几何描述子。训练通过straight-through Gumbel-Softmax端到端进行,而在推理时该方案退化为普通的argmax。额外开销不大——约为骨干网络参数量的2%。
为什么这不只是启发式
作者为这一构造提供了理论基础。第一:泄漏积分的机制可以被视为贝叶斯滤波器中后验概率对数的递归更新——也就是说,电位的累积等价于证据的累积。第二:停止规则保证了分布无关的选择性风险,而且在网络决定停止观察的那一刻,无需为多重比较付出惩罚。第三:在有限精度漂移受限的条件下,跨步骤传递流式状态等价于根据观测前缀从零重新计算。
实验显示了什么
在ModelNet40上,该方法达到90.62%,在ModelNet10上达到93.28%。这比最强的脉冲基线低1.7个百分点,而且该基线使用的是更大的骨干网络。因此,峰值精度并不是这项工作最主要的论据。论据在别处:ASP增加了一个经过认证的anytime接口,而所有被比较的方法都没有提供这一点。
该机制也能扩展到稠密预测:在ShapeNetPart上为83.21 instance mIoU,在S3DIS Area 5上为48.50 mIoU。作者称后一结果是该数据集上的首个脉冲结果。
另一个独立的话题是可迁移性。如果把可学习的片段选择换成固定的,同一套逻辑在一个采用中央凹机制的非脉冲Transformer上依然有效。这说明该策略并非某种特定脉冲架构的属性,而是一种独立的技巧。
阈值作为计算量的调节旋钮
推理成本随观测数量严格线性增长——这是网络逐个处理片段的结果。置信度阈值变成了一个可量化的调节器:提高它,可以迫使模型看得更久、更准;降低它,则能更快得到答案。作者估计,相对于可比的方案,能耗可降低2.8倍到1.35倍。实际意义显而易见:同一套方案既适用于重视精度的服务器场景,也适用于更看重预算的车载场景。
局限与下一步方向
至少有一个瓶颈被如实指出:在所使用的裁剪尺寸下,S3DIS中的一个类别无法被识别。作者没有隐瞒这一点,而是给出了一个本可消除该问题的预测——实质上,是为工作的下一次迭代提供的提示。
结论
这项工作最大的价值不在于基准测试上的数字,而在于视角的转变。在这里,膜电位不是积分的副产品,而是一种信念状态,行动的选择和停止的判据都从中推导出来。由此产生三个结果:出现了带有认证保证的anytime模式;成本变为线性,并可由单一参数控制;而选择策略本身可迁移到其他架构,包括非脉冲架构。
换句话说,脉冲模型不仅拥有能源资源,还拥有一种“决策”资源。而且使用它无需从头重写骨干网络。
技术细节见预印本arXiv:2608.19232(cs.NE、cs.AI、cs.LG;ACM I.2.10、I.5.1、I.2.6),v1版本为2026年8月4日,v2为8月22日。篇幅为28页、9幅图、17张表以及附录A–J。