为什么轨迹是一个糟糕的度量单位
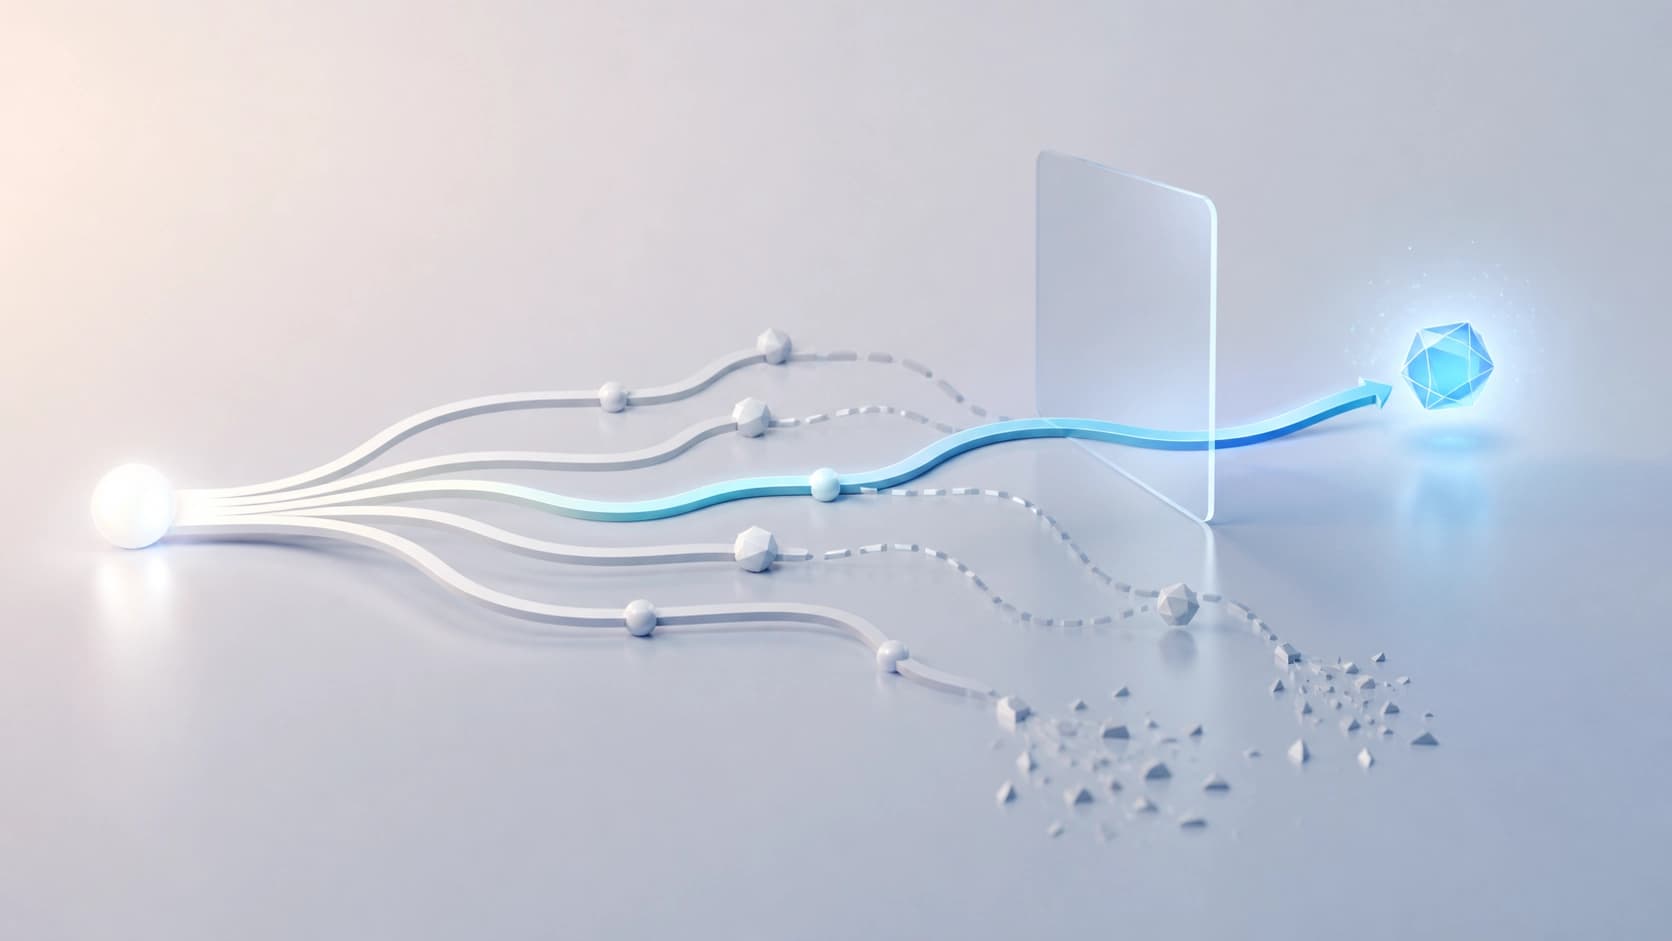
现代推理时方法都遵循同一套模式:模型不是生成单个答案,而是生成一整池候选链,然后由外部奖励模型选出最好的一个。逻辑很简单——候选越多,其中出现好结果的机会就越大。
但薄弱之处在别的地方。每个候选都被当作一个不可分割的整体:要么全盘接受,要么整个丢进垃圾桶。然而一段长推理很少是同质的。典型情况是——开头自信且正确,问题表述严谨,方法选择得当,然后突然崩盘:算术错误、陷入循环、条件被偷换。形式上整条链被标记为失败,尽管它的前半部分完全可用。
结果就是——白白浪费的算力。我们为那些正确的 token 生成付了费,然后却把它们连同坏掉的尾巴一起扔掉。正是这种低效,被 Selective Regenerative Decoding 这篇论文的作者指出,该论文于 2026 年 8 月 25 日以 arXiv:2608.24338(cs.AI)发布。
SRD:三条分支而非两条
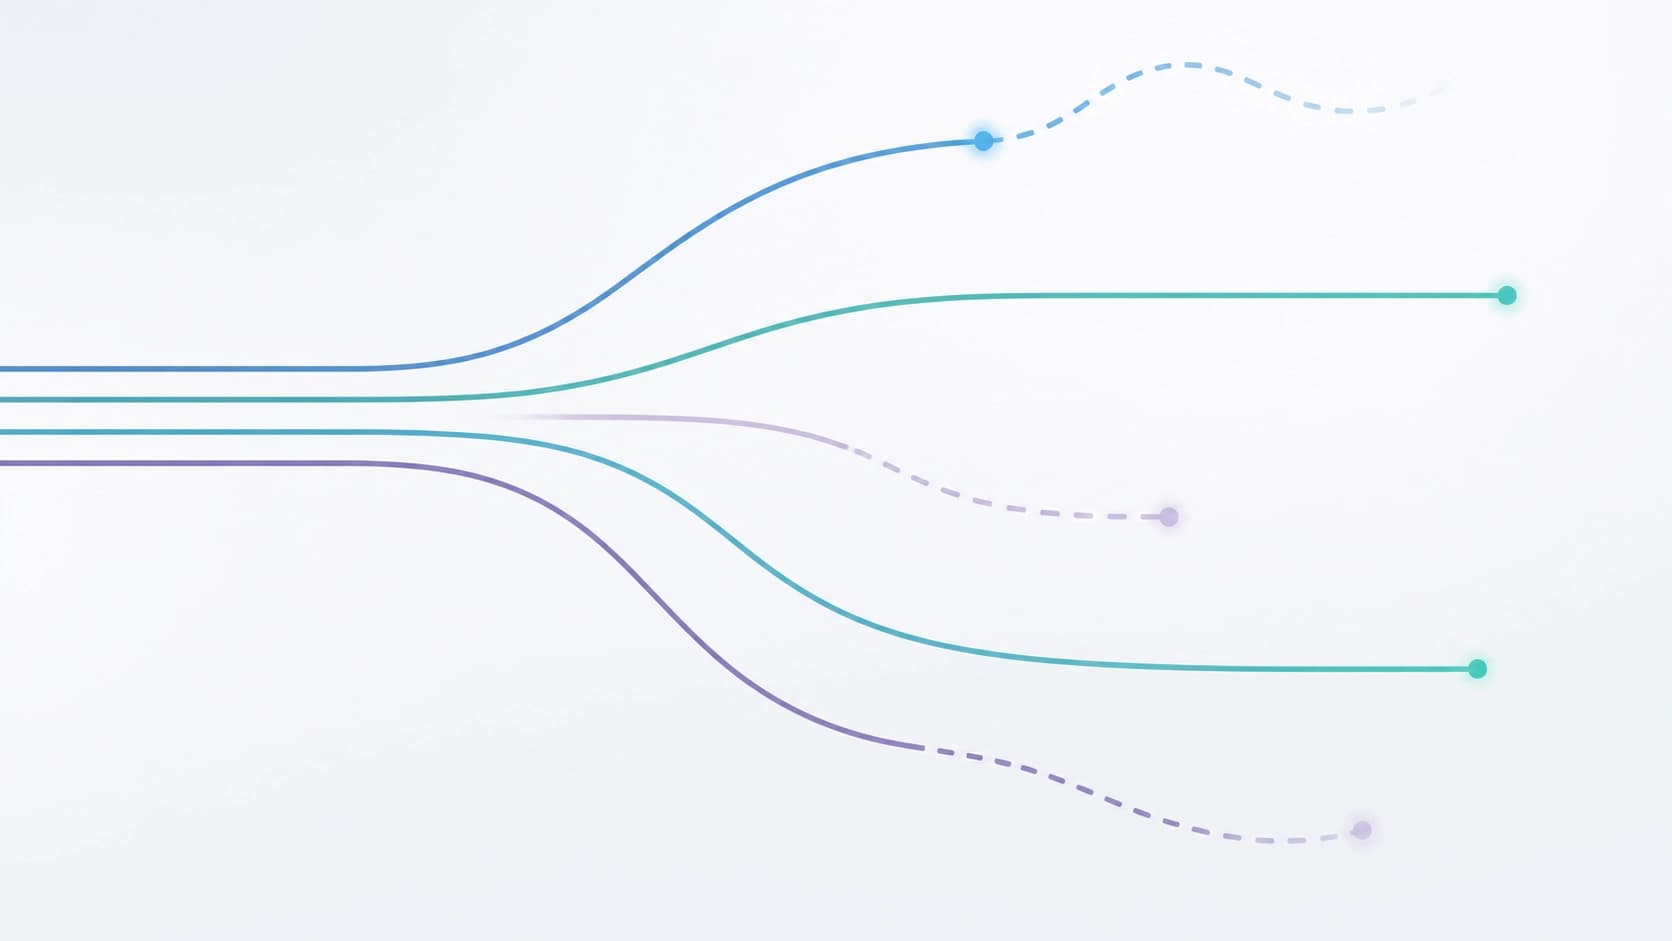
Selective Regenerative Decoding(SRD)提出放弃二元选择。不再是「接受或丢弃」,每个候选被导向三条分支之一:
- 丢弃——如果整条链从头到尾都毫无用处;
- 保留——如果它能完整通过检验;
- 修补——如果存在有用的部分,但后缀明显退化。
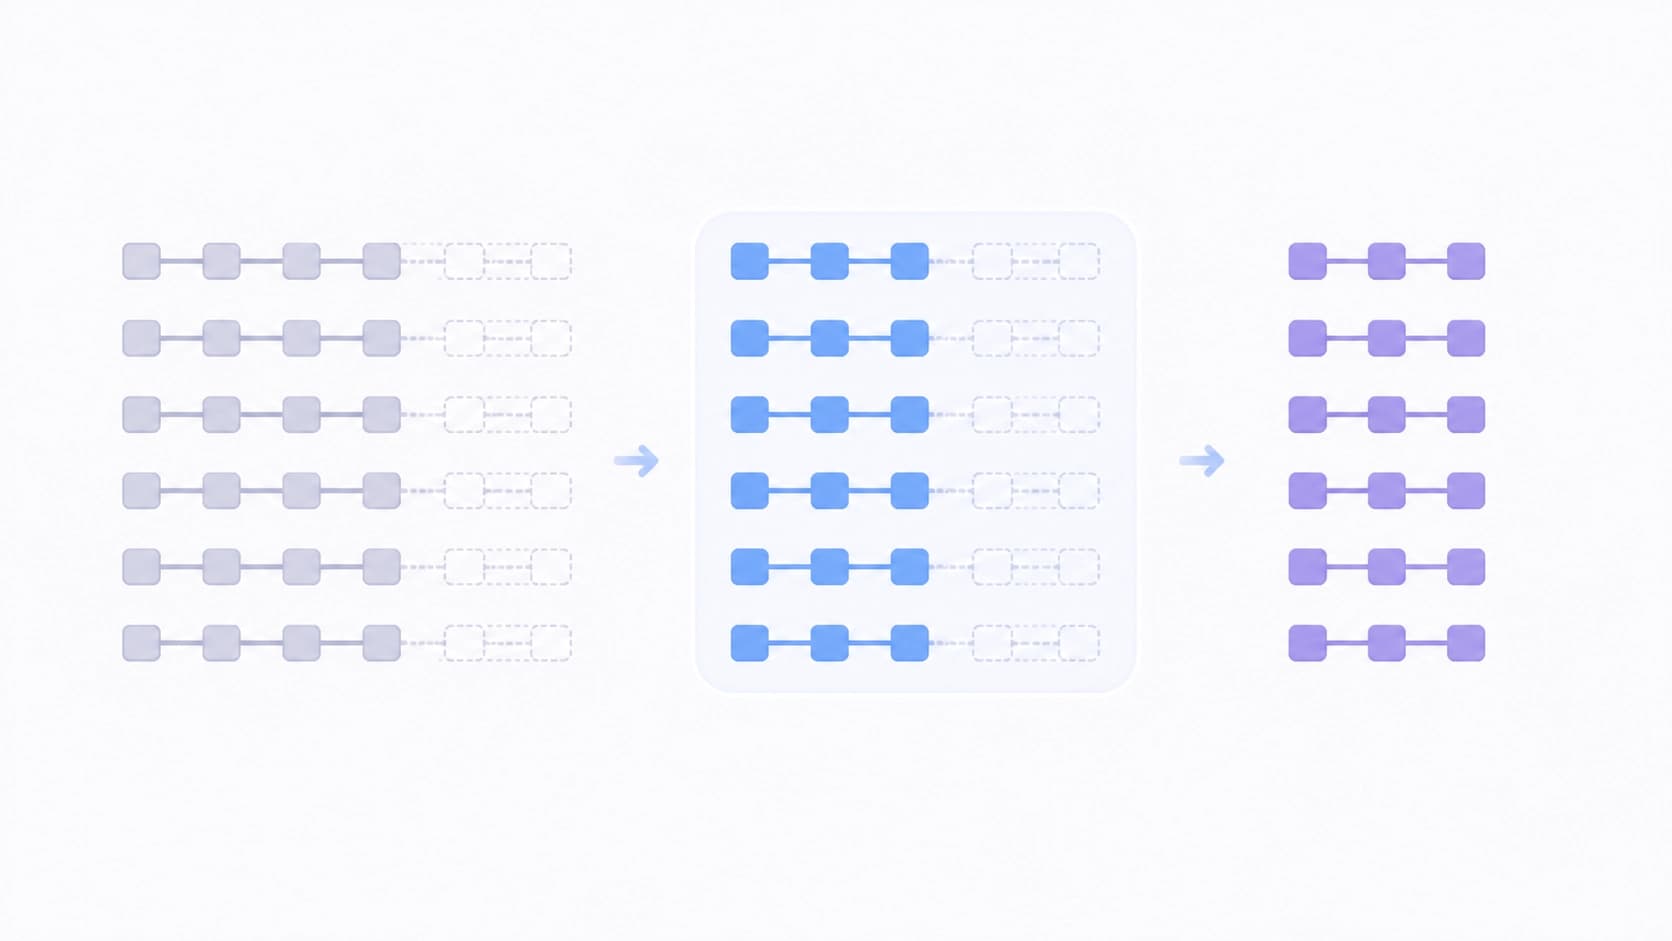
在第三种情况下,系统不是从零重写推理,而是保留高质量的前缀,只重新生成损坏的部分。这更接近于修改草稿,而不是写一篇新文章:你不会因为结尾失败就扔掉精彩的开头,而是修补坏掉的地方。
作者特别强调,这种干预不需要更大的捐赠模型。不需要什么「聪明的老师」来拉拔弱小的学生——所有工作都在现有算力资源范围内完成。正是这一点让该方法具有实用性,而不是一场理论练习。
收益从何而来
这篇论文最有趣的地方不是启发式方法,而是它的论证。在温和假设下,SRD 相对于经典拒绝采样给出了可证明的 1.28–1.36 倍采样效率提升,而且最终轨迹的期望质量严格更高,而不只是「不更差」。
这里的直觉不用公式也能理解。经过后缀再生成的候选,本身已经包含了已付费的算力——那些无需重新生成的前缀 token。这类边界候选被挽救得越多,生成文本中进入垃圾桶的比例就越小。而由于候选池增大时「几乎成功」的链条数量也会增加,收益并非恒定——它会随生成预算一起扩展。
在哪里验证的
实证部分涵盖四种不同类型的负载:MATH500(数学题)、GPQA Diamond(科学级问题)、HotpotQA(基于文档的多跳问题)和 AlpacaEval(指令遵循与偏好评估)。测试在多种「生成器 + 奖励模型」组合上进行,以确保结果不依赖于某一对幸运的搭配。
所宣称的结果:SRD 达到了通常需要 Best-of-N 模式才能获得的准确率,但消耗的生成 token 明显更少。而在算力受限的场景中,该方法超越了 speculative rejection——也就是说,它恰恰在每一个多余 token 都很昂贵的地方胜出。
本质上改变了什么
作者所记录的主要转变是方法论层面的。以前选择发生在整条轨迹的层面:奖励模型打分并决定整段推理的命运。SRD 将干预移入轨迹内部,移到片段层面,并借此开辟了准确率与算力之间此前几乎未被研究的权衡空间。
对于构建推理流水线的人来说,实践结论是:推理质量与其获取成本未必是刚性绑定的量。如果不再把模型的草稿当作一个整体,一部分「多余」的算力是可以收回的。
什么仍留在视野之外
未解的问题不少。关键的一个是——健康前缀与退化后缀之间的边界究竟如何界定:有多少候选能进入第三条分支,取决于这一标准。接下来是——再生成本身的成本(它并非免费)、对奖励模型选择的敏感性,以及结论能否推广到所用四个基准之外。
论文共 20 页,提交至 ARR,也就是说目前还是第一版预印本,而非经过同行评审的结果。但这个方向看起来很有前景:与其生成更多、筛选更严,不如更精细地利用模型已经想出来的东西。