问题:能运行但做错事的代码
基于大语言模型的智能体已经能够拿到一篇科学论文并据此产出一个可运行的代码仓库。问题在于,“可运行”和“可复现”并不是同义词。脚本可能顺利通过所有测试、训练出模型、打印出漂亮的指标,但在其内部,步骤顺序可能被悄然调换,损失函数中可能丢失了某个乘数,或者某个非平凡的环节被替换成了占位符。
正是这种失效模式被新论文的作者们称为语义漂移(semantic drift):生成的代码与论文规范中所描述的内容悄然背离。错误并不显眼——它藏在那些没人会自动检查的细节里。结果就是——复现在形式上完成了,但在科学上什么也没有证实。
SA-Bench 是什么
要测量漂移,首先得让它变得可观测。SemanticAlign-Bench(简称 SA-Bench)正是做这件事的——这是一个诊断性基准,描述于论文 arXiv:2608.24252(被 Findings of EMNLP 2026 接收,作者为 Xue Hu、Zewei Pan、Zeli Su、Zhou Liu 和 Wentao Zhang)。
该材料涵盖来自 ICLR、ICML 和 NeurIPS 2025 会议的 30 篇论文,分布在机器学习的五个领域。评估的不是对代码的“感觉”,而是一组可验证的断言。该基准中共收集了 1,491 条这样的断言。
Semantic Alignment Units:规范的原子
核心方法论思想是将论文描述拆解为可以对照代码仓库手动核查的最小元素。这些元素被称为 Semantic Alignment Units(SAU)。每个单元都是一条关于实现的独立断言:某个具体的超参数、公式、操作顺序、停止条件、数据划分方案。
这种细粒度的做法之所以重要,是因为它让评估摆脱了“成功/失败”的二元性。不再是对一篇论文打一个勾,而是出现上百个小问题,从而能看清实现究竟在哪里出了问题。
漂移的四个维度
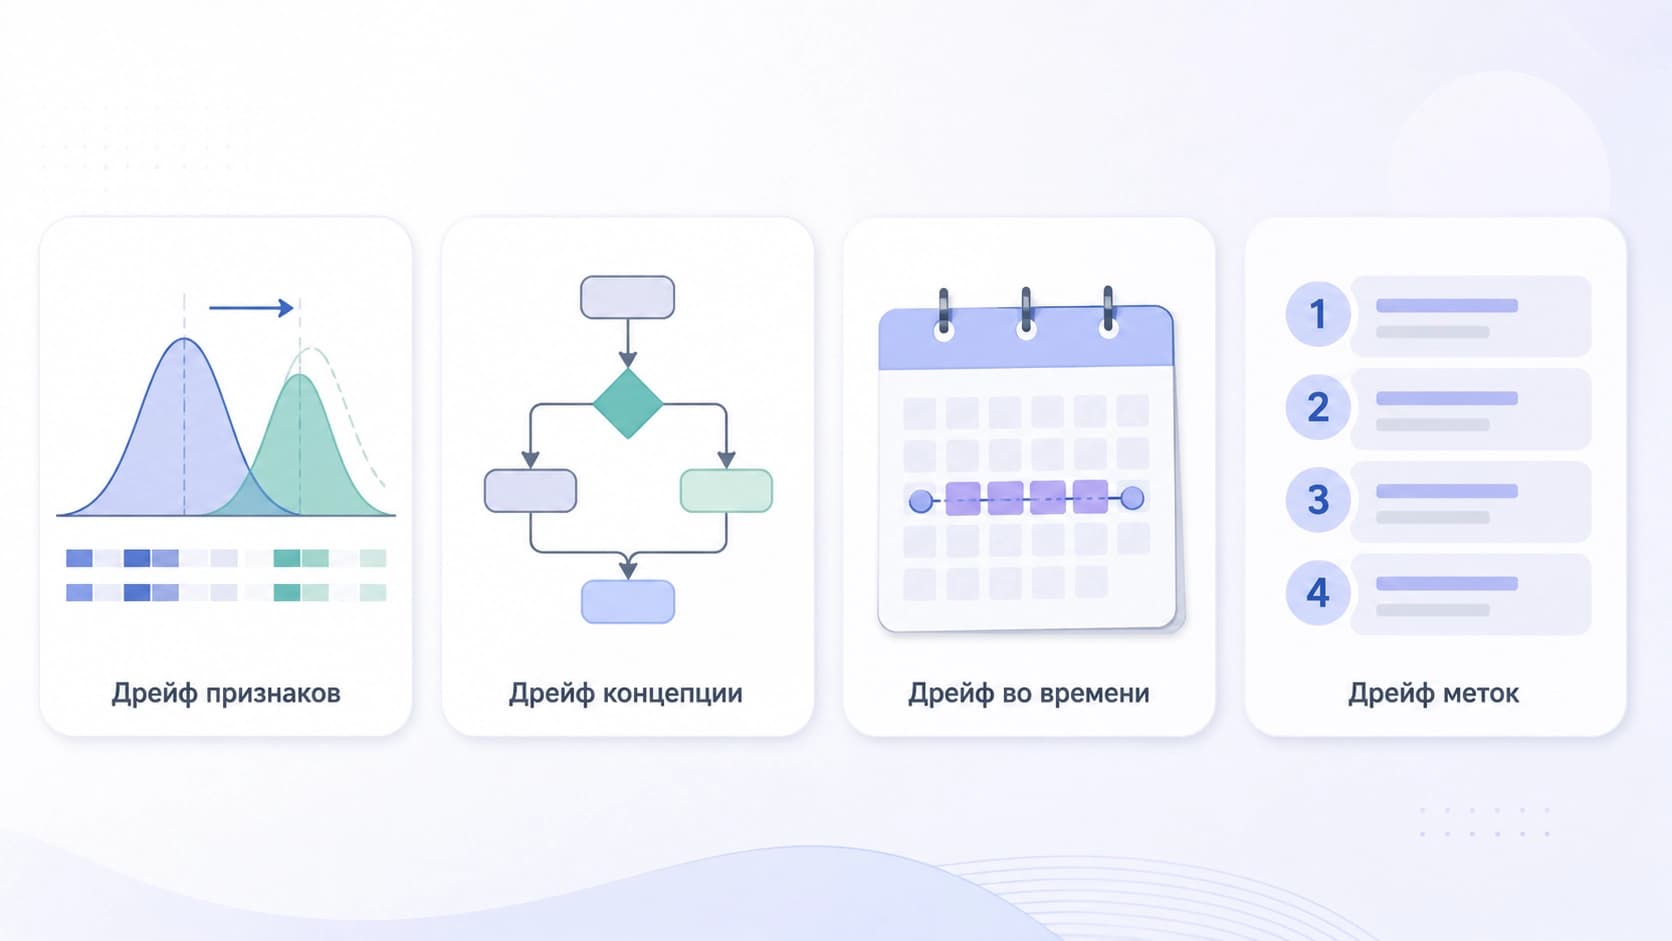
每个代码仓库都沿着四条诊断轴进行评估:
- 数值漂移——系数、维度、阈值及其他量的取值与规范不符;
- 方法漂移——训练或计算过程本身的构造与论文设想不同;
- 协议漂移——实验方案被破坏:样本划分、比较条件、评估规程;
- 顺序漂移——步骤以错误的顺序执行,从而改变了结果。
对轴的划分带来了实际好处:开发者看到的不是抽象的“质量低”,而是具体的故障类型。
结果:0.301 作为天花板
作者们测试了 12 种生成器配置——四种模型与三种脚手架的组合。每项评分都以占 1 的比例来衡量。
数字令人清醒。最佳结果由 Claude 与 PaperCoder 的组合取得——在满分为 1.0 的情况下平均获得 0.301 的 SAU 分数。全部 360 项评分的总平均分为 0.221。
换言之,即便最强的配置也只能正确完成规范所要求的不到三分之一。与此同时,模型并非无视要求:失效分类法显示,智能体通常会尝试覆盖大多数条目,但实现方式有误。被清零的断言中,绝大部分来自两种情形——实现与设想不符(implementation mismatch)以及占位符(stubs),也就是用空洞的形式替代了真正的逻辑。
这样的错误画像说明了一件重要的事:问题不在于智能体偷懒,也不在于它“没读完”论文。问题在于,它自信地复现了一个看似合理、实则错误的版本。
可执行性不等于科学忠实度
该工作的另一个结论涉及现代脚手架的构造方式。那些针对可执行性——即让代码能跑起来、不崩溃——进行优化的脚手架,对科学复现带来的收益有限。这合乎逻辑:成功运行检验的是语法和依赖是否齐全,却丝毫不能说明逻辑是否与作者的设想一致。
要缩小这一差距,需要另一类脚手架——那些把语义规范验证放在首位的脚手架。简单来说,智能体不仅要编写并运行代码,还要将自己的每一步与论文中的断言进行比对,并能够证明二者确实一致。
这在实践中改变了什么
SA-Bench 不是模型的竞赛,而是一个诊断工具。它的价值在于,把关于可复现性的讨论从“能用/不能用”的层面转移到“在多大程度上精确对应”的层面。该基准、标注和评估流水线均已公开,因此这套方法论也可以应用于自己的任务——例如,用来核查依据技术需求书而非仅依据科学论文进行代码生成的内部流水线。
对于那些构建智能体的人来说,结论是这样的:在没有单独验证层的情况下不断提升生成器的“聪明程度”,会撞上天花板。语义漂移不是某个具体模型的 bug,而是这样一种方法的固有属性——在这种方法中,没有人核查语义上的一致性。而只要这样的层还不存在,复现研究代码就仍是一项需要人类逐行阅读的任务。