三种模型,一个许可证,没有任何附加条件
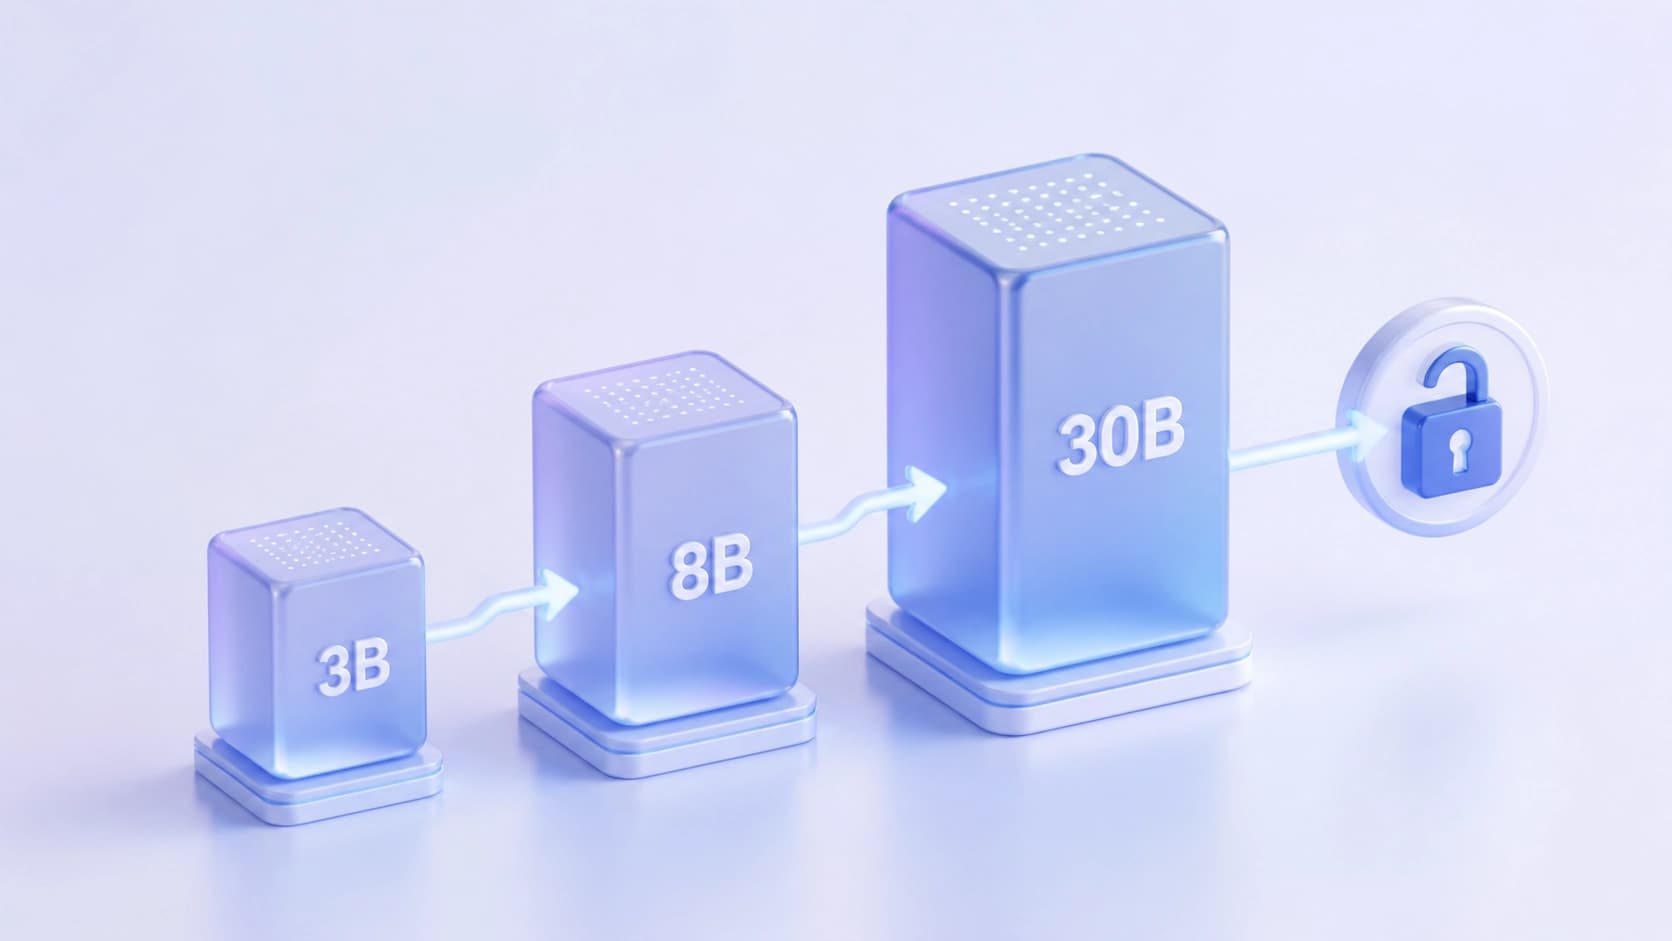
Granite 4.2 已不再是前几代产品那种专注于遵循指令的助手。IBM 围绕显式推理重构了整个系列:任何一个模型都会先逐步阐述推理链条,然后再给出答案。本次发布包含三种规模——3B、8B 和 30B 参数。
对企业而言,最重要的消息不在基准测试,而在许可证。三款模型均以 Apache 2.0 发布:下载、微调和生产环境部署都无需额外审批,也没有商业应用限制。对于受监管行业的公司来说,能够将权重保留在本地部署,往往比指标表格中的任何数字都更有分量。
与此同时还发布了两款语音模型 Granite Speech 5.0 Turbo CTC,各 4.7 亿参数——下文将单独介绍。
工作模式可直接在 chat 模板中切换。有 thinking,有 non-thinking,两者之间还有 low-effort:针对简单问题的短推理预算,以免在任务不值得时浪费 token。本质上,同一个模型既能应对"好好想一想",也能应对"快速作答"。
谁该选哪个规模
3B——个人开发者的笔记本电脑
最小模型面向个人开发者和小型初创公司。可以通过 Ollama 或 LM Studio 在本地运行,包括使用已发布的 GGUF 量化版本,最高支持 Q4_K_M。这是"装在笔记本上随便实验,不用担心 API 账单"的场景。
8B——团队用一块现代 GPU
中等规模面向中型市场团队:一块当代显卡就足以让模型保持在生产环境中运行。
30B——企业级部署
最大版本需要 A100 或 H100 级别的算力,以及在 vLLM 上以 FP8 或 NVFP4 进行维护。但这也是那种可以把模型部署在内部边界内、不将数据外传的场景。
IBM 明确瞄准的行业:软件开发和开发者工具、金融服务、医疗健康、电信、公共部门以及联络中心——后者正是为新的语音模型准备的。典型场景包括:代码编写智能体、终端和 DevOps 自动化、深度研究与搜索、长文档 RAG、结构化工具调用以及大规模转录。
架构:没有花招的稠密 Transformer
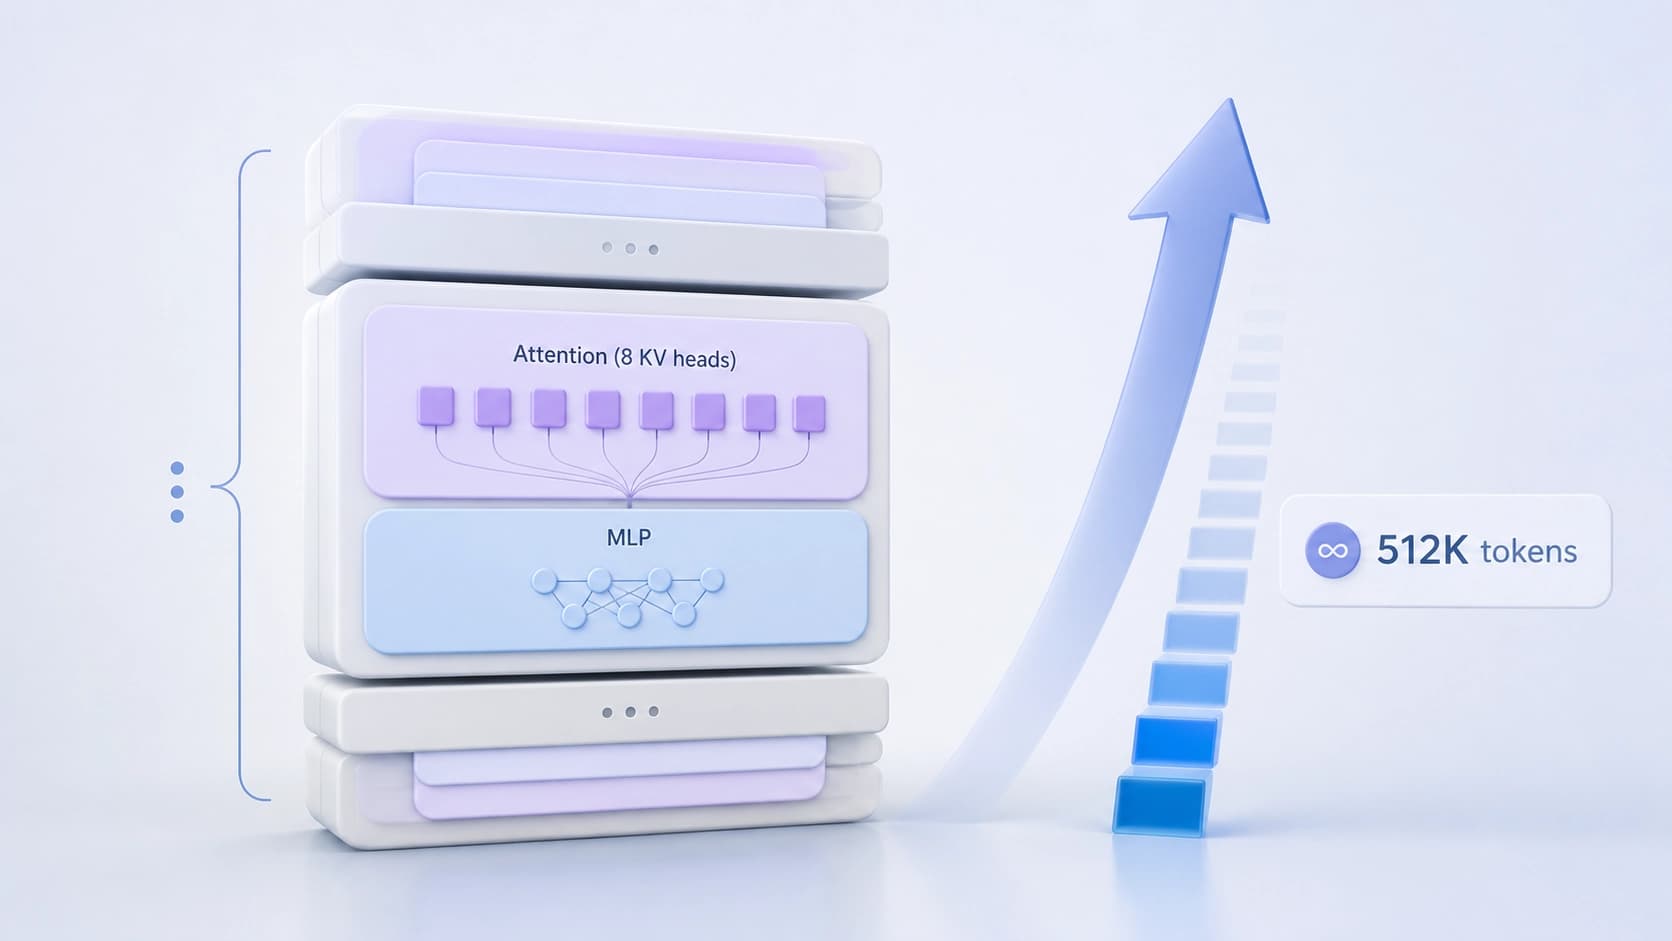
Granite 4.2 是一个 decoder-only 的稠密 Transformer。没有混合架构,没有 mixture-of-experts:押注的是行为的可预测性和部署的简便性,这对企业级部署来说是合理的。
技术细节如下:
- Grouped Query Attention,8 个 KV 头;
- RoPE,θ = 10 000 000;
- MLP 中使用 SwiGLU;
- RMSNorm,ε = 1e-5;
- 输入和输出嵌入不共享;
- bfloat16 精度。
各规模的区别如下:3B 有 40 层,嵌入维度 2560;8B 同样是 40 层,但嵌入维度为 4096;30B 有 64 层,MLP 隐藏维度为 32 768。
在公布的架构表中,序列长度为 131 072 token,即 128K。而预训练过程包含五个阶段,其中包括长达 512K token 的长上下文阶段。从零开始的训练大约使用了 15 万亿 token。
训练:SFT,然后是多阶段 RL
监督微调阶段大约使用了 720 万个样本——约 1000 亿 token,其中可训练的约 650 亿。数据混合分布如下:31.6% 为智能体样本,68.4% 为非智能体样本,其中软件工程占智能体部分的 69%。
轨迹在多种 harness 中采集——包括 OpenHands、SWE-agent、Terminus-2、MiniSWE、Codex 和 Goose。质量通过两种方式过滤:由 GPT-OSS-120B 和 Gemma 4 担任评判者,同时对 tools 和 messages 字段进行 SHA-256 去重。
后训练不是一次通过,而是跨多个环境的 RL 链条。每个阶段都是一次独立的异步 GRPO 运行,从前一个检查点 warm-start;不使用 value 网络,而是采用 leave-one-out 基线,截断的重要性采样则限制 off-policy 漂移。顺序如下:先是 RLVR,然后是 skill boosters,接着是 SWE、Terminal 和 Search,最后是 RLHF。
这里隐藏着本次发布最重要的限制:智能体 RL 模块仅应用于 8B 和 30B。最小的 3B 只经过基础 RL 和对齐——这在很大程度上解释了各规模之间的能力差距。训练在 NeMo-RL 和 NeMo-Gym 上进行,使用部署在 CoreWeave 的 NVIDIA GB200 NVL72 集群。此外,流程中还加入了来自 CodeAlchemy 的 1 万亿 token 合成代码,以及用于加速服务的投机解码层。
IBM 的指标显示了什么
这些数字由 IBM 自己公布,因此应将其视为参考,而非独立验证。数值顺序为 3B / 8B / 30B:
- SWE-Bench Verified:3B 无评分,8B 为 47.6,30B 为 57.00;
- Terminal-Bench 2.1:分别为 20.56 和 29.24;
- τ³-bench:50.99 / 66.34 / 68.05;
- BFCL v4:52.41 / 50.29 / 61.39;
- AIME25:78.33 / 86.67 / 89.17;
- GPQA:54.80 / 64.14 / 66.41;
- MMLU-Pro:67.84 / 74.04 / 77.60;
- RULER 128K:55.30 / 71.41 / 81.38。
一个有趣的细节——在函数调用测试中,8B 略逊于 3B(50.29 对 52.41)。这提醒我们,规模本身并不能保证在每一项单独技能上都占优,为任务选择模型比追求更大的检查点更重要。
语音:4.7 亿参数,无需 LLM 主干
语音模型 Granite Speech 5.0 Turbo CTC 的构造与常见的基于语言模型的 ASR 系统截然不同:这里完全不使用 LLM 主干,音频到文本的转换通过 connectionist temporal classification 完成。正因如此才如此紧凑——4.7 亿参数。
IBM 声称在单块 H200 上 RTFx 约为 12 600,而目前 Open ASR leaderboard 上的速度领先者大约为 6 000。对于拥有大量录音的联络中心来说,吞吐量的差距直接转化为金钱。可以在 WebGPU 演示中试用该模型。
总结
IBM 为 corporate 市场打造了一款可预测的产品:没有架构上的奇技淫巧的稠密模型、开放的许可证、自有硬件部署,以及针对不同任务类型的推理模式。智能体能力集中在 8B 和 30B,因此 3B 理应被视为低成本的入门点和简单场景的模型,而非"无损的弟弟"。详细信息应查阅 IBM Research 博客、技术说明和 GitHub 仓库,相关链接随发布一并提供。