基于结果的奖励——及其内部的盲区
在GUI智能体研究中,重心明显发生了转移:越来越多的研究致力于结果奖励建模(outcome reward modeling)。逻辑很简单——智能体根据其轨迹是否导向用户指令所预期的状态而获得评分。有动作,有屏幕,有结果,有评分。
但陷阱也正藏在这里。如果智能体因“结果”而获得奖励,那么总得有人来界定究竟什么才算结果。在典型方案中,这一步要么被跳过,用笼统的表述取而代之,要么交由模型自行判断:模型在验证过程中“推理”,却没有明确固定的标准。这两种做法看起来都行得通——直到需要用同一个验证器去评估几十个各不相同的任务时。
通用评分标准的三种典型错误
论文arXiv:2608.24174《Task-Adaptive Rubrics for GUI Reward Modeling》(Tao Xiong及合著者)描述了依赖通用模板或模型隐式推理会导致什么后果。问题是可以预见的:
- 检查项在任务间迁移。 曾为某个场景推导出的标准,被机械地套用到另一个场景,而在那里它根本说不通。
- 约束丢失。 当前指令中的具体要求——所需的值、特定字段、确定的步骤——被忽略,因为通用评分标准无法区分它们。
- 过度严苛。 验证器开始要求用户并未提出的东西,并将正确完成的任务判为不合格。
这三种错误的共同原因只有一个:评分标准与任务相分离。它不是从指令中推导出来的,而是从外部附加到指令上的。
AdaptRubric是如何构建的
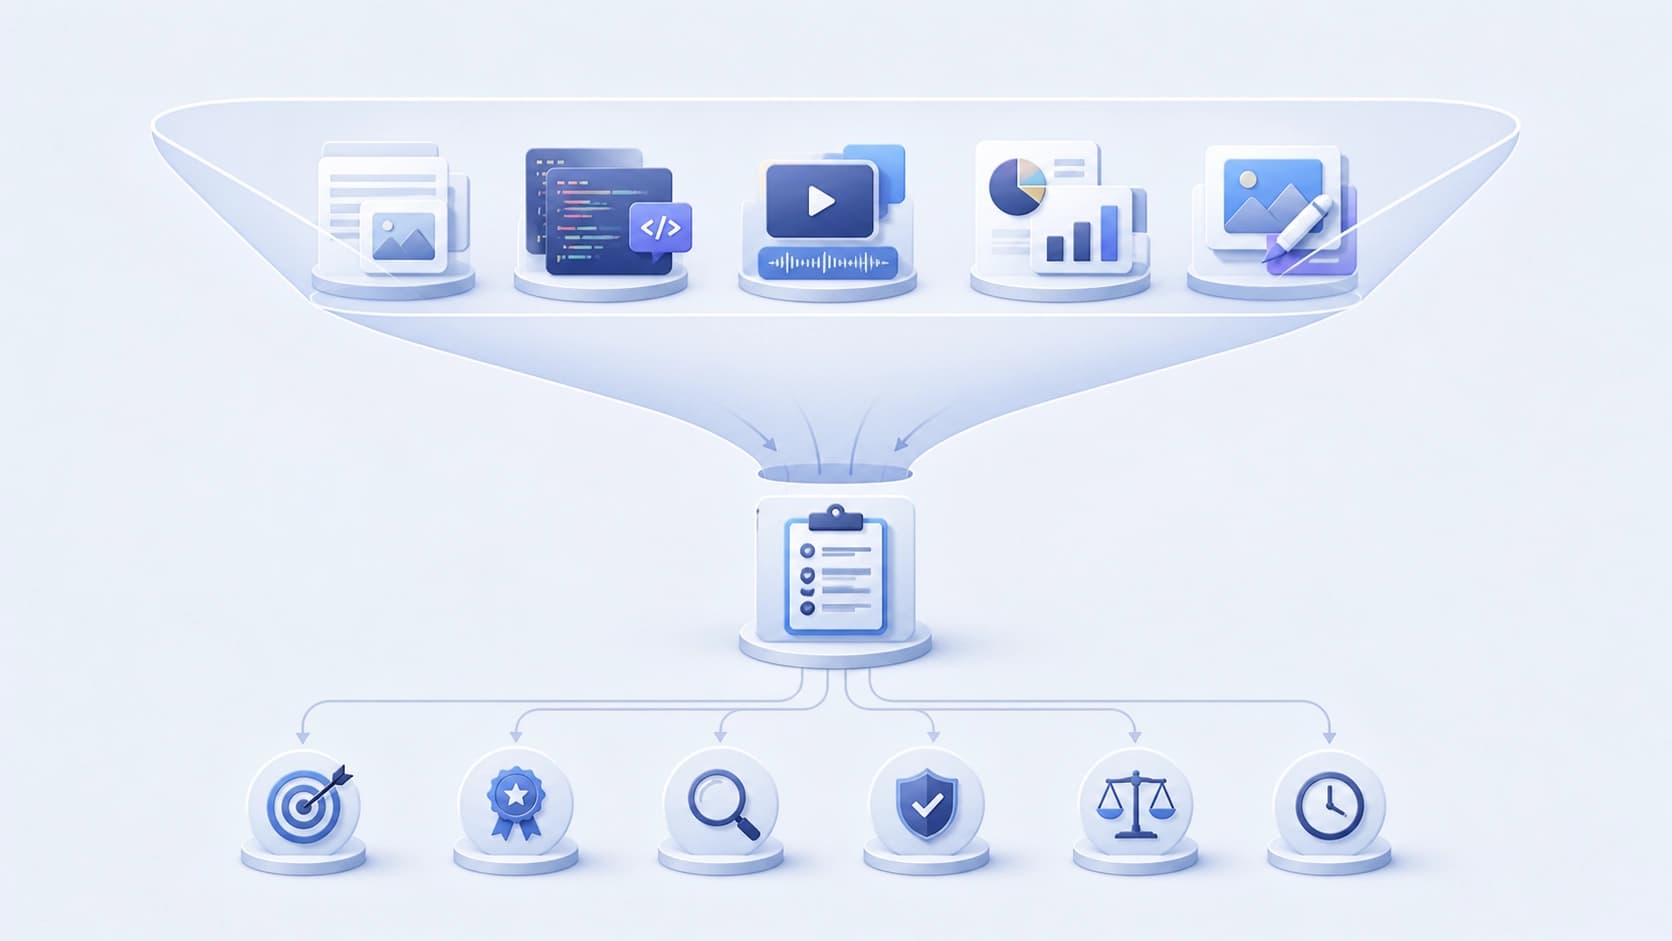
所提出的框架正是如此命名——由粗到细评分标准框架(Coarse-to-Fine Rubrics Framework)。它的任务不是存储一套现成的标准,而是针对每一条具体指令来构建标准,从宽泛层面推进到精细层面。两个阶段解决两个不同的问题,这是该设计的关键细节。
粗粒度阶段:先弄清这属于哪类任务
第一步是路由。指令被归入某个特定的GUI任务族,并从该任务族中提取可复用的标准。其意义在于,相似的动作具有稳定的成功特征:这些特征已经为人所知,无需为每个新请求重新发明。粗粒度评分标准设定的是框架——是框架,而非最终判决。
细粒度阶段:提取具体实例的细节
第二步则针对单条指令展开。从中提取紧凑的提示——具体数值、作用范围、在该任务中至关重要的约束。正是在这里,评分标准不再是通用的,而成为针对该具体个例的专属标准。用户未提出的要求不会出现;用户提出的要求不会丢失。
这种划分消除了对通用方案的主要诟病:泛化得以保留,但它不再取代具体规格说明。
结果:离线与强化学习
AdaptRubric在两种模式下进行了测试。第一种是离线奖励评估,即验证器区分成功与失败轨迹的能力。第二种是在线优化与强化学习,此时评分标准作为智能体训练的信号来源。
所公布的数据:在图像预算相当的情况下,F1指标相对于基线方案的平均值提升了3.6个百分点,任务完成成功率的提升为4.23个百分点。作者强调,这一优势能够稳定复现,而非依赖个别成功的运行。
这在本质上改变了什么
对智能体的评估不再是一个“验证器好还是坏”的问题。它变成了一个流程问题:是谁、基于什么为这个具体任务制定了标准。当标准是隐式推导出来的时候,评估错误几乎无法与智能体本身的错误区分开来——两者在最终报告中看起来一模一样。
自适应评分标准的方法使中间层变得显式,因此可以将其与模型分开来检查、讨论和修正。对开发而言这还有实际便利:如果评分标准是根据指令构建的,那么改变任务表述就会自动改变其评估方式,无需重写验证器。
开放性问题依然存在——路由在处理跨任务族边界任务时的表现如何,细粒度阶段在面对刻意含糊的指令时表现如何。但这一提法本身看起来已经比又一次试图让通用模板稍微更精细一些的尝试更有价值。