问题:测试太少,而奖励全靠它
基于可验证奖励的强化学习(RLVR)已成为将语言模型提升到合格代码生成水平的主要手段。流程很简单:模型写出解法,专门的校验程序将其跑过测试,再根据结果给模型发放奖励。这一切都建立在一个假设之上——测试确实完整地描述了任务。
在实践中,这个假设几乎总是被打破。测试用例集狭窄,覆盖千疮百孔,模型很快找到的不是任务本身,而是漏洞:它把代码贴合到具体的检查上,而不是学会解决一类相似的问题。接下来便是熟悉的螺旋——reward hacking,随之而来的是策略退化。模型在通用技能上的损失,恰好等于它在狭窄小聪明上的收获。
一个粗略的类比:一场只有两道题的考试。背下这两道题答案的学生得了满分,却并不懂这门学科。而这种训练持续得越久,他在其他一切方面就变得越差。
RobustTests 的思路:把错误当作测试生成器
通常测试是围绕题目条件来设计的:有哪些输入、范围的边界在哪里、空输入会发生什么。这很合理,但正是这条路径带来了狭窄的覆盖——测试作者和解法作者从同一侧看问题,对同样的地方同样视而不见。
RobustTests 把这个过程颠倒过来。该框架的核心是由错误代码驱动的测试用例合成(faulty-code-driven test case synthesis)。这里说的不是随机的坏代码,而是「几乎正确」的解法:那些与正确解法只差一处小逻辑改动的解法——比较符号写反、循环边界错误、漏掉一个分支。每一个这样的解法都几乎能跑通,正因如此它才有价值。
接下来寻找一个输入,让几乎正确的代码与标准答案产生分歧。找到的这个输入就成了测试。这样的测试具有很强的诊断力:它不只是「检查了点什么」,而是区分两种相近的行为——我们想从模型那里得到的行为,和看起来合理但实则错误的行为。
该工作发表于 arXiv 预印本 2608.24135(Yiwen Zhang 及另外八位作者,其中包括 Xiaodong Yan、Zhenyu Huang、Deng Zhao 等;v1——2026 年 8 月 25 日,v2——2026 年 8 月 27 日,DOI 10.48550/arXiv.2608.24135,已被 EMNLP 2026 接收)。作者将材料同时归入两个分类——cs.AI 和 cs.SE,这很合理:它既关乎模型训练,也关乎测试工程。
过滤:验证智能体与聚类
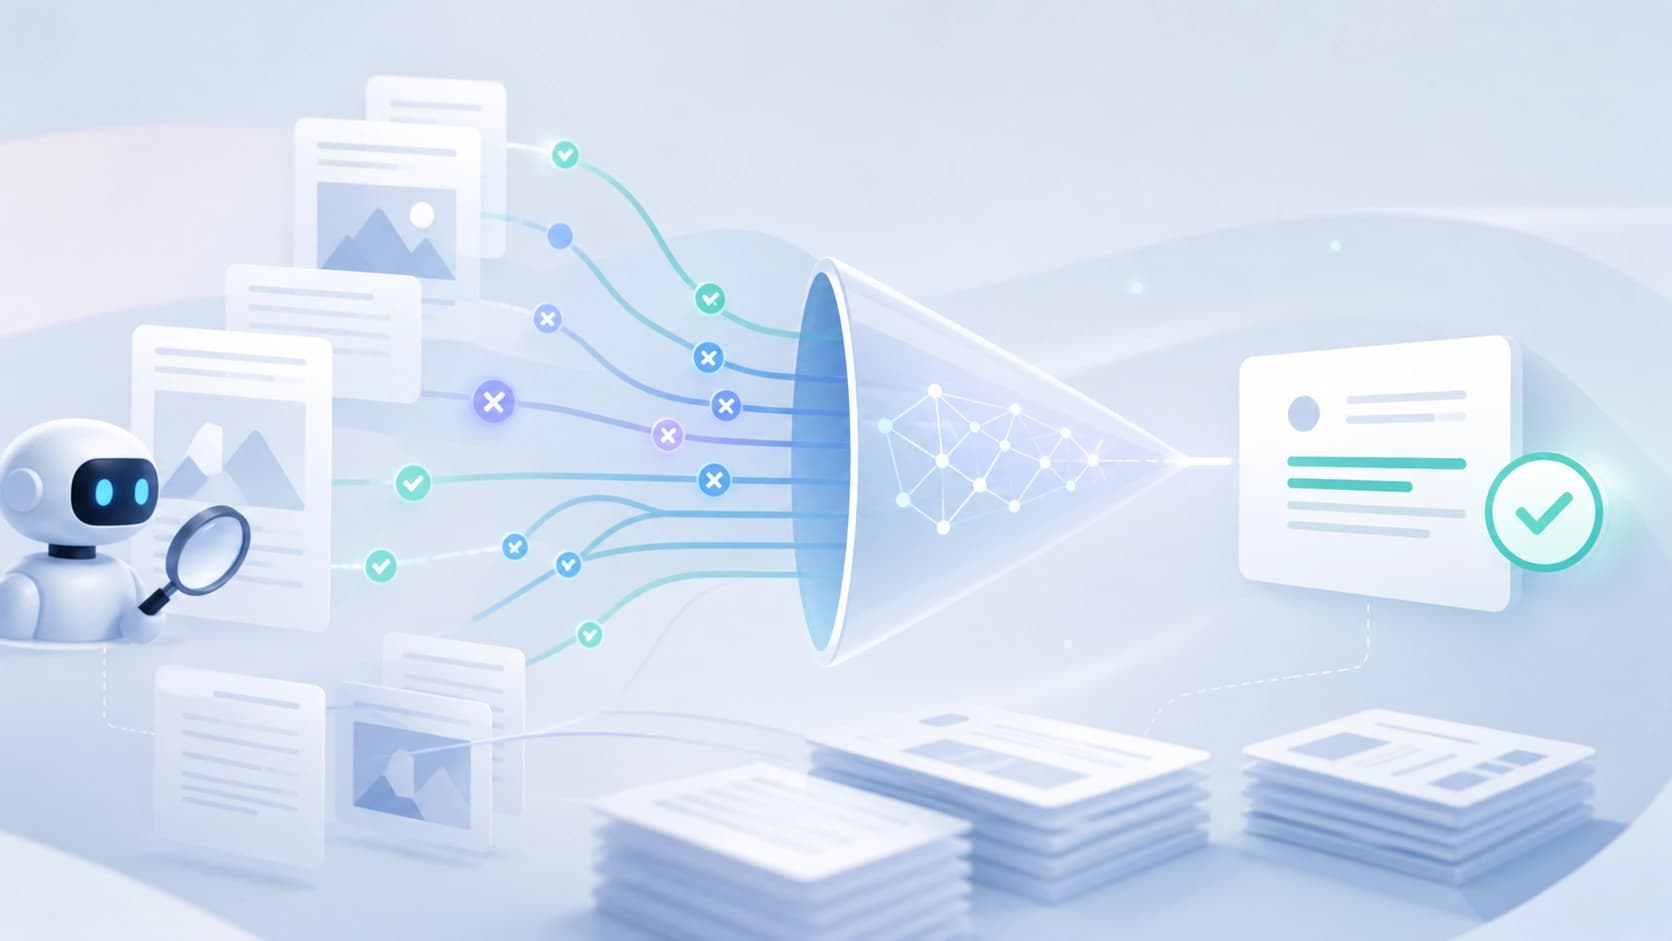
任何自动化的测试合成都很容易变成垃圾生成器。一部分想出来的输入会无效,一部分会彼此重复,还有一部分会从不同角度检查同一种行为。这样的集合带来的有用信号很少,噪声却很多。
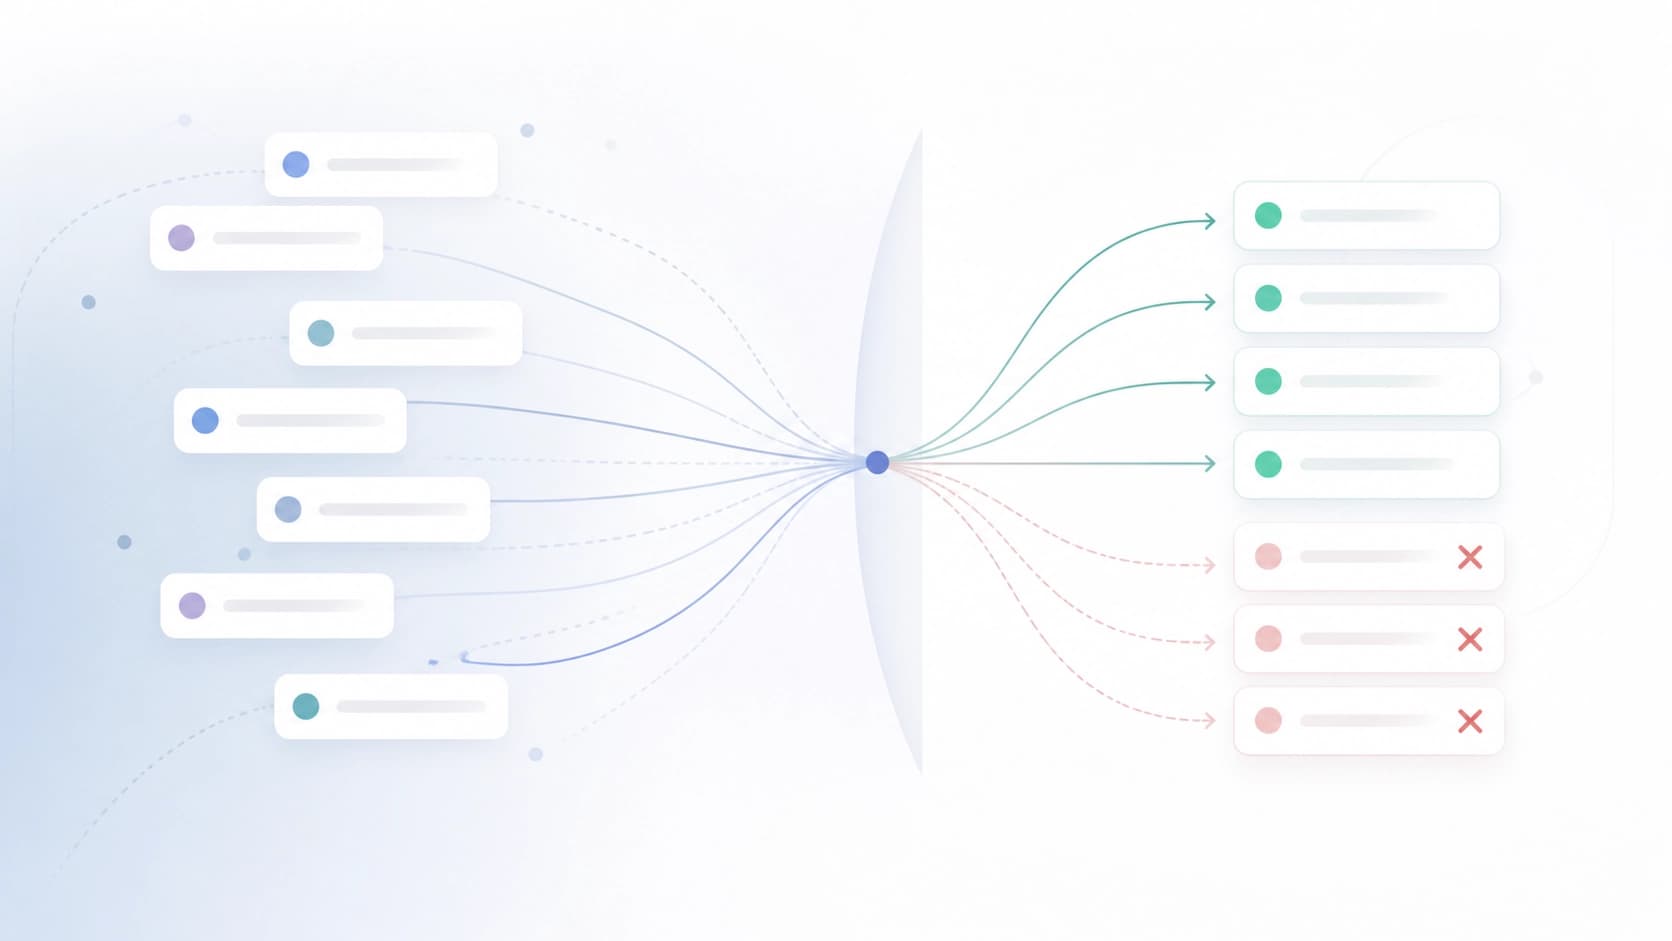
因此在流水线中设置了第二层——验证智能体,用来筛掉不正确和多余的测试用例。在此基础上又加入了按行为特征进行的聚类:测试按它们所区分的具体代码行为分组,组内的重复项被合并。最终留下的是一个紧凑的集合,其中每个元素都带来新信息,而不是重复邻居。
用稠密奖励取代稀疏信号
框架的第二个组件不关乎测试,而关乎如何由测试计算奖励。经典的二值做法——「全过或全不过」——在测试变多且难度各异时效果很差:模型几乎全解出来,只在一个边界情况上卡住,得到的却是和完全损坏的解法一样的零分。学习信号就此中断,几乎没什么可学的。
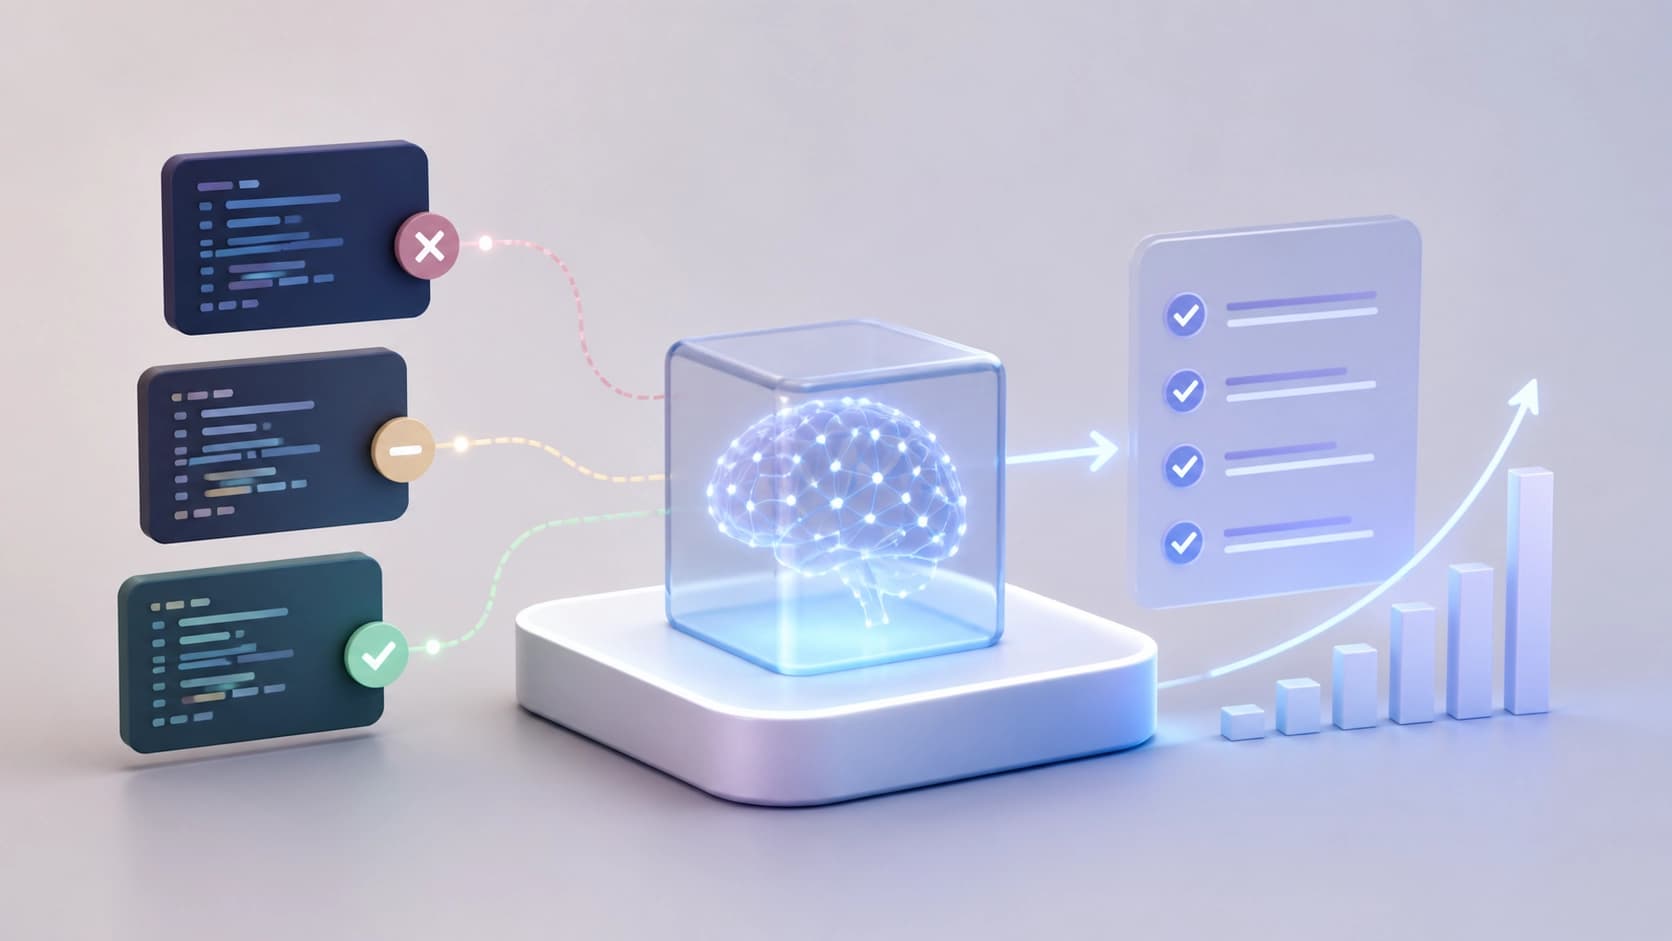
RobustTests 引入了基于通过检查比例的逐步稠密奖励函数(stepwise dense reward)——pass rate。模型获得部分信号,并明白前进的方向:不是「失败」,而是「三十个测试里还剩两个」。这同时解决两个问题。第一,减少假阴性(false negatives)的数量,即正确解法因过于严格或干脆错误的测试而被否决。第二,让训练更稳定:奖励不再是罕见事件,而变成一把刻度尺。
值得单独强调这两个思路的搭配。稠密奖励只有在测试确实能区分不同类型错误时才有意义——否则你只是在平均噪声。而由几乎正确的解法合成测试,若没有稠密奖励,仍会留下同样的信号中断。这些组件是成对工作的。
数据集与结果
在这条流水线上,作者构建了 CodeContests+ 数据集的扩展版本——诊断价值明显更高:测试集能更准确地指出模型究竟在哪一步出错。
关键的衡量指标不是数据集的大小,而是微调后模型的表现。使用 RobustTests 对 Qwen3-32B 进行 RL 训练,在 LiveCodeBench 上取得了 3% 的绝对提升。作者将代码和数据公开了。
这里应当保持清醒。在单个基准上对单个模型微调取得三个百分点——这不是该领域的颠覆,而是一次机制清晰的稳健改进。这项工作的价值更多在于方法论:它提供了一套可复现的配方,说明如何在不手动扩充测试数量的前提下,从测试中榨取更多信号。局限也很明显——结果能否迁移到其他模型、语言和任务类型,仍有待验证。
其中哪些值得纳入自己的实践
即便你不搭建 RL 流水线,只是评估代码生成的质量,这套逻辑也几乎可以原样照搬:
- 从错误出发写测试,而不只是从题目条件出发。 拿一个几乎能跑通的解法,找出它出错的那个输入。这样的测试几乎总比十个「硬想」出来的测试更有信息量。
- 统计通过检查的比例,而不是是否通过。 部分得分在训练和质量分析中都能提供梯度——能看出模型究竟在哪里失败。
- 过滤合成出来的测试。 没有验证和去重,自动生成的集合很快就会变成一堆彼此相似的检查的垃圾场。
- 留意奖励实际上在鼓励什么。 稠密刻度会减少走捷径的倾向,但并不能消除它:如果测试无法区分行为,任何奖励迟早都会被攻破。
RobustTests 所承载的思路,用大白话说很简单:复杂测试的最佳来源不是作者的想象,而是系统自身那些几乎犯下的错误。模型差一点就做对的地方,正是「看起来像解法」与「解法」之间界限所在的最诚实指标。