为什么基于置信度的投票曾经有效
任何围绕大语言模型搭建过流水线的人都熟悉这个思路,它很简单:把同一个任务并行跑多次,然后用多数投票选出答案。但不是"扁平"多数,而是加权多数——每次运行根据模型的内部信号获得权重,最常见的是基于 token 的对数概率。模型更有把握的那个版本,声音比其他的更响。
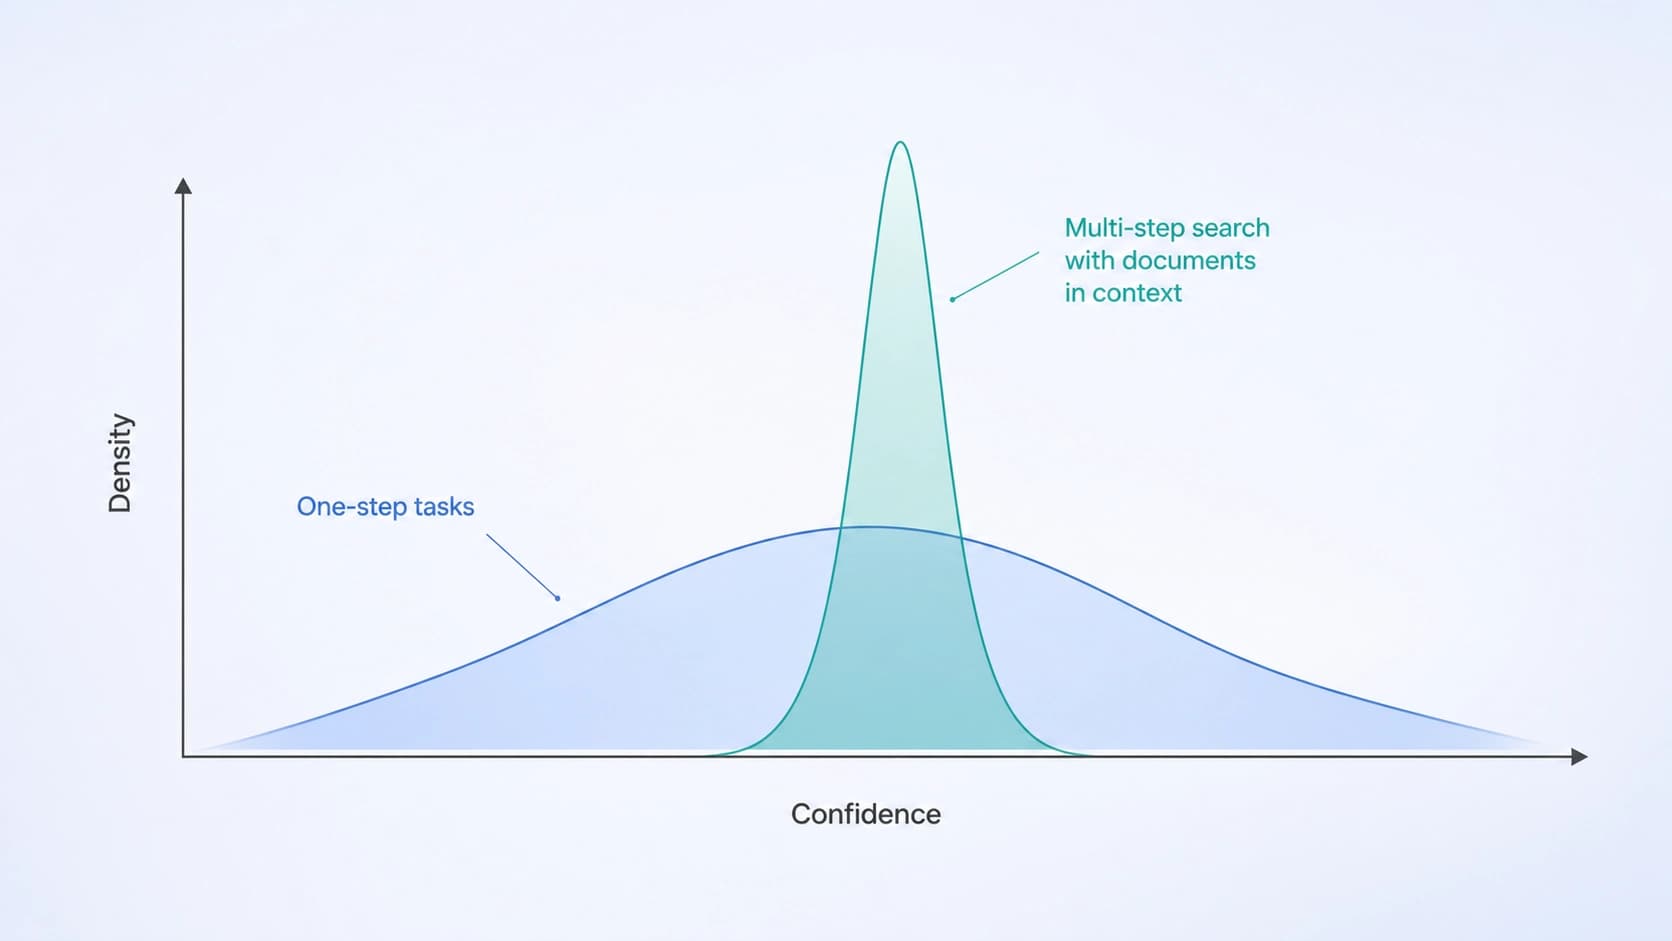
对于单步推理,这套方案表现不错:如果模型出错,它通常会犹豫,而正确答案则伴随着高置信度。对数概率上的差距成了一种内置的错误检测器,既不需要额外调用,也不需要标注,更不需要单独的裁判模型。
它在开始的地方就崩了:多步搜索
问题在于,现代智能体的构造方式不同。它们不是只做一次推理:它们会构造查询、获取外部文档、把它们嵌入上下文、细化查询,如此反复多次,直到收集到足够材料来给出最终答案。每一步都会往模型的上下文窗口里塞进别人的文本片段。
论文《Beyond Confidence: Test-Time Scaling for Multi-Turn Search Agents via Retrieval Grounding》(arXiv:2608.24024,已被 EMNLP 2026 会议 Findings 收录)的作者——Hyunho Kook、Junhyuk So、Tianyu Fu、Haizhong Zheng 和 Beidi Chen——检验了在这种场景下基于置信度的投票会发生什么。结果令人不快:在单步任务上调校好的方法,迁移到搜索型智能体上效果很差。
失效机制:copy inflation
研究者把原因称为 copy inflation——"复制性膨胀"。当检索到的文档进入上下文后,模型从这些文档搬运到自身答案中的 token,会获得系统性地偏高的对数概率。复制是一件轻松的操作:延续就在眼前的文本,在统计上比生成自己的内容更简单。模型对这样的 token"有把握",不是因为它是正确的,而是因为它就是照抄来的。
接下来效应会累积。由于所有运行或多或少都依赖检索到的文档,它们都会分到一份被膨胀的概率。同一个问题内部的置信度评分被拉平,压缩进一个狭窄的区间——于是加权投票失去了它存在的首要意义:区分强运行和弱运行的能力。权重变得几乎相同,聚合退化成普通的多数投票,只是多背了额外的算力负担。
他们提出了什么:Retrieval-Grounded Voting
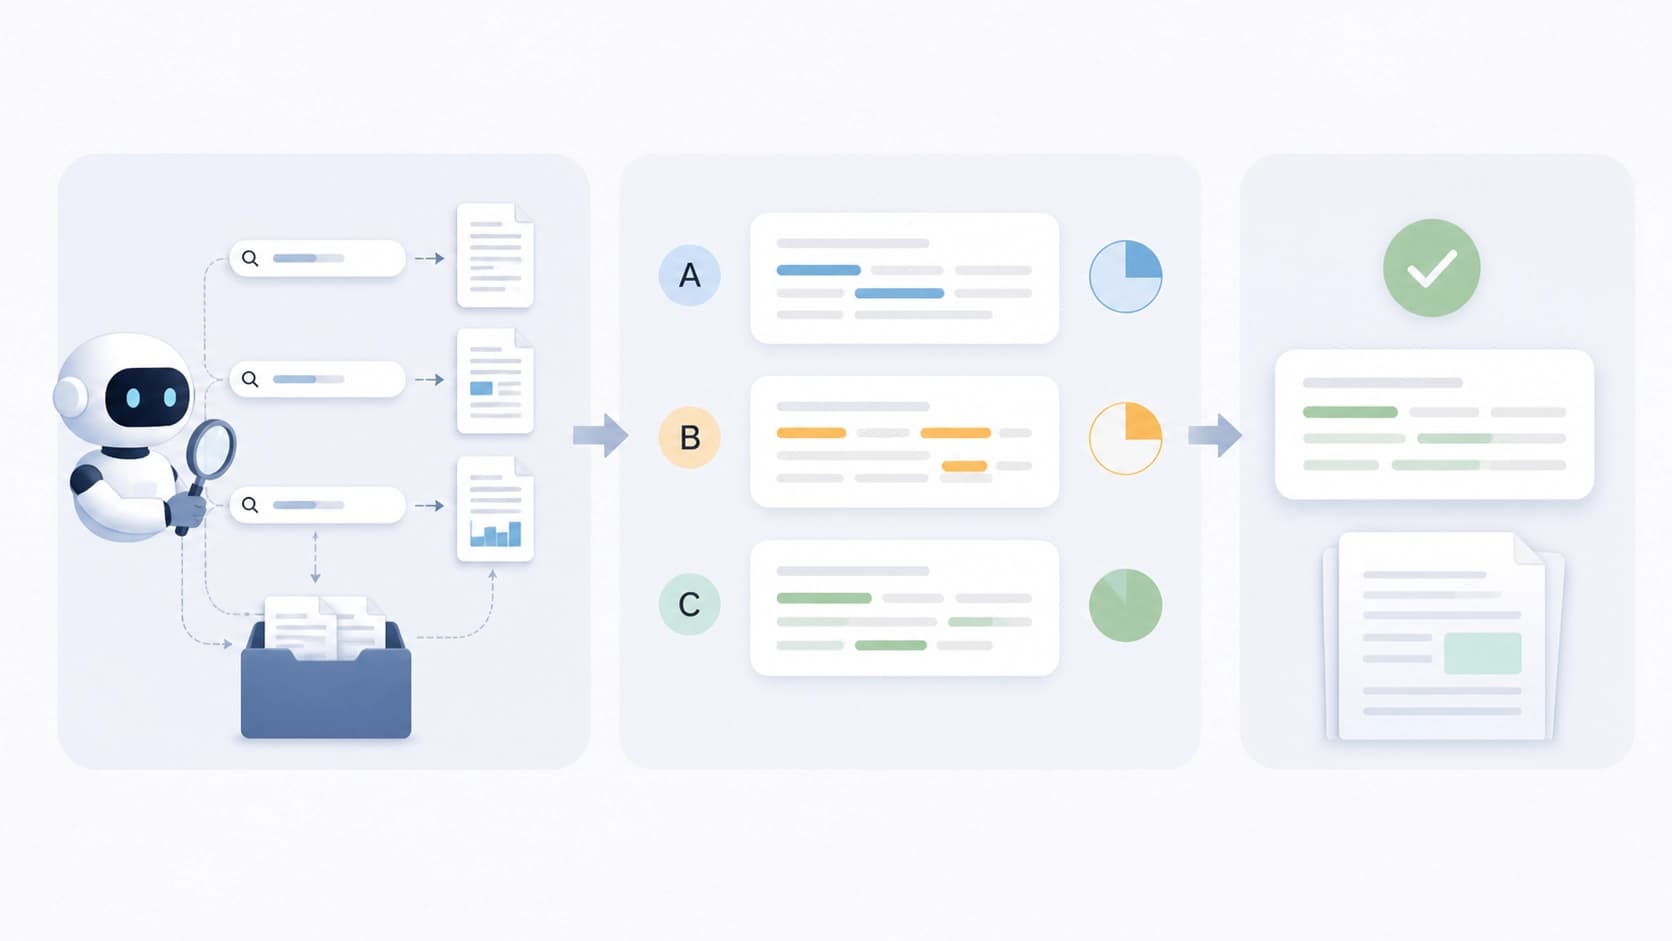
作为替代方案,作者提出了 Retrieval-Grounded Voting(RGV)方法。它同样对每次运行单独评分,但看的不是模型内部,而是外部——看最终答案与这次运行自己检索到的那些文档之间的联系。
这个指标刻意做得很简单:答案文本与检索来源文本之间的词汇重叠度。答案越依赖检索到的材料,得分就越高。那些自己编造内容或跑偏的运行,与它的文档共享的词更少,获得的权重也更低。
为什么这个信号有效
逻辑是这样的:如果智能体确实找到了相关页面并基于它们构建了结论,那么答案的措辞必然与来源的措辞产生重叠——术语、名称、表达方式。这不是正确性的完美标志,但在对数概率已经被污染的地方,它是稳健的。
RGV 的关键优势在于,它是在被污染的上下文之外计算信号的。评分建立在"答案—文档"这一对之上,而不是生成时刻模型的状态,因此 copy inflation 对它没有影响。同时,该方法无需访问 token 的对数概率,也无需额外调用 LLM:没有裁判模型,没有第二轮推理,只有重叠度计算——一种用普通代码几乎零成本就能完成的操作。
结果
实验在四个面向搜索型智能体的基准和五种不同的语言模型上进行。结论反复出现:RGV 稳定地优于基于置信度的投票。
最具说服力的测量是在"minority-correct"问题上,即正确答案只在八次运行中的一两次里出现。正是在这里,基于置信度的加权败得最惨:被膨胀的概率把投票拉向多数但错误的版本。在这类问题上,RGV 带来的提升高达 +35%,整体准确率提升最高达 +5.4%。
这些数字需要附带说明来理解:这不是"给任何搜索系统的质量加五个百分点",而是在模型和运行集合固定的情况下对聚合流程的改进。也就是说,该方法不改变智能体本身——它只是更精细地从智能体已经生成的内容中做选择。
这在实践中意味着什么
如果你正在搭建多步智能体,并且已经在使用 self-consistency 或任何基于概率的投票,那么 RGV 有三个实际优势:
- 推理成本为零。 不需要额外的模型调用,权重是根据已经生成的答案和文档事后计算的。
- 适用于闭源模型。 token 的对数概率并非总是可得,有时甚至完全隐藏在 API 之后。文本比较不受这一限制。
- 调试可预测。 指标是透明的:可以查看哪些词产生了匹配,从而理解某次运行为什么得到这样的权重。
方法可能在哪里栽跟头
弱点从构造本身就能看出来:词汇重叠奖励的是词的匹配,而不是语义的匹配。一个改述过但正确的答案会得到不公平的低权重;数值结果或简短摘要也几乎不会与原文重叠,即使它完全符合原文。反过来的情况更糟:一次只是长篇引用检索内容的运行会拿到高分,却对解决问题毫无贡献。
由此得出的合理策略是——不要把 RGV 当作所有信号的替代品,而是当作一个额外的声音,它在模型置信度失去意义的地方尤其有用。把它与其他类型的校验结合起来也合乎逻辑:语义比较、单独模型评估、事实核查。从任务表述来看,作者们正是朝这个方向走的——从"信任模型的内部感觉"转向"评估它实际做了什么"。
总结
copy inflation 这件事很好地说明了智能体流水线的一个普遍问题:在单一模型、单步推理的孤立环境中调校好的方法,一旦把搜索、上下文和别人的文本加入循环,就会悄悄瓦解。模型的置信度不再是正确性的度量,而变成了复制难易程度的度量。
RGV 提供了一条看起来几乎无聊的迂回路径——计算答案与来源之间的词汇重叠。但正是这种无聊让该方法有吸引力:它便宜、透明、不需要模型的内部信息,并且在正确答案淹没在噪声中的地方带来明显收益。对于用现成 API 搭建搜索型智能体的团队来说,这是一个罕见的有用改进——既不需要重新训练,也不需要新的推理预算。