
具体重复使用的是什么
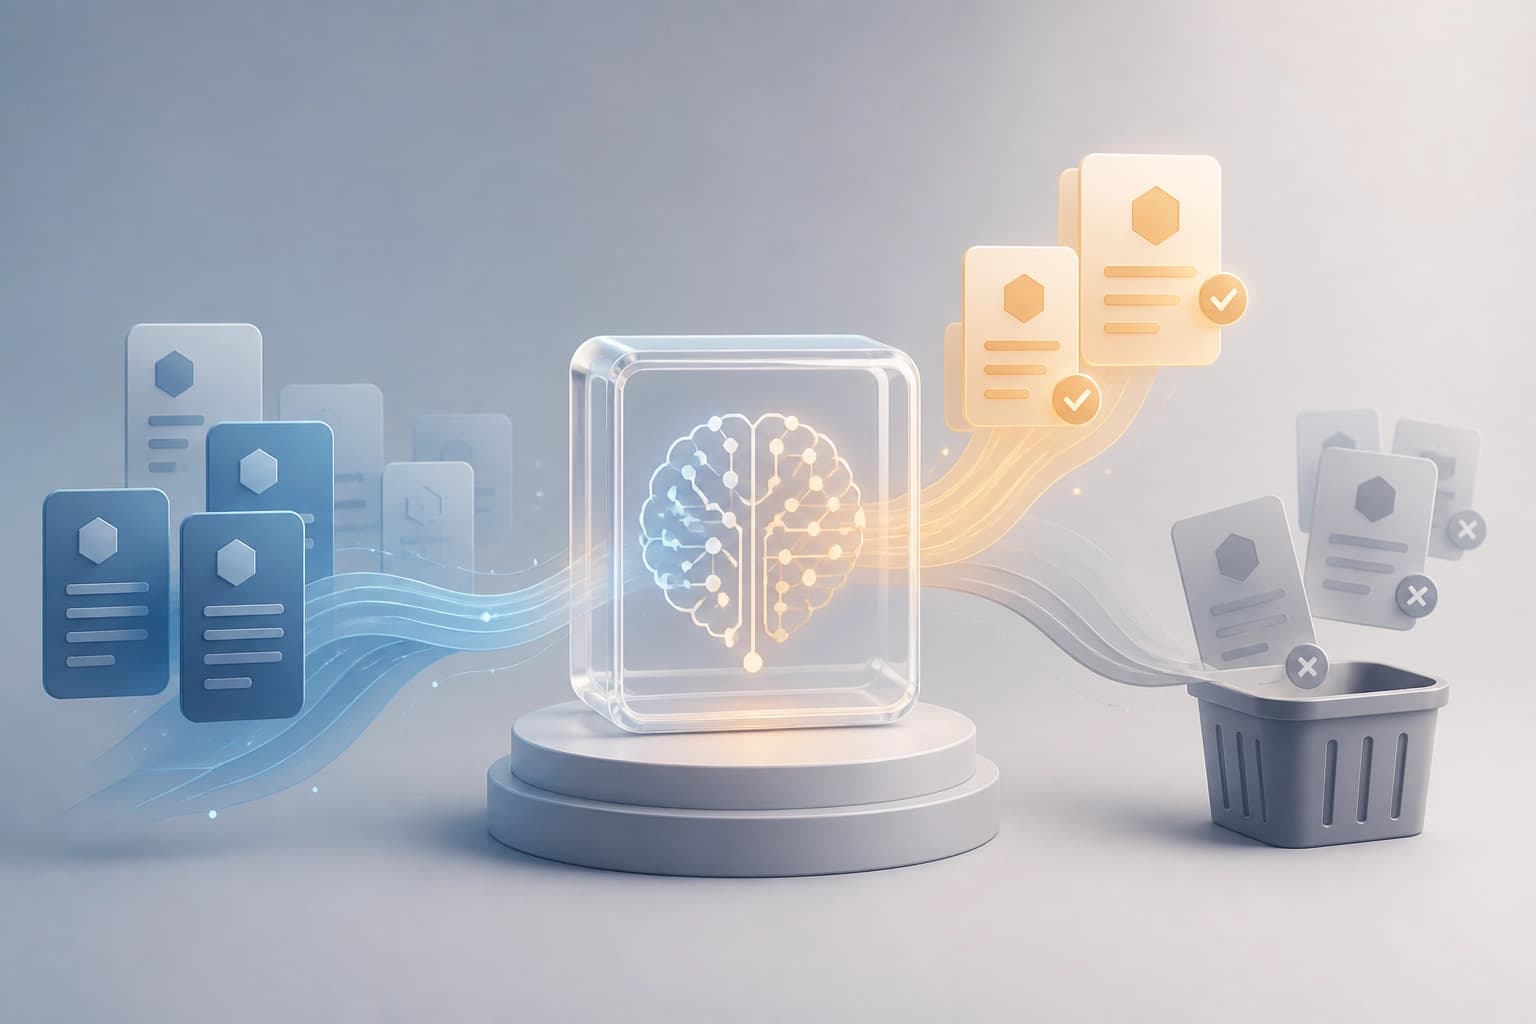
在普通 GRPO 中,每个 rollout 只参与一次 gradient update,之后就会被丢弃。论文中的方法改变了这一流程:它会保存单独的 rollout,并将选中的 rollout 重新用于训练。
缓冲区存储的不是完整的组,而是单独的生成结果。Replay 会根据 advantage 的大小为其分配优先级:数值较大的 rollout 会被重复使用。
实用判断标准:重复使用的是单独的 rollout,而不是组。
Replay 如何运作
每个 batch 分两个阶段构建:
- 其中包含新的 on-policy rollout。
- 再从缓冲区中单独选取 rollout 并加入其中。
选择 replay 条目时,会考虑每个 rollout 的 advantage 大小。所述事实中并未说明 replay 在 batch 中所占的比例。
该方法的关键区别在于:新的 rollout 仍保留在 batch 中,而缓冲区会用选出的生成结果对其进行补充。
如何限制过时程度
作者指出了 naive replay 的问题:LLM policy 会随着每个 gradient step 快速变化。保存的 rollout 可能会过时,并使训练不稳定。
该方法会从缓冲区中删除任何超过 tau_max training steps 的 rollout。这设定了保存期限上限,但并未改变重复使用这一事实。
这里的控制标准是单个 rollout 在 training steps 中的存放时长,而不是其所属的组。
评估结果
研究人员在三个规模的 Qwen3-Base 和五个数学 benchmark 上对该方法进行了测试。该方法优于 GRPO 和 naive replay baselines。
- 在每个规模上,五个 benchmark 的平均增幅均为正。
- 在 4B 规模下,增幅达到 +1.66 个百分点。
- 在 AES(accuracy 和 token efficiency 的联合评估指标)上,该方法是唯一在每个规模下都比 GRPO 表现更好的方案。
实用的选择标准取决于目标评估:结果涵盖 accuracy、token efficiency,以及与两个 baseline 的比较。


