
为什么呈现格式不是实现细节
当我们检验语言模型的记忆或 RAG 流水线的质量时,通常只关心一件事:模型是否找到了所需的事实。而这个事实以何种形式出现在输入上下文中——作为单独的记忆条目、压缩的摘要、带字段的结构化记录,还是原始的一段对话——通常被视为系统的内部事务。逻辑很简单:只要事实在,怎么打包并不重要。
arXiv:2608.23568 预印本的作者们提出不同意见。他们的工作《RENDER: Controlling Reader-Facing Evidence in LLM Memory Evaluation》(Yuan Si, Simeng Han, Daming Li, Jialu Zhang;2026 年 6 月 5 日 v1)直击一个观念:记忆存在唯一诚实且通用的评估方式。相反,他们建议像衡量其他对配置敏感的属性那样来衡量它:固定一个变量,遍历另一个变量的取值。
RENDER 究竟控制了什么
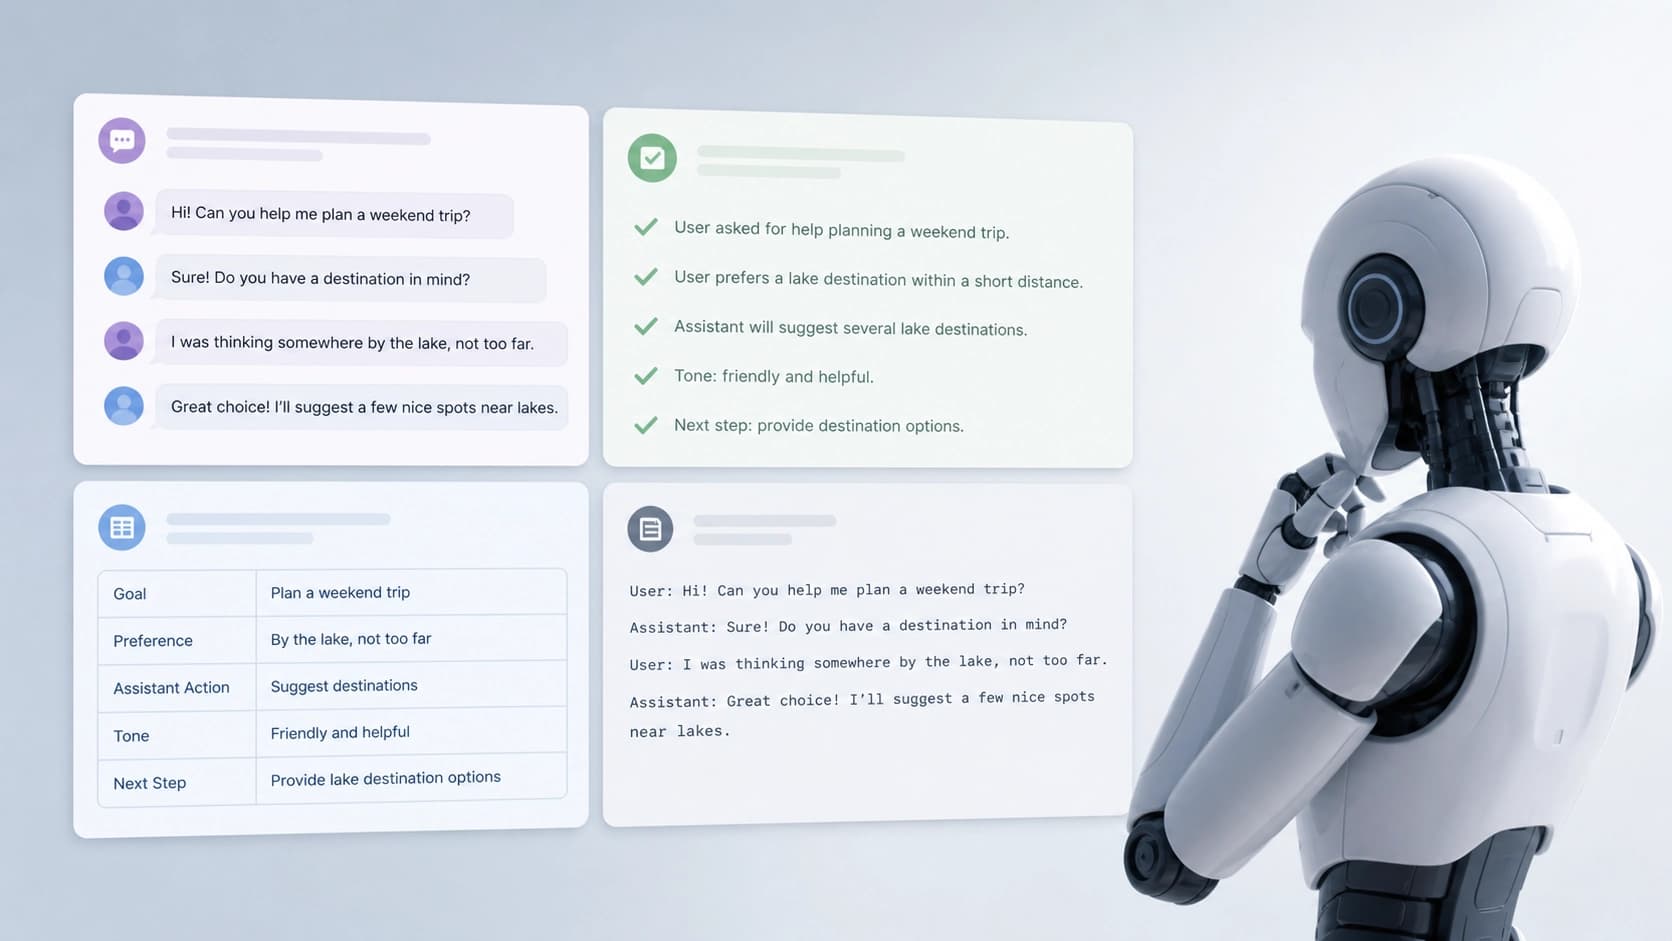
对话不变。变的只是面向读者的产物:即回答模型实际看到的东西。正是这一层——reader-facing artifact——被 RENDER 变成了可控变量。
五级阶梯
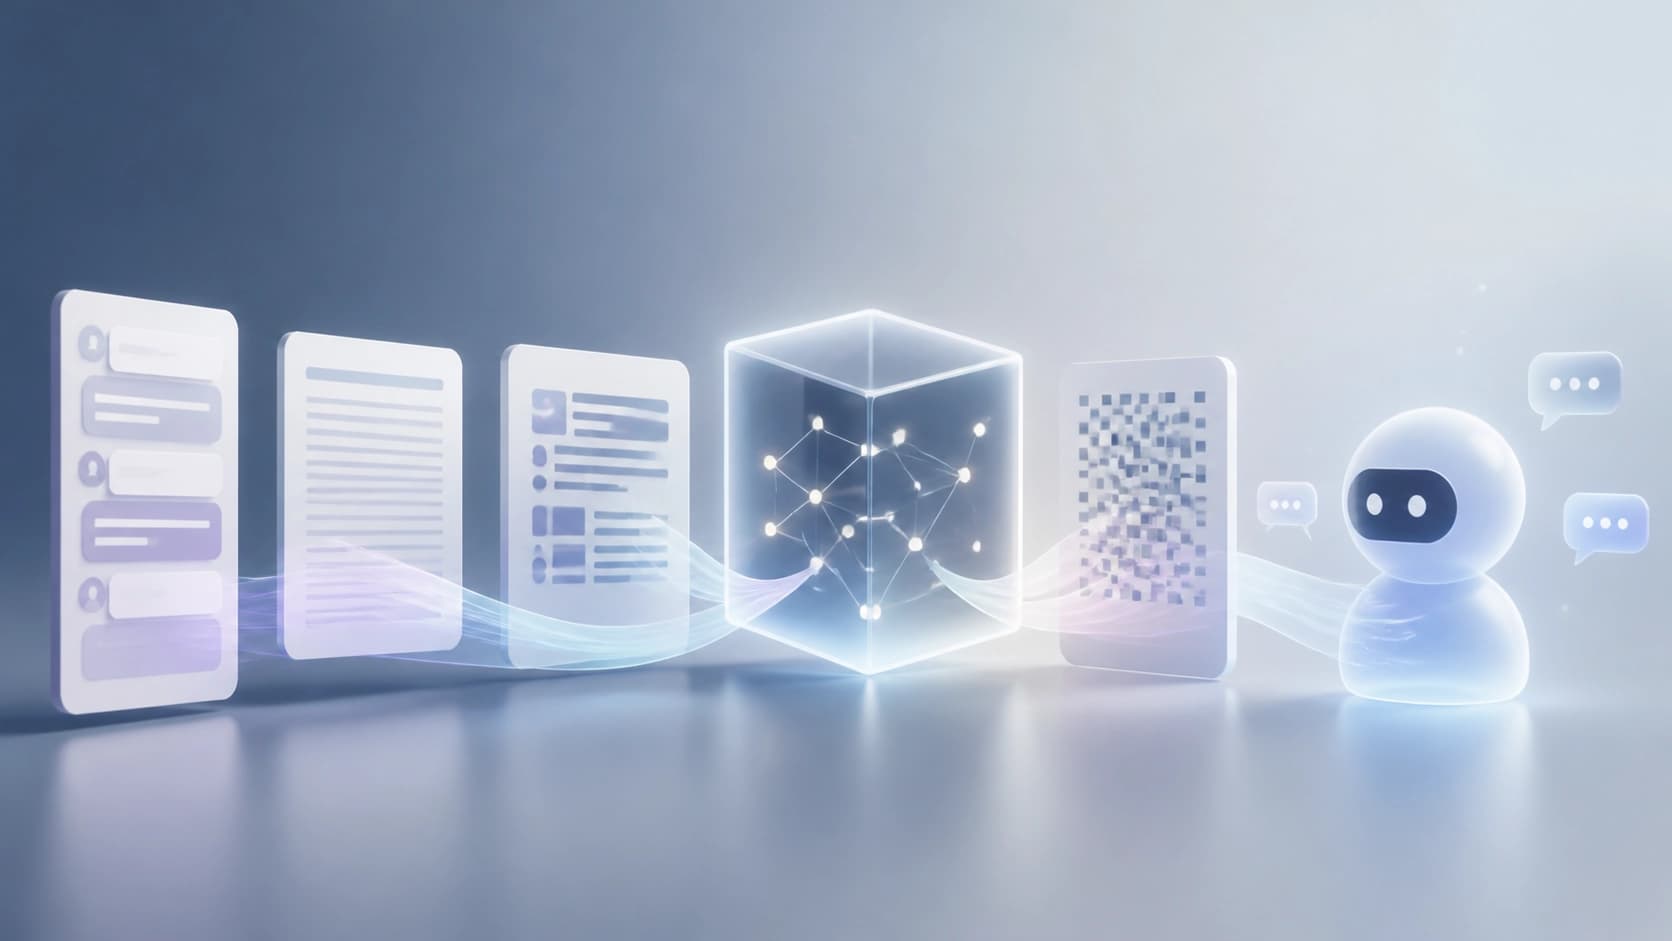
方法的核心是 five-level packet ladder。它不只是一组格式,而是一个标尺,用来定位承载答案的内容进入回答模型输入的那一刻。其意义在于区分两种本质不同的失败:系统没有找到所需事实,以及系统找到了它,却无法以可用的形式传达。没有这样的标尺,这两种情况会合并成报告中的同一行,随后便会产生错误结论——比如认为模型“记性差”,而实际上它只是没能解析打包形式。
四种呈现模板
第二个要素是确定性的模板,用来近似向用户展示历史的典型方式。共有四种:
- ChatGPT 风格的条目——整洁的区块,类似人们在聊天机器人界面中看到的内容;
- LangChain 风格的摘要——压缩的复述,丢失了措辞但保留了要点;
- MemGPT 风格的类型化记录——带字段和类别的结构,便于机器处理;
- 原始对话——原样呈现的发言,没有标记和重新打包。
模板是确定性的:同样的输入每次都产生同样的文本。这一点很重要,否则就无法把格式效应与生成的随机波动区分开来。
数字说明了什么
实验基于 LongMemEval 中的 500 个问题和九个模型。这里值得停一下:这不是一次运行,也不是为了一个漂亮数字而做的一次跑批,而是“模型 × 呈现格式”的网格,正是它让效应得以显现。
主要结果:matched-budget resolved packets 比 recency-truncated raw dialogue 高出 42.4–72.6 个百分点。换句话说,如果把格式对齐到可比的预算,并给模型真正承载答案的内容,那么与最朴素的呈现方式——按新鲜度截断的原始对话——之间的差距不是装饰性的,而是断崖式的。
在 deployed-style 模板中,情况温和一些,但依然很大:最佳与最差格式之间的差距为九个模型中每个模型 24.6–48.8 个百分点。也就是说,在同一个模型内、同样的问题上、同样的预算下,仅仅因为证据看起来的样子不同,就可能“损失”或“获得”几十个百分点。
初次评分中还有一个细节:在 9 个模型中有 7 个,ChatGPT 风格的条目比原始对话获得更高的点估计。这恐怕是对于那些基于“纯净”对话历史构建指标的人来说最不舒服的结论。
裁判也不是终极真理
另一个话题是:如果不用自动评分器,而用裁判模型重新评分(judge rescoring),会怎样。格式的总体正向效应依然存在,但按单个模型看的显著性变得混杂。简而言之:整个样本层面的趋势不会消失,但像“模型 X 正是因为格式 Y 而胜出”这样的点状论断在重新裁判后就不再那么可靠了。
这不是放弃 LLM 裁判的理由,但很好地提醒我们:任何记忆评估本身都是一台测量仪器,对输入格式有自己的敏感度。如果系统和裁判对证据打包的反应不同,那么这种差异可能落入噪声,或者反过来变成虚假信号。
最直观的结果:零对五十
如果从这篇文章中只取一个数字,就该取这个。三个模型在 formal ledger packets 上得分为 0 %,而对同样这些事实,从 natural-language entries 中回答的准确率为 45.4–53.4 %。
不是“稍好一点”,不是“在误差范围内”——而是从完全的零到在相同内容上稳稳命中一半的情况。这样的差距很难用模型知识不足或检索不佳来解释:事实都在,变的只是呈现方式。正式的、机器可读的记录不知为何对模型来说难以逾越,而同样的信息用普通语言表述却能毫无问题地被读取。
对工程师来说这是一个实践信号:如果你的流水线把记忆存成严格的结构化区块,你可能会系统性地低估模型的能力——同时又高估形式化的好处。
这有多稳健
效应在条件变复杂时并未瓦解:在 retrieval noise 下依然存在,也就是当上下文中混入多余片段时。此外,它还迁移到了 HotpotQA——另一个围绕多跳问题构建的数据集。这很重要,因为它消除了“一切都只是某个长记忆基准的特性”的怀疑。
局限性也应牢记:模板只是近似真实的呈现方式,而非逐字复现,而且重新裁判后对具体模型的结论是混杂的。所以这不是现成的配方,而是必须注意到这个变量本身。
在实践中该怎么做
作者的结论相当直接:关于 memory/RAG 的评估报告要么说明使用了哪种 reader-facing artifact,要么明确地控制它。以下是它在应用层面的样子:
- 在测试描述中固定格式。“我们在 LongMemEval 上跑了模型”是不够的描述,如果没有说明历史以何种形式进入输入。
- **至少跑两三种格式。**一个好的和一个朴素的(例如原始截断对话)就足以让你了解系统的敏感度。
- **不要在不同打包形式下比较模型。**20–30 个百分点的差距可能完全属于格式,而非模型。
- **检查你自己的结构化记忆模式。**对同样的事实用普通文本能自信回答,却在正式记录上得零分——这是呈现的 bug,而不是记忆的 bug。
- **单独测试“模型-裁判”通道。**如果评估者本身对格式敏感,指标就会有偏。
- **考虑格式的代价。**摘要和类型化记录能节省 token;现在这有了可衡量的另一面,值得有意识地权衡。
RENDER 的核心观点简单,因而令人不适:不说明证据呈现方式的“模型记忆评估”是不完整的论断。同样的对话、同样的问题、同样的模型,却有不同的答案。差别在于你如何向它展示它应当记住的东西。


