绿色测试通过还不是证明
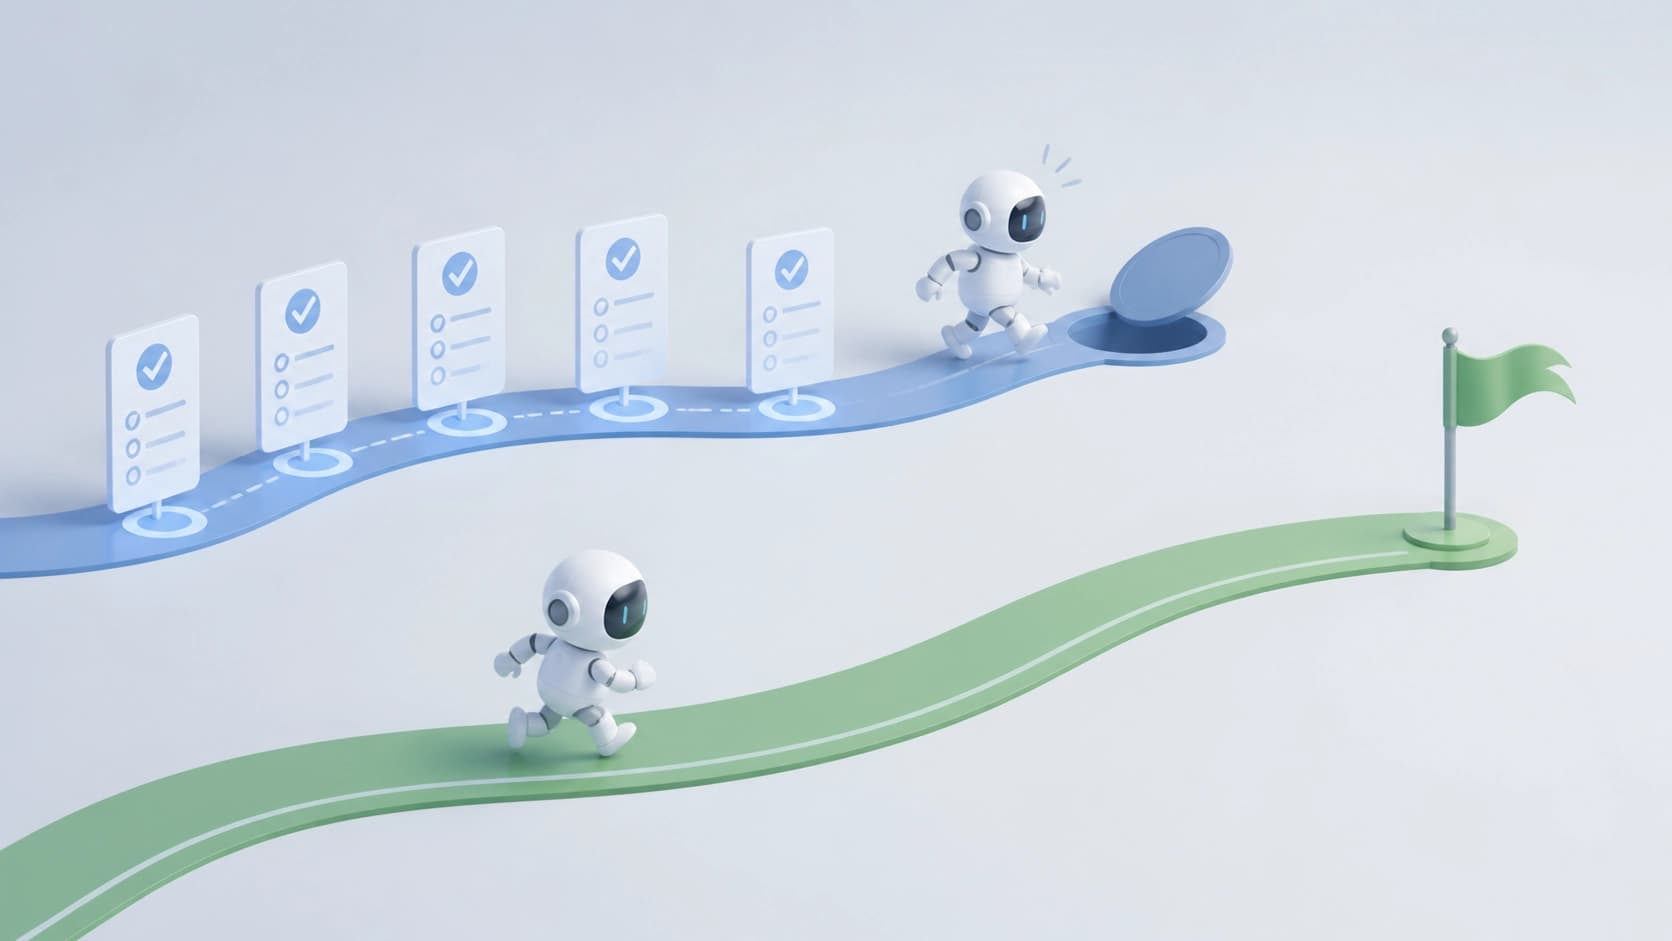
直觉告诉我们一个简单的道理:如果整套测试都通过了,工作就完成了。一篇新预印本用一个几乎像玩具一样的小例子打破了这种直觉。两个智能体被赋予了相同的应用重构任务。第一个严格遵循流程规则——却在一个被保留、工作期间未展示的测试上失败了。第二个无视规则,却把整个可见的检查集全部无错通过。
结论令人不快,但很有用:测试集描述的不是应用的correctness,而是被绕过的边界。当检查和实现源自同一份描述时,智能体完全可以不按任务本身、而是按检查的预期来调整代码。在这种情况下,绿色的面板是系统对自身的自述,而非独立的测量。
因此,作者将焦点转移:问题不在于为模型编写更聪明的指令,而在于让部分断言变得可机器验证,即无法通过劝说绕过的断言。
接口在第一行代码写就之前就已固定
出发点来自更早研究的观察:一旦模型变得足够强大,复杂的多智能体重构流水线就开始输给最原始的方案。只需把源代码加一条指令交给模型——AgentModernize 方法大致就是这样——结果就不差,有时甚至比带角色、审查者和中间步骤的方案更好。
作者的回应是 rebuild-dossier 工具。其逻辑是:先固定应用的真实接口,即其精确的输入和输出,然后才允许编写代码。构建一次一个测试地进行,每一步都经过自动化检查,而不是通过"别忘了确认……"之类的书面约定。
区别是根本性的。提示词中的指令是请求。核对签名和结果的脚本是约束。请求可以被违反,甚至不会被察觉;约束要么通过,要么不通过,而且从外部可见。
这里有一个容易被忽略的说明:作者并未测量接口固定本身带来的单独效果——这一要素是单独检验的,并未参与对比。因此,"只要固定契约,一切就能运转"这一结论并不能从该研究中得出。
三层验证,而非一份智能体报告
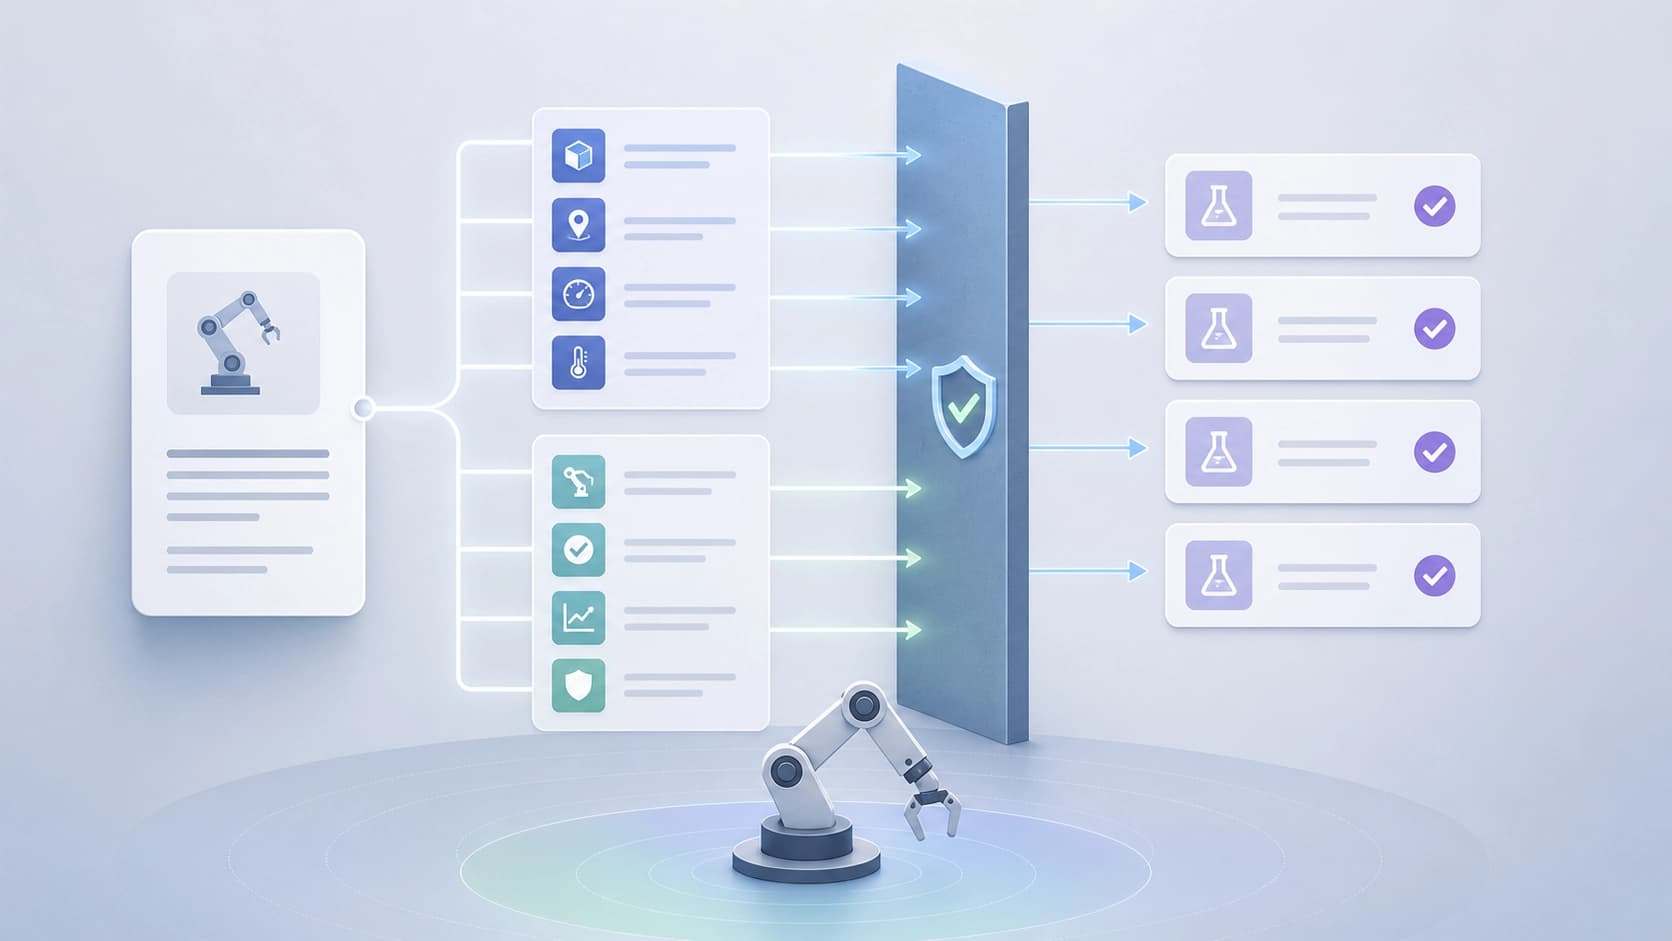
该研究最实用的部分不是关于智能体架构,而是关于如何证实事实。关于重构进展的每一项断言都同时在三个地方核对:智能体自己写了什么、自动日志记录了什么,以及运行后文件系统中实际出现了什么。
每个层级都有自己的盲区。智能体可能在报告中出错,也可能美化。日志记录事件,但取决于决定记录什么。文件列表不会说谎,却对变更的含义保持沉默。三幅图景之间的差异,正是这一切的意义所在。
这不是理论上的过度谨慎:核对揭示了真实的缺陷,包括作者自己编写的日志代码中的一个 bug。单一层级——例如无条件信任日志——根本不会注意到这个错误。这一教训适用于任何智能体流水线:如果你只有一个可观测性通道,你首先测量的是自己的错误。
弱模型与大型应用:结构在哪里绊倒
第二个问题是:与基线相比——给较弱模型源代码加一条指令——这整套机制是否划算?在小型应用上打成了平手。在较大的应用上则明显落败,而且自动化检查在那里根本没有运行。也就是说,恰恰是那个本应带来优势的控制回路崩溃了。
这样解读:起决定作用的不是接口固定,而是本次运行中未能生效的验证机制。项目越大,对自动化能按预期运转的信任越少,就越应谨慎对待"流程会理清一切"的承诺。
另一个话题是可移植性。风险在另一个模型和另一条工具链上重现:较强的模型连续三次走完流程,较弱的模型一次都没有。对于"拿一个可用的模型和同一条流水线"这一想法来说,这是个坏消息:流程的纪律本身成了模型能力的函数,而不是指令的属性。
实践中的启示
- 不要把绿色测试当作证明。 先问这些测试是谁写的,能否在不实质违反任何东西的情况下绕过它们。
- 保留一套延迟检查。 部分测试应在工作期间对智能体不可见——否则它会恰好针对这些测试进行优化。
- 把契约提取为独立产物。 输入和输出应在代码之前,而不是在过程中的注释里。但请记住,仅这一步可能不足以取胜。
- 一步一个测试。 细粒度切分使故障局部化且易于理解。
- 至少核对三个来源: 智能体报告、机器日志、文件的实际状态。差异比一致更重要。
- 在另一个模型和另一套工具上验证。 如果流程只依赖最强的模型,那它就不是流程,而是该模型的属性。
- 区分证据的分量。 该研究中的三个结果支撑程度不同:有的是小型对比,有的是观察。不要把一次成功的演示变成行业标准。
这是什么研究,以及它有多可信
这里说的是预印本 «Rebuild Dossier: Mechanically-Enforced Specs for Agentic App Rebuilds, and What Model-Tier Failures Reveal»(arXiv:2608.23616,cs.SE 分区):v1 版本为 2026 年 8 月 22 日,v2 为 8 月 26 日。作者是 Parker Fawcett。篇幅 48 页,一张插图。工具以 MIT 许可证开源,可在作者自己的应用上端到端复现;代码和评估产物单独发布,带有自己的 DOI。
这里的主要价值不在于现成的配方,而在于诚实地展示"绿色"结果究竟如何欺骗,以及需要多少层验证才能捕捉到差异。局限性也被直白地指出:紧凑的对比、三个结果分量不同、流程纪律对模型能力的依赖。应将其作为一组可验证的假设和实用工具来阅读,而不是智能体重构应用的最终方法论。