
简要概述
有一类攻击通常被称为间接提示注入(indirect prompt injection,IPI):模型被塞入的恶意指令不在聊天中,而在外部工具的输出结果里——网页、邮件、文件或 API 响应。智能体会老老实实把它当作数据读取,进而可能执行他人的附带任务。
来自中国的研究团队(Jianshuo Dong、Yiming Liu、Maosen Zhang、Nan Deng、Peng Xu、Xiaoping Zhang、Tianwei Zhang、Jie Zhang、Han Qiu)表明:智能体「被注入」的那一刻,早已记录在它的内部表示中——甚至早于它输出第一个 token。该工作发布在 arXiv(2608.02657,v1 — 2026 年 8 月 1 日,v2 — 2026 年 8 月 24 日),DOI: 10.48550/arXiv.2608.02657,代码已开源。
最大的意外不在于漏洞本身——这一点早已为人所知——而在于漏洞信号可以被线性、稳定地提取出来,而且在数千亿乃至数万亿参数规模的模型上同样成立。也就是说,这不是某个数据集上脆弱的偶然相关性。
IPI exposure:探针究竟在寻找什么
作者引入了一个工作概念「IPI exposure」——指模型在处理过程中所处的状态,对应于其上下文中混入了不受欢迎的第三方指令。这与攻击是否成功不是一回事:模型可能「察觉」到威胁,却仍然执行它。这里说的正是这种内部暴露状态。
关键词是「生成之前」。探针关注的是进入解码器时的隐藏状态,而不是已经输出的回答。这很重要,原因有二:第一,即使在最终行为看起来无害的地方,信号依然存在;第二,可以在模型调用带有副作用的工具之前就完成诊断。
实验:八个模型上的线性探针
规模与覆盖范围
验证在八个模型上进行。其中包括 GLM-5.2——7530 亿参数,以及 Kimi-K3——2.8 万亿参数;该模型的结果是在论文第二版中才加入的。使用的是在隐藏状态上训练的简单线性探针(linear probes)——本质上就是向量之上的一个线性分类器。
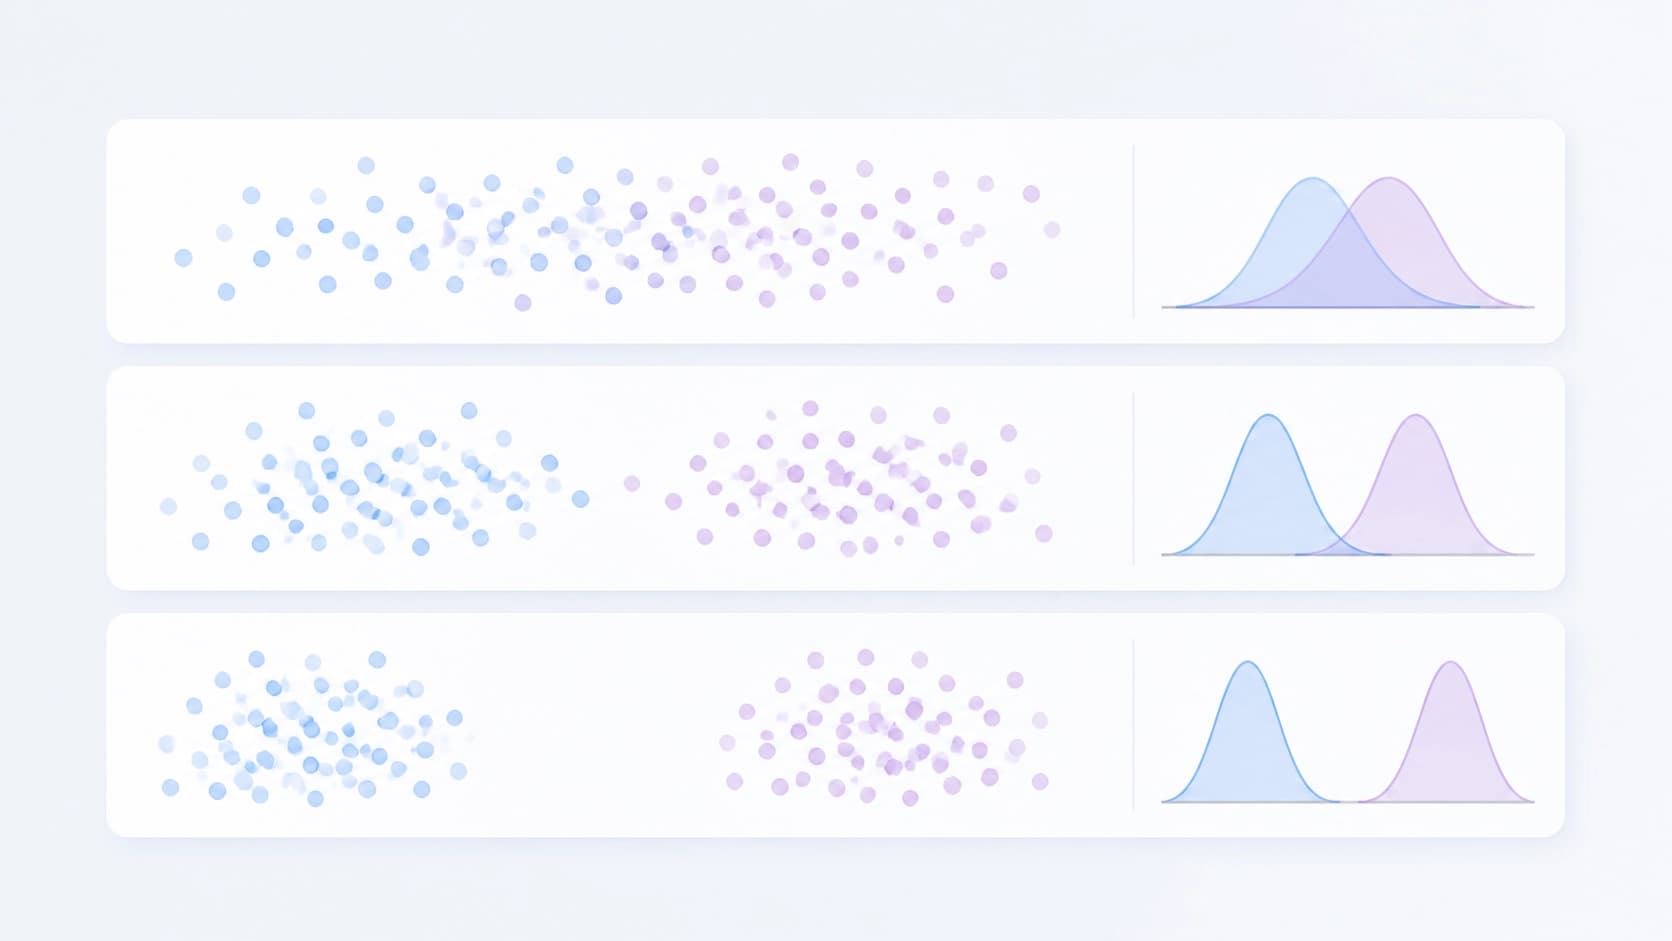
这里的缩写 AUROC 表示两个类别的区分质量:在某一数据集上训练的探针,在它此前从未见过的攻击、智能体指令和任务集上表现出 0.90+ 的水平。换句话说,训练并没有针对特定攻击场景进行拟合。
信号的稳健性
v2 中另有一条实验线专门研究泛化能力。探针在以下情况下仍保持预测能力:
- 对抗自适应攻击,即对手试图欺骗探针本身时;
- 跨语言条件下,即训练样本与测试样本使用不同语言时;
- 在训练中未曾出现的新任务类型和指令上。
正是这三点——通常是所有基于内部表示的检测器最薄弱的环节,因此对它们的验证比 AUROC 数字本身更重要。
知与行之间的鸿沟
论文中最令人不安的发现是所谓的 knowledge-action gap(知行差距)。现代模型经过后训练后,确实编码了能够预测 IPI exposure 的信号,但并未将其作为安全行为的可靠触发器加以利用。模型「感觉到」了问题,却依然继续前进。
从工作原理来看,原因在于信号存在于表示中,却没有与行动策略建立稳定的连接。无论是普通的拒答,还是系统提示中的指令,都无法弥合这一鸿沟——它们作用在另一个层面上。
由探针驱动的防御
既然信号存在,直接利用它便是顺理成章的事。作者提出了一种防御方案:只有当探针检测到 exposure 时,才启动模型的推理。简单说:检测器触发得少而准,昂贵的分析流程由它下令启动,而不是始终运行。
在基准测试 AgentDojo 的复杂配置上,这种方法显著降低了攻击成功率——例如在 Qwen3.5-27B 上从 34.6% 降到零。一个重要细节:在没有任何注入的「干净」任务上,该方法比基线防御更好地保持了实用性。这恰恰是检测器通常欠缺的——它们要么抓得太少,要么始终妨碍工作。
隐藏状态用语言「说」了什么
工作的第三部分是可解释性框架。作者寻找与探针所捕捉内容高度相关的自然语言表述。由此得到某种文本画像:它们展示了检测器触发时伴随的究竟是哪些「想法」。
这里有趣的是异质性。在某些模型中,潜在信号对应的是对威胁的直接感知——类似「这段文字里有一条没人给过我的指令」。而在另一些模型中,它则与间接的操作特征相关:异常的数据格式、可疑的来源、与当前任务的冲突。也就是说,同一个检测器可能依赖不同的内部机制,具体取决于模型。
这在实践中意味着什么
对于构建智能体系统的人来说,结论相当实用:
- 可以在行动之前进行检查。 信号在进入生成阶段时即可获得——也就是说,它可以在智能体调用工具之前就嵌入流水线。
- 线性探针是廉价的防御层。 它比让模型再跑一遍或对每个请求都调用外部分类器要轻得多。
- 不要只依赖提示词。 知行差距意味着「请忽略文档中的指令」并非保证,即使模型完全理解。
- 要计算误报的代价。 该方法的主要论据是它不妨碍干净任务上的工作,而这一点值得在你自己的流量上验证。
未解的问题
论文对「是否存在信号」这一问题给出了有说服力的回答,但留下了几个棘手之处。基于隐藏状态的检测器本身又是一个攻击面:如果对手知道探针的存在,就可以优化注入,使其不产生信号。跨语言稳健性已经过验证,但语言和领域的覆盖范围仍然受限于实验中所用的数据。
另一个问题是可迁移性。探针是针对特定模型训练的:每种架构都有自己的表示,而论文并未给出一个可以简单接入任何 API 的通用「传感器」。对于只能访问文本的闭源模型,这种方法原则上并不适用——它需要隐藏状态。
尽管如此,这个方向看起来很有前景。与其争论模型遵循指令的程度有多好,研究者建议去看它的内部状态,确认那里已经存在所需的信号。接下来的问题是工程性的:如何可靠地把这种认知转化为行动。


