
Liquid AI 开源了 Pipette:如何完整测量设备端推理——从量化到硬件
Liquid AI 与 Artificial Analysis 共同发布了开放平台 Pipette,其衡量单位不再是模型本身,而是整套部署配置:权重、量化方案、运行时以及具体设备。初始数据集包含一千多种此类组合、三十多个模型,以及首批在搭载 Apple Silicon 的智能手机和笔记本电脑上的测试结果。
开源了什么
关于“哪个模型更好”的讨论,几乎总是卡在同一个问题上:数字没人验证过。测量是在另一台机器、另一种量化、另一个运行时构建上做的——把它们放在一起比较毫无意义。Liquid AI 公司提出用开放性和可复现性来解决这个问题:它发布了 Pipette,一个用于在边缘设备上对基础模型进行基准测试的平台。该方法论已由 Artificial Analysis 独立验证。
整个架构所依托的核心观点是:设备上的行为是部署后系统的属性,而不是孤立模型的属性。因此,衡量单位也不应该是“模型”,而是完整配置:权重加量化方案加运行环境加具体硬件。数据集的结构,以及如何解读下面所有对比,都源自这一论点。
初始数据集包含什么
- 五项设备端性能指标;
- 超过一千种配置,涵盖模型 × 量化 × 运行环境 × 设备 × 上下文长度的组合;
- 30 多个模型和多种量化格式;
- 适用于 macOS、iOS、Windows 和 Android 的 llama.cpp 构建;
- 上下文长度从 256 到 8 192 个 token。
首批公布的测量是在 MacBook Pro(M5 Max)、iPhone 17 Pro 和 Galaxy S26 Ultra 上完成的。对于 AMD Ryzen AI Max+ 395 和 Radeon 8060S,结果目前标记为“coming soon”——也就是说,该平台从一开始就宣称是跨平台的,但硬件覆盖范围仍在扩大。
首批运行得出的四个结论
相同参数——长上下文下行为不同
这很好地说明了为什么需要这样的测量。两个 350M 参数的模型,在同一个 Q4_K_M 下、同一部手机上,随着输入 token 增长,表现截然不同:Granite-4.0-H-350M 在从 256 增加到 4 096 个输入 token 时,解码吞吐量保持了 78.4%,而 Granite-4.0-350M 只有 33.8%。参数数量在这里说明不了任何问题:差异在于架构,以及它如何适配具体的运行时和芯片。
稀疏激活节省计算,但不节省内存
LFM2.5-8B-A1B 在同一部手机上、2 048 个输入 token 时,解码速度比 Qwen3.5-4B 快 2.4 倍,比 Ministral-3-3B-Instruct-2512 快 2.6 倍。秘诀在于稀疏激活:每个 token 只动用 8.5B 参数中约 1.5B。但峰值内存占用却是 5.29 GiB,因为所有专家的权重仍然必须完整地放在内存里。实际结论:类 MoE 架构在时间上有优势,但并不能拯救 RAM 预算——而在手机上,限制往往恰恰卡在内存上。
更快——不等于更好
在 iPhone 17 Pro 上,Q4_K_M 下 MiniCPM5-1B 完成 2 048 输入 / 256 输出 token 的负载用时 3.47 秒,而 LFM2.5-1.2B-Instruct 用时 4.12 秒,也就是说前者快 15.8%。然而在相同的测试集上,LFM 在 MATH-500 上高出 9.0 分。吞吐量和质量是不同的维度,仅凭表格里的一个数字来选模型毫无意义。
几乎相同的系统画像可能掩盖任务上的反转
在 M5 Max 上,Q4_K_M 和 2 048 个输入 token 时,Granite-4.1-8B 和 Ministral-3-8B-Instruct-2512 在解码吞吐量上仅相差 2.4%,峰值 RAM 相差 1.2%。但在任务上情况就变了:Granite 在 IFBench 上领先 7.3 分,而 Ministral 在 GPQA Diamond 上领先它 14.0 分。“硬件”画像上的差异在噪声范围内,行为上的差异却是根本性的。
测量是如何设计的
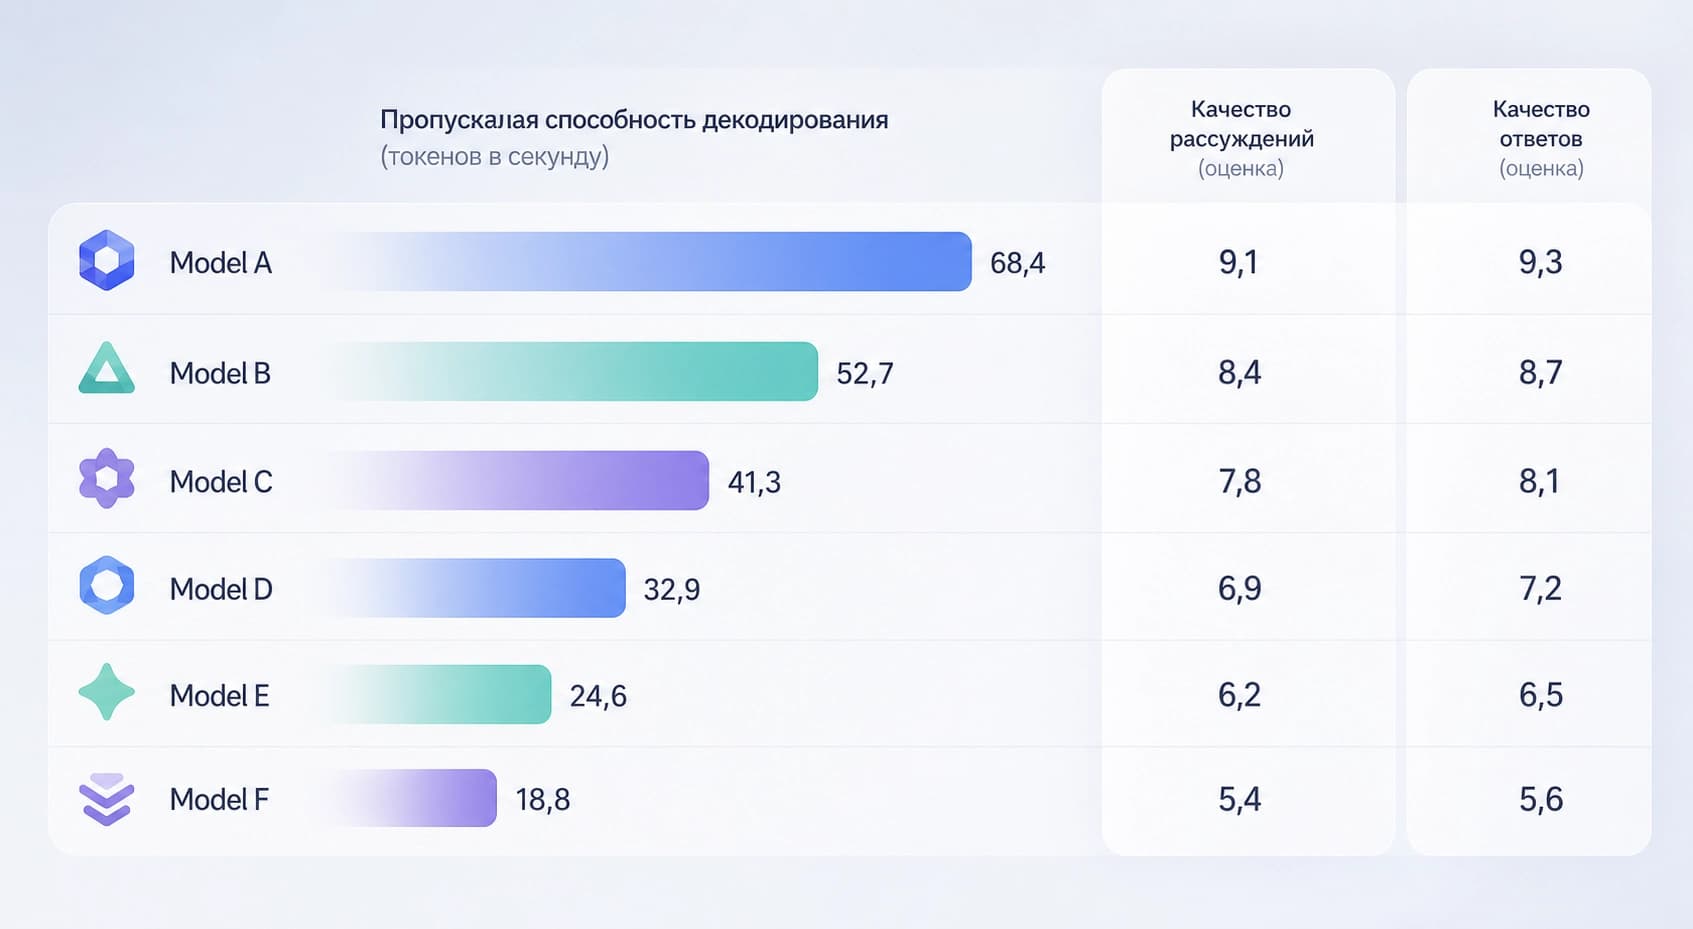
性能运行基于固定的 token 形态、贪婪解码、丢弃的预热和五次可测量重复。每次重复之前都会触发 readiness gating:平台特定的检查会确认热条件和后台负载符合标准。失败的运行不会进入发布——这正是可复现基准测试与一次性脚本的区别所在。
另一个话题是质量。它不是用同一次运行来测量的:为此使用 IFBench、GPQA Diamond 和 MATH-500,评分取自 llama.cpp 在配备 NVIDIA H100 80GB 的参考系统上的评估运行。然后再将它们与同一模型、同一量化在设备上的运行进行对照。一个重要推论:与手机吞吐量并列的那个质量数字,并不是在手机上得到的。这是一个便于模型之间相互比较的指标,但不是对具体智能手机上实际发生情况的测量。
具体开源了什么
Pipette 完整交付,无需等待名单:
- 采用 Apache 2.0 的基础设施——pipette-mgmt、pipette-clients 和 pipette-scores 仓库;
- 公开的结果数据集;
- 托管式仪表盘;
- iOS 和 Android 上的原生基准测试应用。
唯一尚未向公众开放的部分,是社区提交结果的发布:它处于测试阶段。其余一切都可以自行运行,包括在自己的边界内部署整条流水线。
谁需要它,为什么需要
描述目标受众最简单的方式是:任何把模型发布到自己并不拥有的硬件上的团队。接下来,选项按规模分化。
- 独立开发者和种子阶段的初创公司,有仪表盘和移动应用就够了——不需要自己的基础设施。
- 中等规模的产品团队,可以在内部设备群上部署客户端,并得到自己配置下的测量结果。
- 大型 OEM、芯片制造商和企业,可以把整条流水线放在防火墙后面——这就消除了关于测量数据流向何处的疑问。
典型任务也无需多余解释就很清楚:在冲刺任务确定之前选择模型和量化格式;为采购 SoC 或设备提供依据;在运行时、操作系统或驱动更新时捕捉回归;按上下文长度规划容量;独立验证厂商的广告承诺。行业——消费电子和智能手机 OEM、汽车领域、工业和机器人技术、医疗设备、金融服务、国防:凡是延迟、隐私或断网迫使必须在设备上直接运行模型的地方。
在相信数字之前该看什么
在阅读任何测量表格时容易忘记的三件事。
第一,质量数字和性能数字来自不同的地方。吞吐量是在设备上测量的,质量是在配备 H100 的参考系统上测量后再对照的。用于比较模型这是合理的,用于预测具体应用中的行为则不然。
第二,量化不能被排除在外。同一种格式在不同模型和不同运行时上会给出不同结果,而内存限制往往成为决定性的——就像稀疏激活的例子,速度上去了,但 5.29 GiB 并没有消失。
第三,相同的性能并不能说明模型在具体任务上会表现如何。Granite 和 Ministral 在系统画像几乎相同的情况下,在 IFBench 和 GPQA Diamond 上出现反转——正是那种必须先确定任务、然后才去看表格的情况。
常问问题
相关材料
所有材料
仪表板分析中 GUI 智能体的分阶段诊断:DashAct 基准测试
介绍 DashAct:一个包含 348 条经人工验证轨迹的基准测试,将 GUI 代理与交互式面板的工作拆分为三个阶段和四种视觉条件。结果显示,代理在动作预测和视觉目标定位方面存在持续性问题,其响应也依赖于上下文和空间支持。
11 十一月 2026
WILSON:整合患者的放大图像和切片,用于病理形态学分析和报告生成
这篇预印本介绍了 WILSON——一种视觉语言模型,可对整张玻片图像以及同一患者在不同放大倍率下的一系列切片进行编码,而不只是单张“最佳”切片。无需针对特定任务进行微调,它在多项指标上超越了专用且规模更大的切片模型,同时计算负载显著更低;其诊断描述也获得了病理学家更高的评价。
11 十一月 2026
RL 模拟器故障诊断中的规范多项式不变量:它们究竟在何处发挥作用
这项研究检验了将物理定律纳入可训练动力学模型是否合理:从轨迹中提取并通过 Gröbner 基化为规范形式的不变量,虽能小幅提升预测效果,却在诊断方面表现出色——它们能够定位被违反的约束,并找出具体的错误参数。
10 十一月 2026