
始终消耗在新鲜画面上的预算
长寿命的 GUI 智能体就像一个对图像记忆力很差的生物。文本形式的动作历史它几乎可以无限地拖着走——摘要本身很轻。但截图很昂贵:模型的活动窗口里只能容纳寥寥几张图像。由此产生了作者们称之为 budgeted fidelity restoration 的问题。每个事件都以压缩描述的形式保留下来,但固定的预算 B 决定了哪些事件能够重新拿回它们归档的像素。
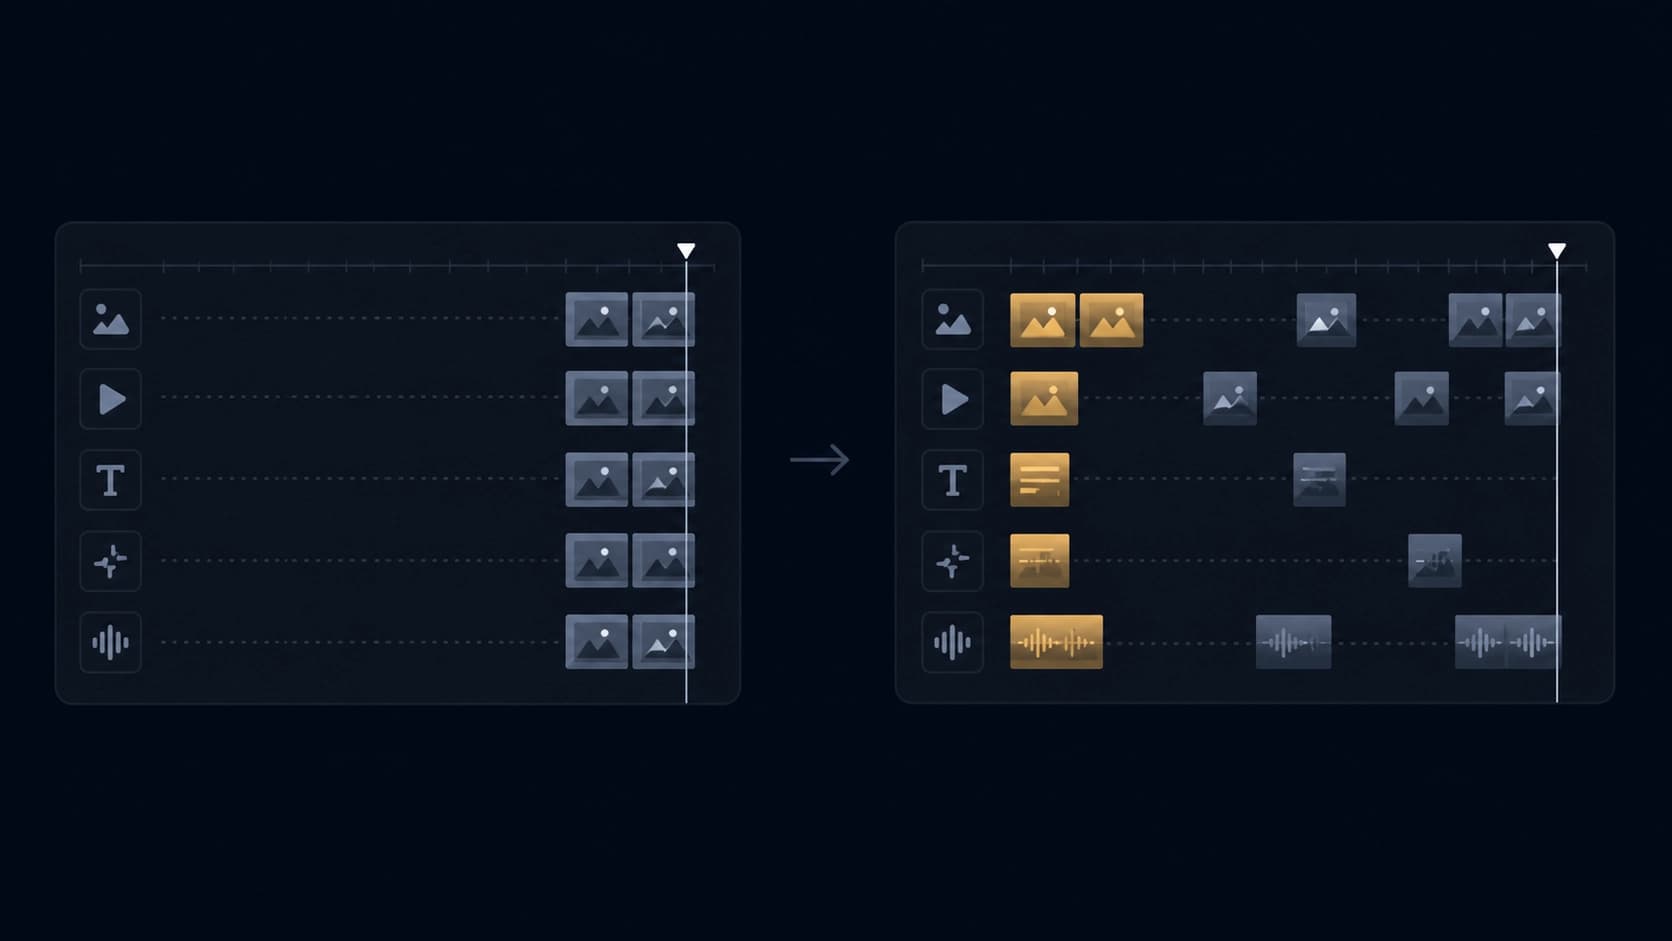
基础版本 Recent-B 用最简单的方式回答这个问题:所有视觉槽位都分配给最近的事件。逻辑上「越新鲜越有用」看起来理所当然,但它有一个盲点——它根本不检查最近的屏幕是否真的比二十步之前的更重要。有时用户切到了另一个窗口,在那里做了些设置,又切了回来——而下一步动作最需要的东西却留在了历史的远处。
另一种筛选原则
CausalCache——这是论文 arXiv:2608.22577 中描述的方法(Jiaxuan Luo、Zhanfeng Liao、Jiayao Teng、Yuan Wang;2026 年 8 月 23 日的 v1,8 月 25 日的 v2 更新,共九页、四张图)。它不采用「最近的全都给」这一规则,而是对整段历史进行评估,并且只有当某个较旧事件的预测效用超过近期候选者的效用时,才把它替换进来。问题不是「刚刚发生了什么」,而是「下一步什么会派上用场」。
一个知道自身定位的适配器
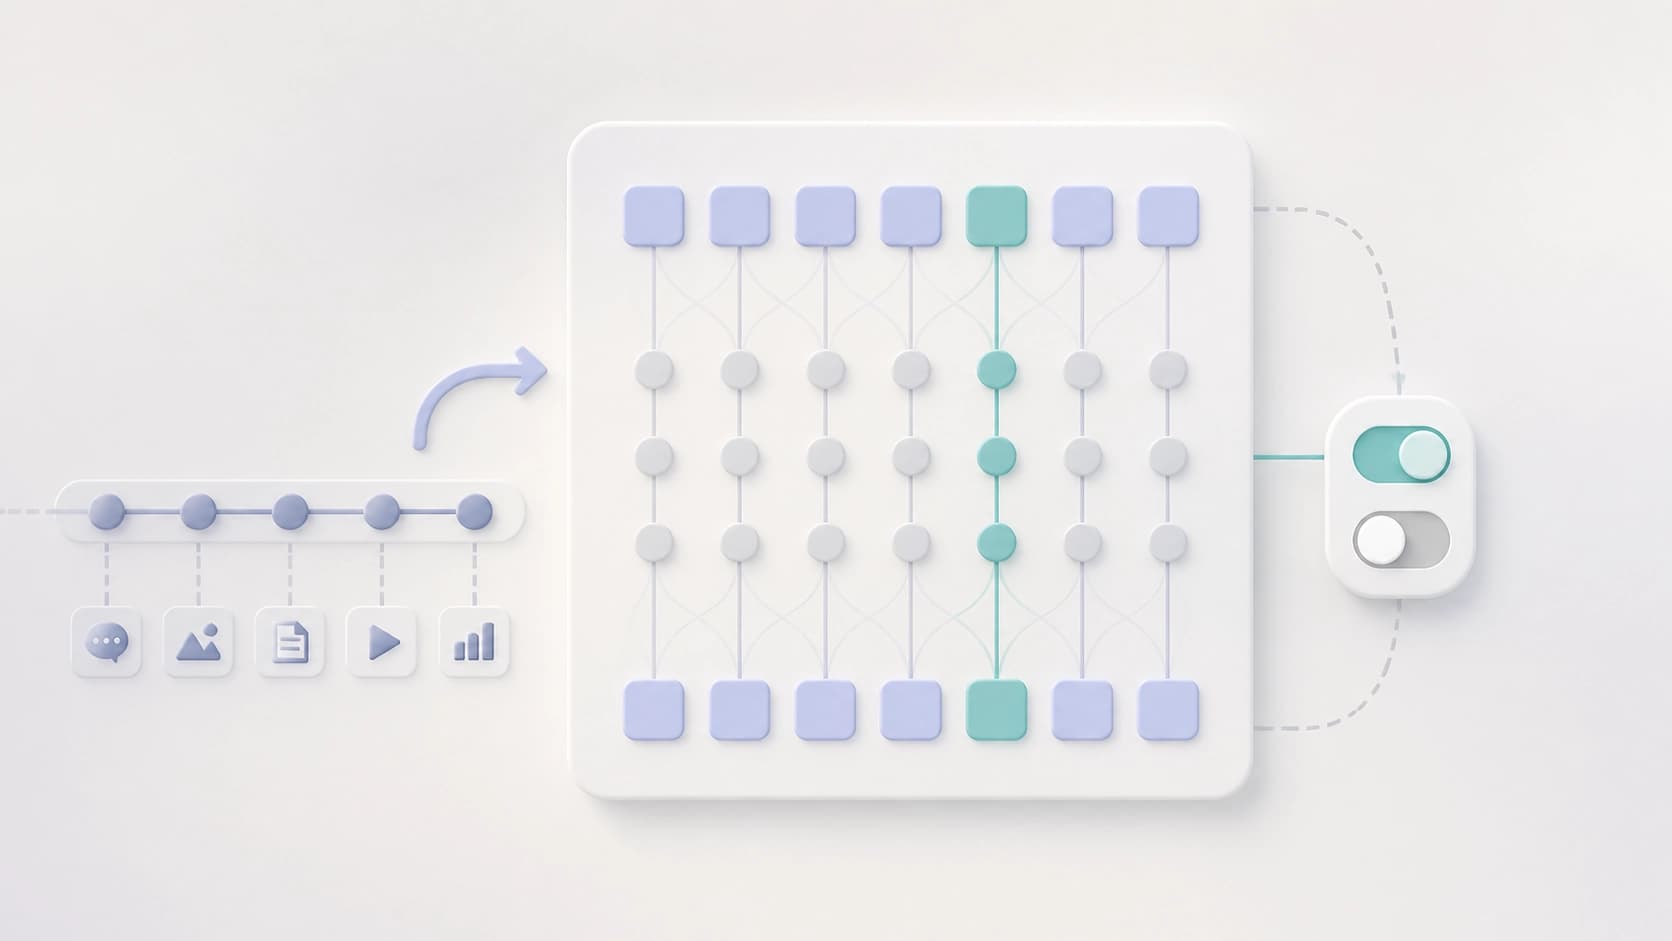
这套构造的另一半是 history-gated key/value 适配器。它只作用于被恢复的历史图像的 token,并且当上下文中没有任何这类图像时会完全关闭。这是一个重要的细节:当前屏幕的处理不会因为系统原则上能够调取旧画面而退化。
选择器和适配器在桌面轨迹上以一致预算下的干预——matched-budget interventions——进行训练,然后在移动端做 zero-shot 验证,也就是完全不为新平台做任何微调。
测量结果说明了什么
桌面端:有收益,但不是立刻显现
在 OSWorld-Verified 上,启用历史截图相比只有文本摘要的记忆,成功率大约提升了 13 个百分点。听起来很可观,但接下来就有细节了。
在官方 15 步的限制下,CausalCache 和简单的 Recent-4 在统计上无法区分。也就是说,在短回合中这整套东西并不划算:历史根本来不及积累出什么有价值的东西,而贪恋新鲜度的筛选方式表现并不更差。但在 30 步的诊断中差距就出现了——46.7% 对 42.4%,提升了 4.3 个百分点。
移动端:无需重训练的迁移
在 117 个 MobileWorld 任务上的 zero-shot 结果为 36.8%,而 Recent-4 是 30.2%。一个在桌面轨迹上训练的方法,在手机上同样胜出——这正是那种说明问题不在于对特定界面过拟合的结果。
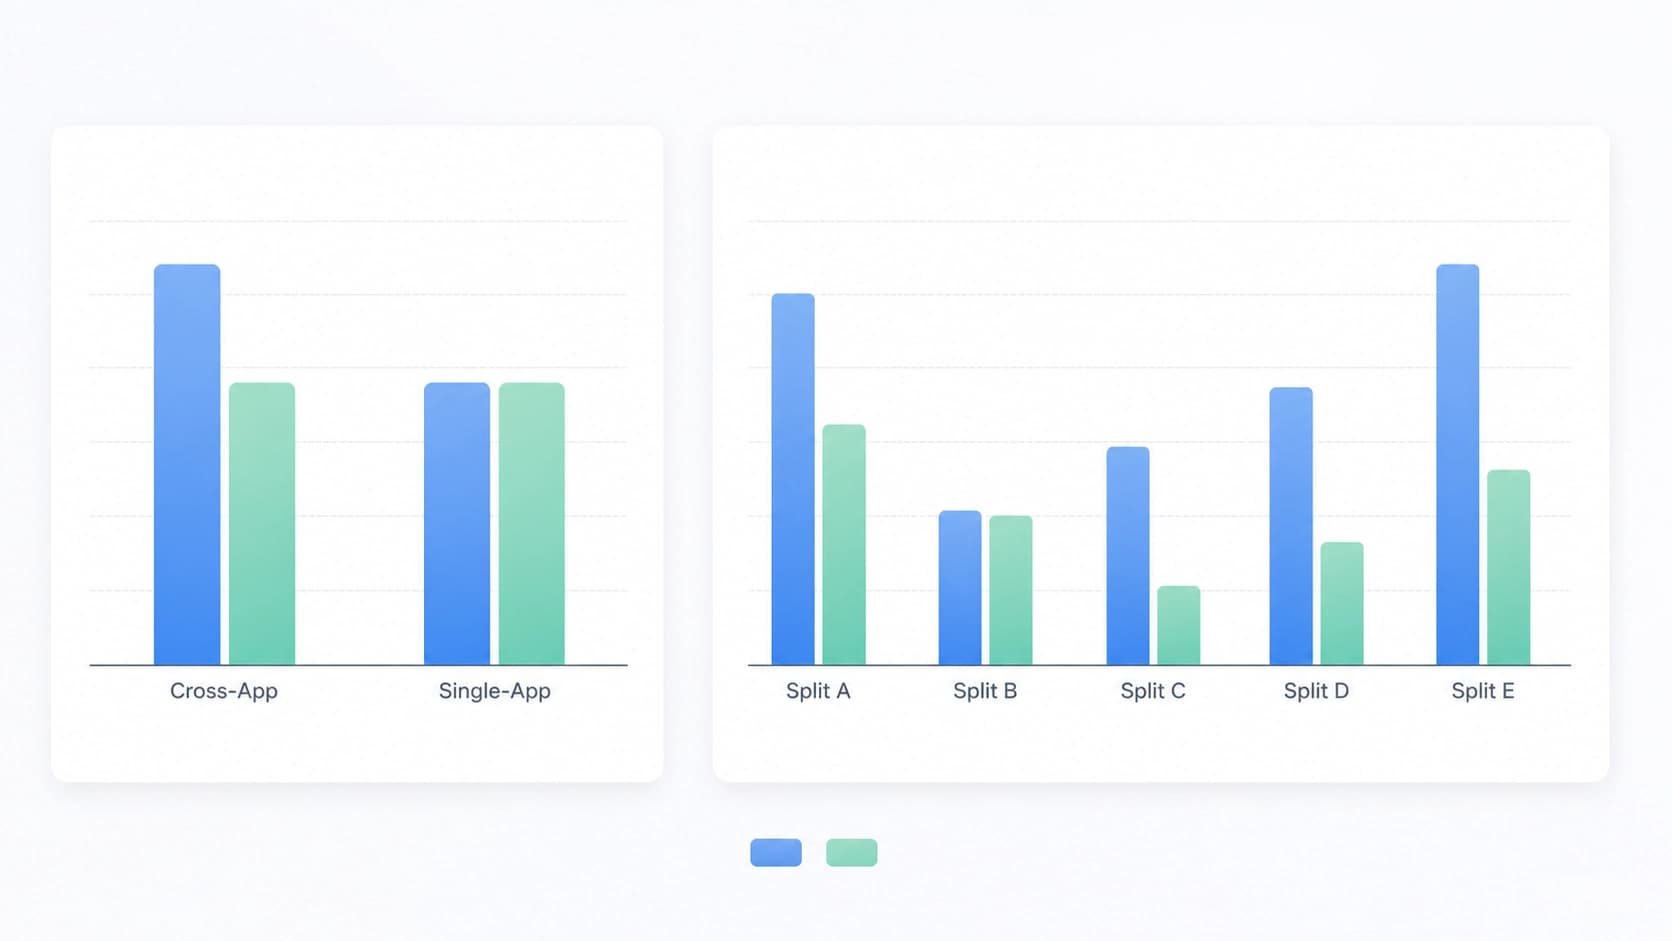
更有意思的是增益究竟落在哪里。它集中在预先划定的 cross-app memory-candidate 划分上:30.6% 对 19.4%,也就是 +11.2 个百分点。在 single-app 的对照组里则完全没有差别——43.6% 对 42.4%。图景吻合了:优势出现在任务要求在一个应用中操作、同时回忆另一个应用状态的地方。
由此可以得出什么
作者们的表述是这样的:选择让哪些过去的事件重新获得像素,比把固定的视觉预算整个花在新鲜度上更有效。在增益恰好集中在跨应用切换任务之后,这一点很难反驳。
但诚实的解读需要两点保留。第一:在短时间跨度上没有差别,这意味着该方法不是免费的改进,而是押注于长回合——只有在那些回合里,积累的历史才有意义。第二:single-app 对照组中的零差异说明,按效用筛选并非普适——它解决的是特定一类问题,即智能体需要把早已离开的屏幕重新带回上下文。
给构建智能体的人的实践结论:新鲜度是一个方便的标准,但不是唯一的标准。一旦图像预算成为瓶颈,就值得问一问,你究竟往里面放了什么——是惯性使然的最近几帧,还是那些在下一步真正会派上用场的东西。


