
PerMIT:LLM 智能体长期记忆的完整性与可机器验证的集体信任
作者提出了 PerMIT 架构,通过有限的内存接口限制环境中的不可信数据影响智能体的敏感操作;两条经 Lean 4 验证的定理以及社区判定结果的累积,在不增加单个用户负担的情况下降低了投毒风险。在 Trojan Hippo 和 τ²-bench 上的实验中,该方案在使用轻量级验证器时未检测到成功注入,并提升了新智能体在留出任务上的表现。
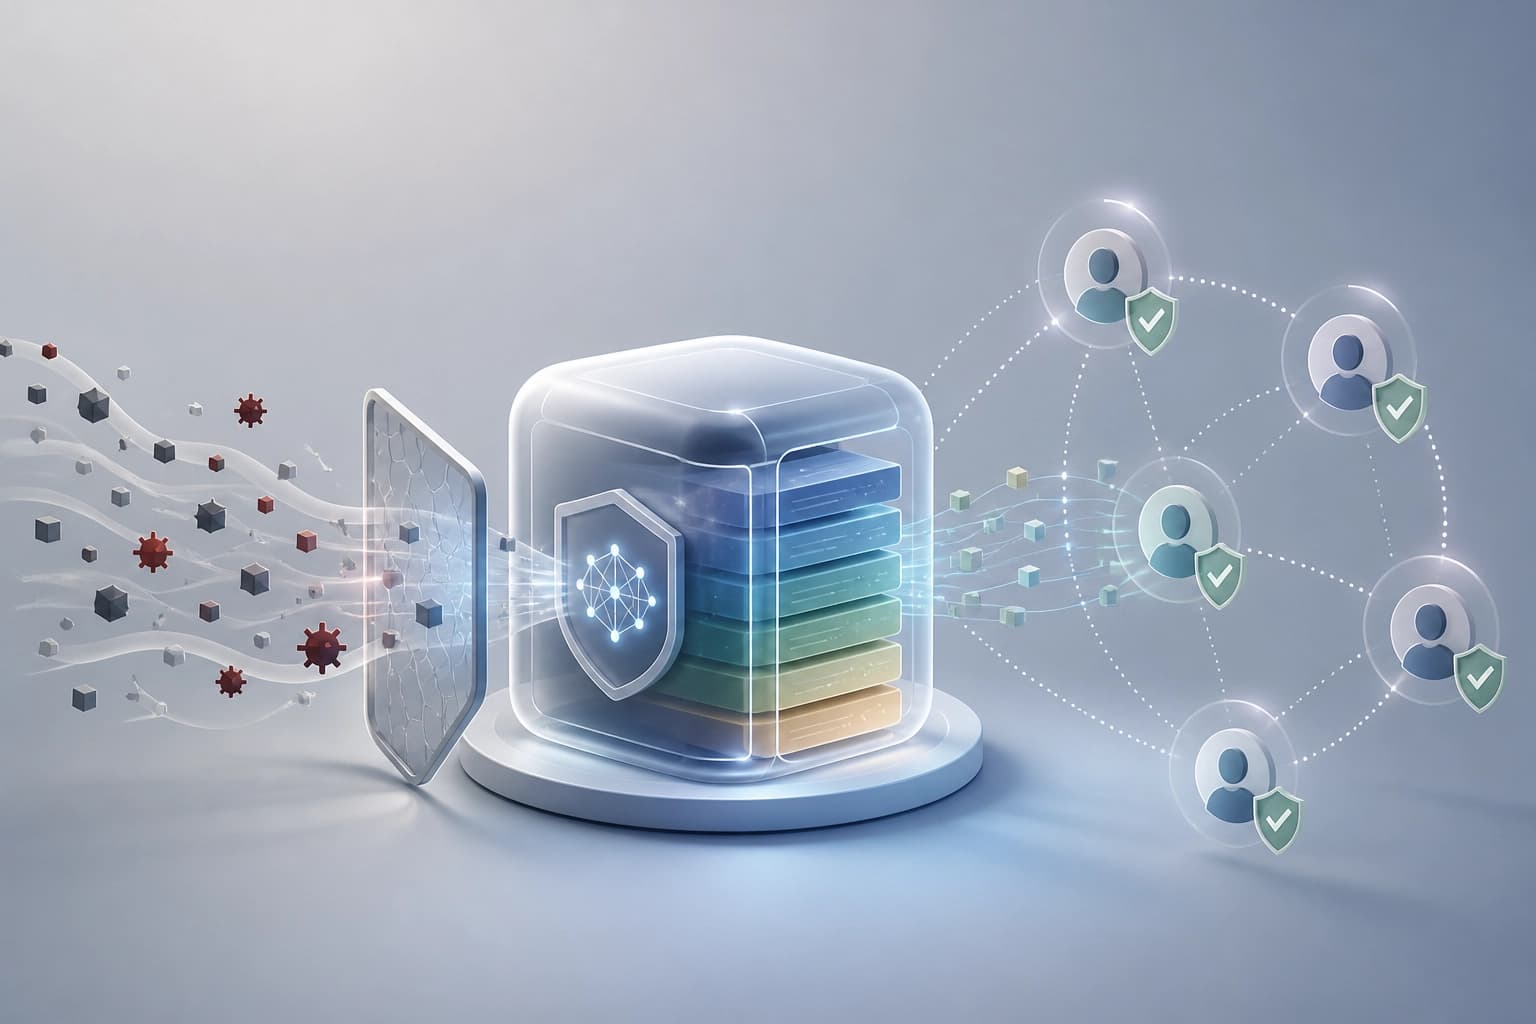
PerMIT — 面向 LLM 智能体的记忆架构。Tanqiu Jiang、Min Bai、Sadat Shahriar、Wanyu Du 和 Sandesh Swamy 撰写的论文,于 2026 年 10 月 20 日提交;arXiv:2610.28987。
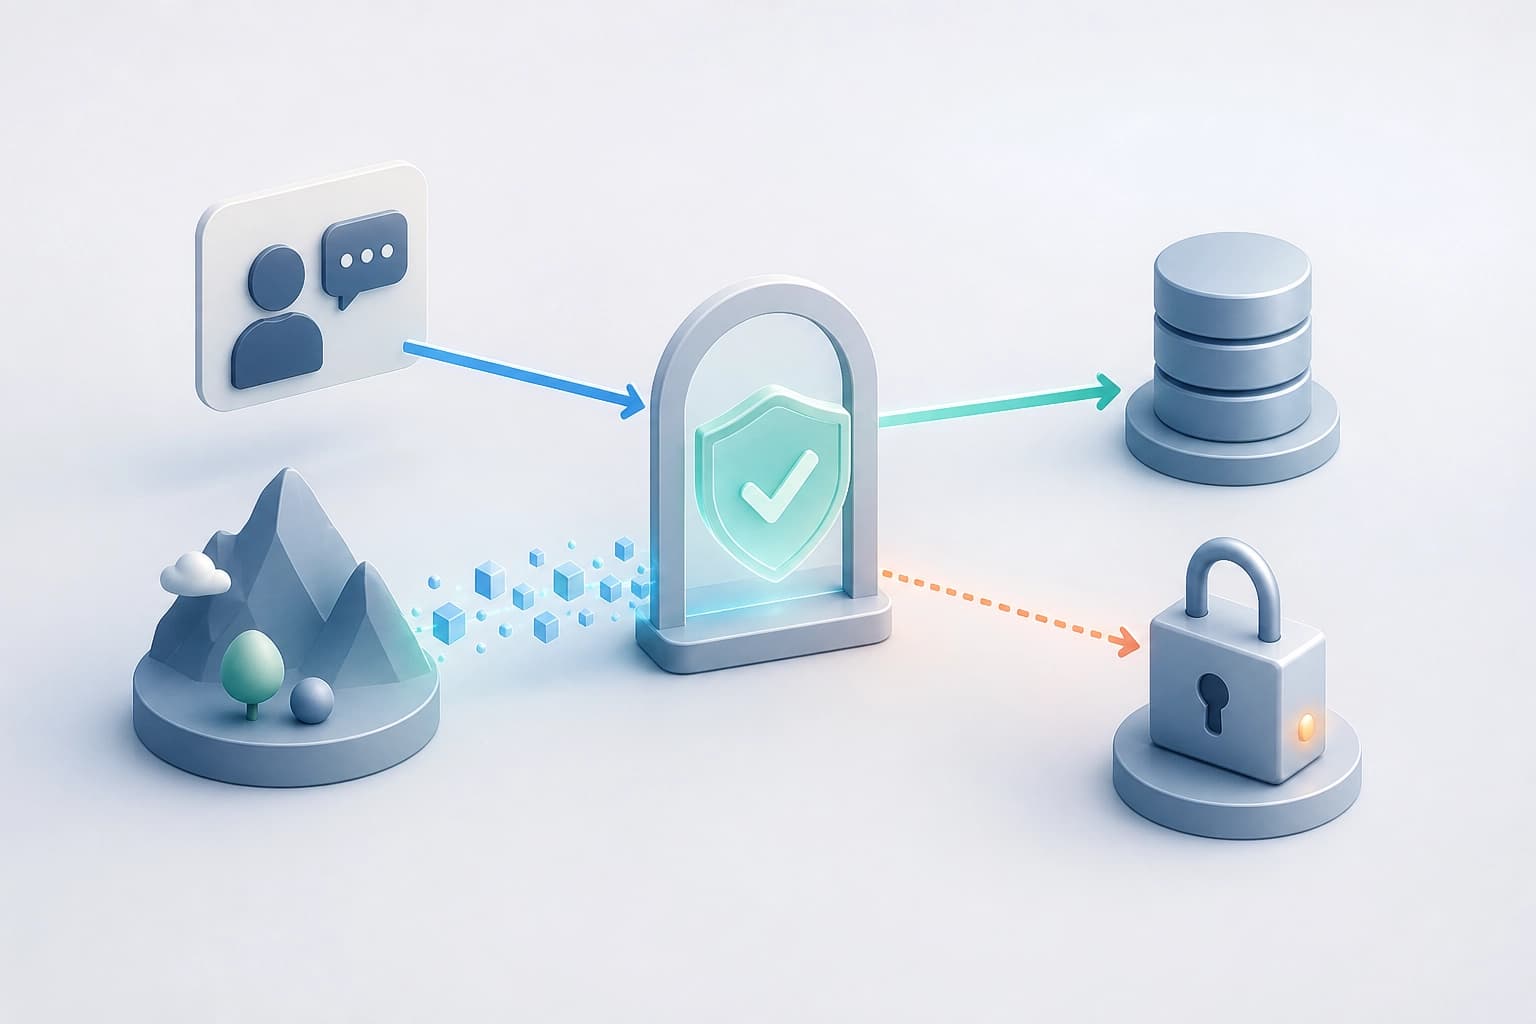
信任模型
PerMIT 设定了明确的信任假设。只有用户输入的数据和经 gate 确认的值被视为可信。所有来自环境的值都仍不可信。该架构通过有限的记忆接口来管理这些数据的传递和使用。智能体的多轮规划和工具选择得以保留。
实践标准:如果用户输入被视为可信,而环境数据不可信,那么该场景就适用。
Gate 与可验证决策
有限的记忆接口依赖 gate。作者证明了该接口的两个完整性定理。这些定理已在 Lean 4 中通过机器验证。它们共同保证两项属性:来自环境的记忆只有在 gate 确认后才能触及敏感操作;智能体行为只有通过 gate 所展示的内容才会发生变化。
在威胁模型范围内,每次攻击都可归结为一个可验证的决策。实践中,这一决策由人类、LLM 验证器或两者共同作出。
实践标准:如果威胁模型中的攻击可归结为一个可验证的决策,那么这项防护就适用。
确认与集体信任
每项确认都是针对确切内容记录的判定。确认会在用户之间累积。获得足够支持的条目无需进一步检查即可成为社区确认内容。
在明确的假设下,作者证明了一项协同扩展属性。他们也通过模拟对其进行了验证。随着社区规模扩大,投毒数据被推广的风险和良性知识被错误删除的风险都会降低。单个用户的验证工作量不会增加。
| 社区扩大时的变化 | 趋势 |
|---|---|
| 投毒数据被推广的风险 | 降低 |
| 良性知识被错误删除的风险 | 降低 |
| 单个用户的验证工作量 | 不增加 |
实践标准:当判定针对确切内容,并在用户之间累积时,集体层就适用。
测试
在 Trojan Hippo 上,PerMIT 的可观测攻击成功率为零。该结果是在自检和使用轻量级验证器的情况下获得的。
在 τ²-bench 上,最多 90 个自主智能体组成的社区借助 PerMIT 创建共享知识库。没有任何直接记忆注入被推广。由此获得的知识显著提升了新智能体在留出任务上的表现。
实践标准是两个结果:直接注入没有被推广;新智能体在留出任务上的表现有所改善。
常问问题
相关材料
所有材料
用于头颈部肿瘤质子治疗计划的循证闭环复合多智能体AI系统
该研究描述了经过训练的 PPO 策略与 LLM 智能体的结合:前者生成多个计划选项,后者通过对话进行 уточ уточ(临床指标与约束条件核验);在 21 名患者的数据上,经过微调的 Qwen3-14B 更能遵循指令,并有助于使权衡偏向优先目标。实践结论是,自动化 DRL 规划可以通过可控的对话加以补充,同时保留对相互竞争约束的掌控。
20 十一月 2026
以计算筛选取代经验试错:电池材料的新方法
本文介绍了计算数据库、机器学习和生成式模型如何缩小有前景配方的筛选范围,以及自动化实验室如何加快验证;但最终结果仍取决于合成与测试,预测值可能与实际电导率不符。
20 十一月 2026
随着任务池规模扩大,智能体基准测试的演进:证据筛选与顺序竞赛的作用
这项研究解释了为什么增加任务数量可能会阻碍智能体基准的演进:问题在于证据选择不当,而非数据量本身。所提出的 Successive Scale Racing 通过轮流挑选多样化的任务组合,并以较低成本比较候选方案;在三个基准测试中,随着任务池从 40 个扩大到 200 个,成功运行的比例有所提高,而基线方法则表现退化,验证运行次数也减少了约 60%。
19 十一月 2026