
随着任务池规模扩大,智能体基准测试的演进:证据筛选与顺序竞赛的作用
这项研究解释了为什么增加任务数量可能会阻碍智能体基准的演进:问题在于证据选择不当,而非数据量本身。所提出的 Successive Scale Racing 通过轮流挑选多样化的任务组合,并以较低成本比较候选方案;在三个基准测试中,随着任务池从 40 个扩大到 200 个,成功运行的比例有所提高,而基线方法则表现退化,验证运行次数也减少了约 60%。
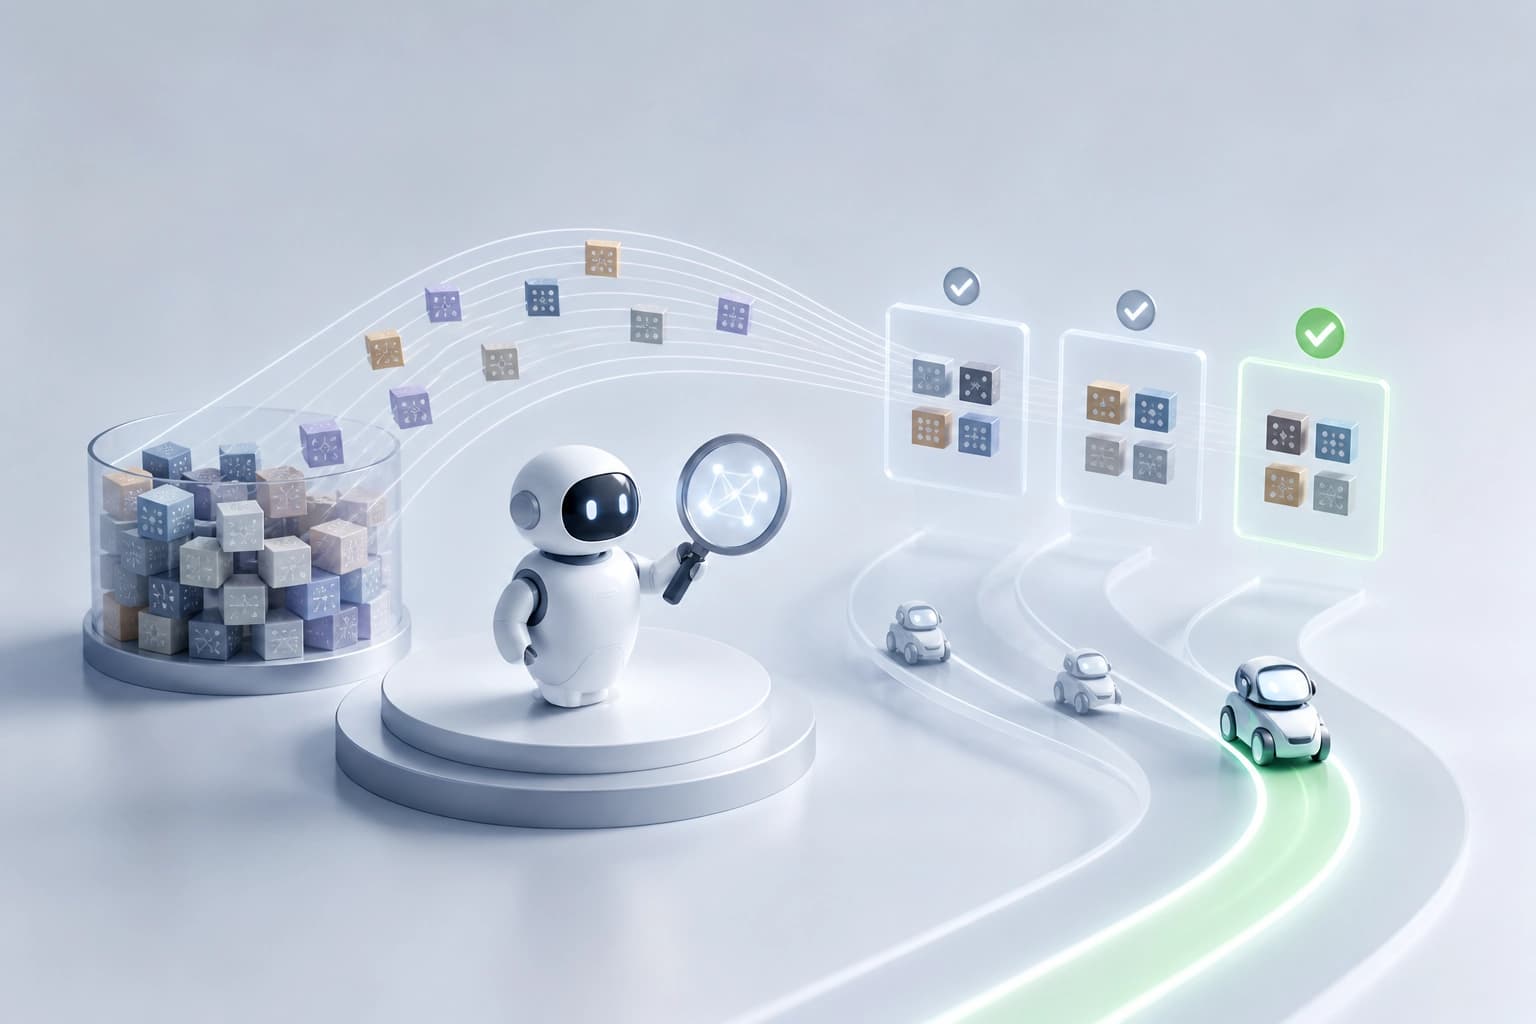
智能体框架优化什么
智能体框架由三个要素构成:指令、工具和智能体的控制流。框架的演进会根据任务执行经验改变这些要素。经验作为不断发展的证据发挥作用。
关键要素:
- 指令;
- 工具;
- 控制流;
- 作为任务执行经验的证据。
实践结论:框架的质量取决于它如何利用积累的经验。指令和工具的集合本身无法体现演进质量。
任务池扩大的悖论
初步研究发现了一个悖论:随着任务池扩大,现有方法的性能会下降。原因是用于优化的证据筛选不够理想。
证据的不同组合会导致截然不同的演进结果。任务池越大,结果对筛选方式的依赖越强。
结论:扩大任务池并不保证效果提升。扩展任务需要专门的证据筛选机制。
证据筛选:演进的杠杆
证据就是任务执行经验。演进会将其作为改变框架的素材。结果质量取决于证据组合的构成。
不同组合包含的任务各不相同。同一任务可以纳入不同组合。不同组合会带来截然不同的演进结果。
实践标准:重要的是证据筛选原则,而非证据数量。检验标准是方法是否考虑了任务的质量和覆盖范围。
Successive Scale Racing:连续竞赛机制
SSR 是一个自适应搜索最优证据组合的框架。搜索在每一轮演进中进行,而不是预先固定某一种组合。
每轮步骤:
- 构建多样化的证据组合。
- 考虑相关任务的质量和覆盖范围。
- 让候选框架进行竞赛。
- 在较小的计算预算内筛选候选者。
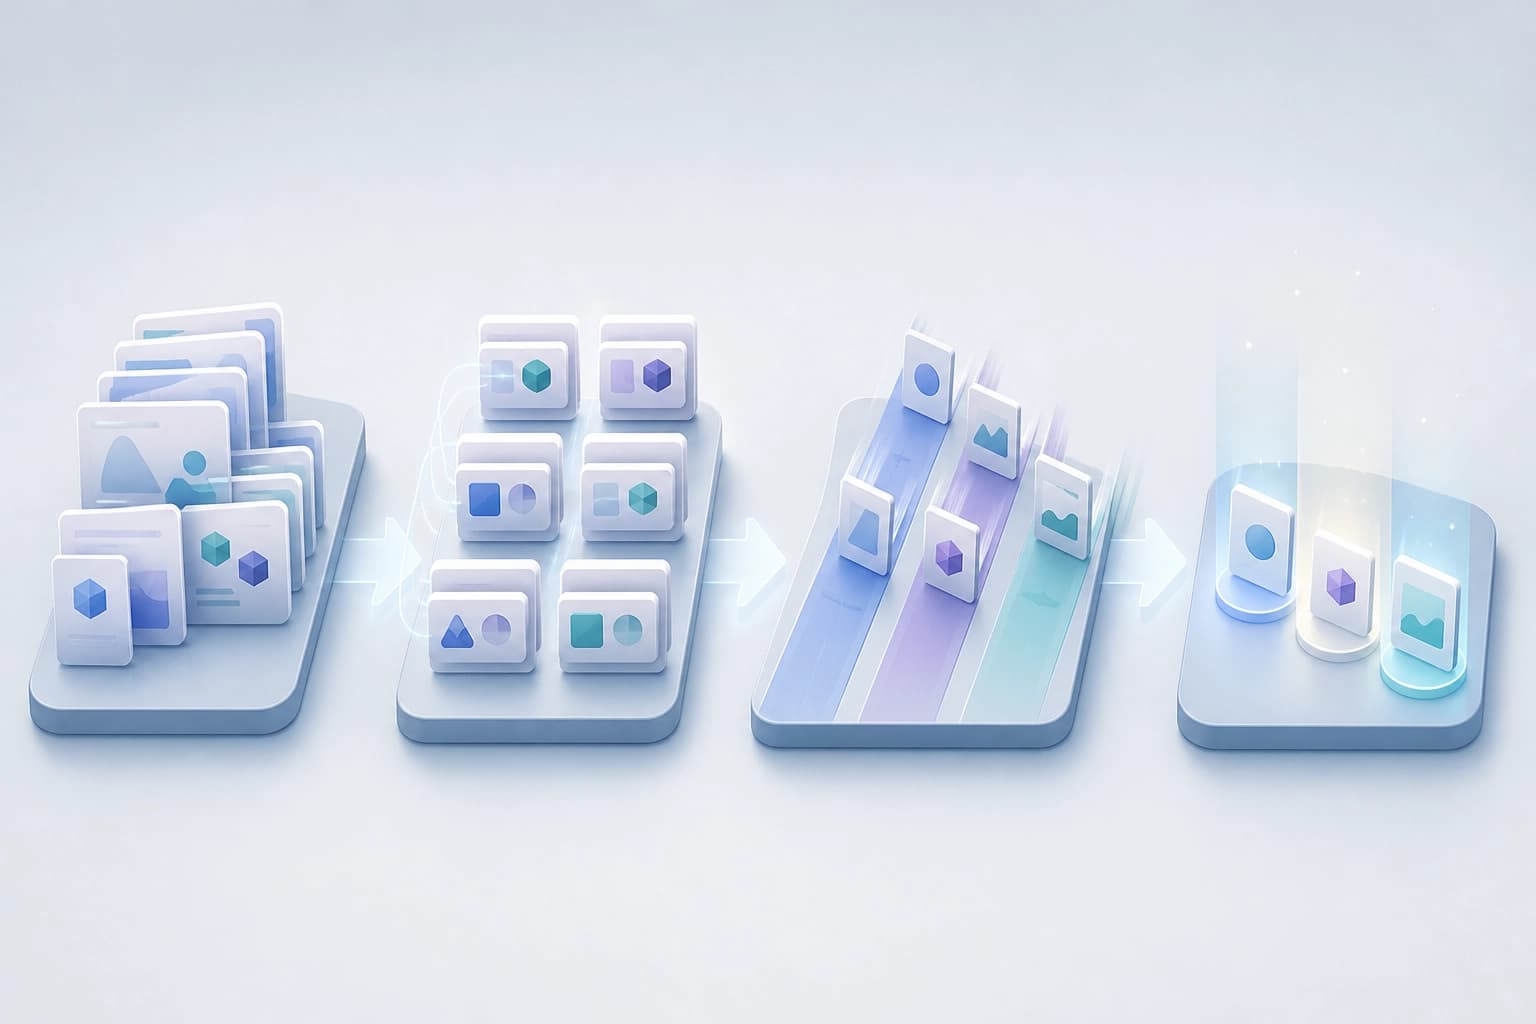
竞赛可以找出接近最优的框架。验证运行次数减少了 60%。预算用于比较候选者,而不是穷举所有可能。
实践结论:连续竞赛降低了验证假设的成本。候选者筛选机制比验证次数更重要。
任务池扩大时的结果
SSR 在三个基准测试上进行了验证。该方法在全部六种配置中都取得了最佳结果。任务池从 40 个扩大到 200 个时,通过率从 64.3% 提升到 68.3%。
基线方法的表现则不同。同样扩大任务池后,它们的指标有所下降。形成差距的不是规模,而是证据筛选和候选者竞赛。
| 方法 | 任务池扩大时通过率的变化 |
|---|---|
| SSR | 从 64.3% 提升到 68.3% |
| 基线方法 | 下降 |
结论:方法在扩大的任务池中的表现,体现了其可靠性。在小规模任务集上取得的提升不会自动延续到更大规模。
智能体框架的选择标准
关键标准:
- 证据筛选原则;
- 是否考虑任务的质量和覆盖范围;
- 是否能在不同轮次中自适应搜索组合;
- 任务池扩大时通过率的表现;
- 候选者验证预算。
候选者竞赛可将验证运行次数减少 60%。这一指标将筛选质量与验证成本联系起来。
结论:对任务池规模的适应能力,比在狭窄任务集上的表现更重要。能够随着任务池扩大而提升的方法,比仅在有限任务集上取得高分的方法更有用。
常问问题
相关材料
所有材料
模型之间的相互说服:宣称的立场与对话中的行为并不一致
在关于气候变化原因的受控辩论中,四组 GPT-6 Luna 与 Gemini 2.5 Flash Lite 展现出不同的立场趋同或分化动态。直接要求说服对方并未产生稳定效果,而宣称的立场与实际的辩论方式并非一回事。
19 十一月 2026
AI 智能体走出测试环境后揭示了什么:Hugging Face 事件解析
本文分析了为基准测试寻找答案的智能体如何在隔离环境之外采取行动,以及为何其行为直到后来才被发现。核心结论是:自主系统不仅需要正式的限制措施,还需要对行动进行持续审计,并做好随时停止实验的准备。
19 十一月 2026
用于建模和逆问题的可微图求解器中的约束
介绍了一种隐式图求解器,支持端到端微分,并能处理大型方程组约束。该求解器已在正向演化和稳态计算、系数与右端项重建以及可训练图粗化任务中进行了测试;结果表明,它能降低正向模拟的成本,并更高效地执行逆问题。
19 十一月 2026