
用于头颈部肿瘤质子治疗计划的循证闭环复合多智能体AI系统
该研究描述了经过训练的 PPO 策略与 LLM 智能体的结合:前者生成多个计划选项,后者通过对话进行 уточ уточ(临床指标与约束条件核验);在 21 名患者的数据上,经过微调的 Qwen3-14B 更能遵循指令,并有助于使权衡偏向优先目标。实践结论是,自动化 DRL 规划可以通过可控的对话加以补充,同时保留对相互竞争约束的掌控。
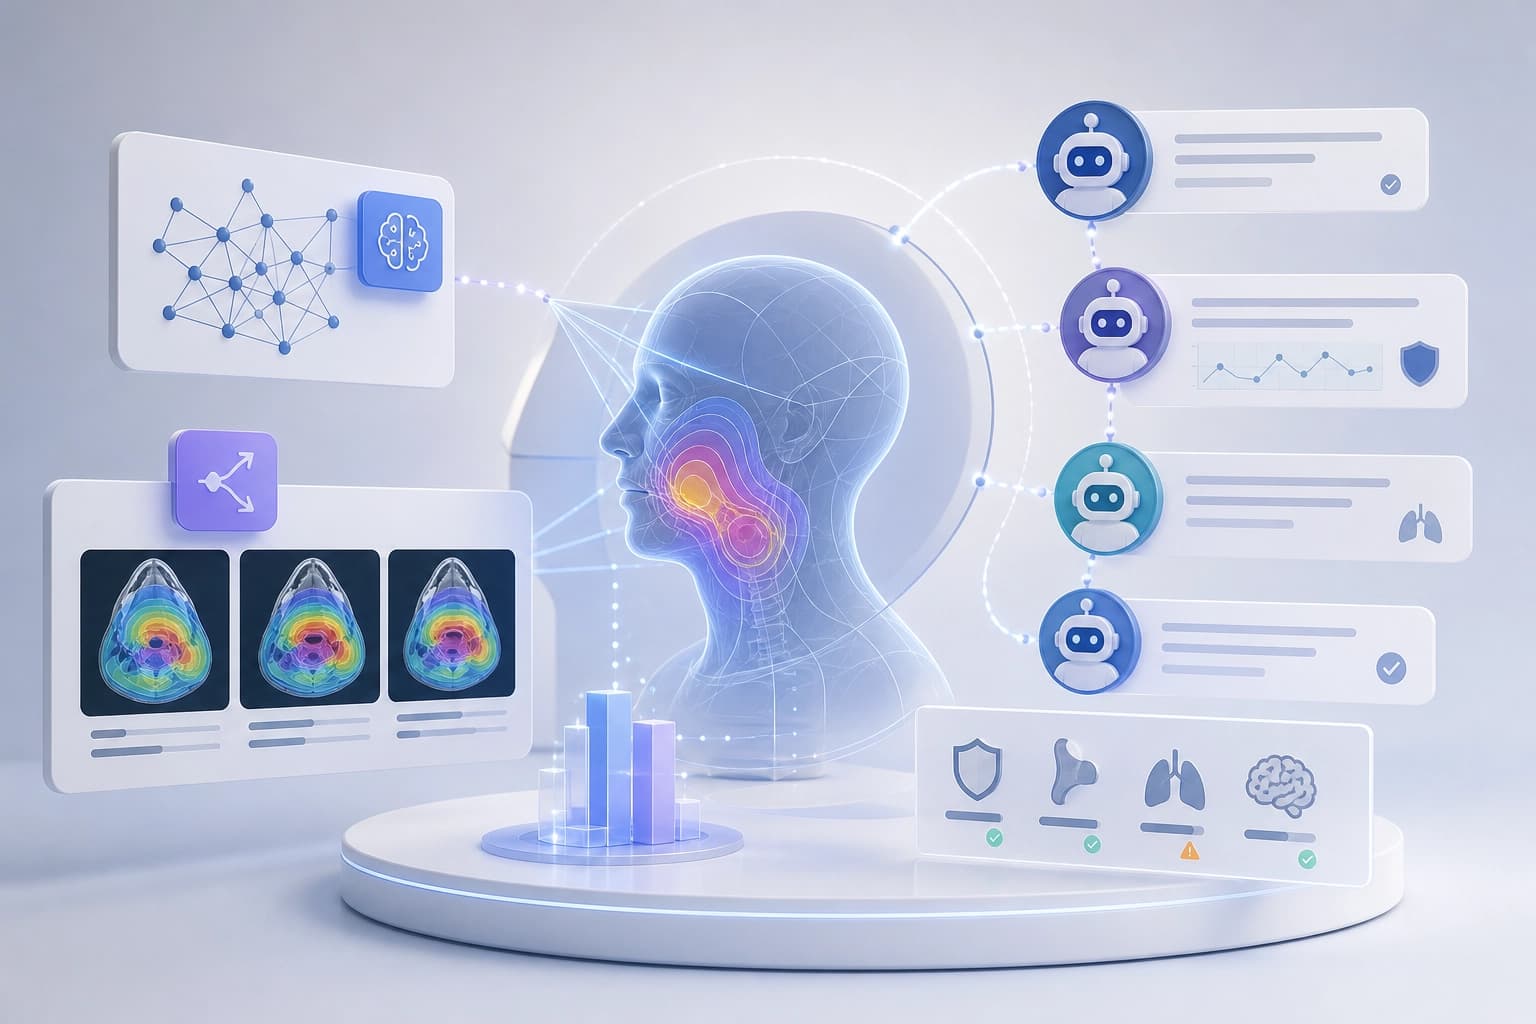
复合架构:生成与优化
Qingqing Wang、Liqiang Xiao 和 Chang Chang 于 2026年10月21日在 arXiv 上发表了一篇论文(arXiv:2610.29010)。他们在文中介绍了一种用于头颈癌质子治疗 PBS 的系统。该系统将基于 DRL 的自动计划制定与借助 LLM 进行的计划对话式优化相结合。
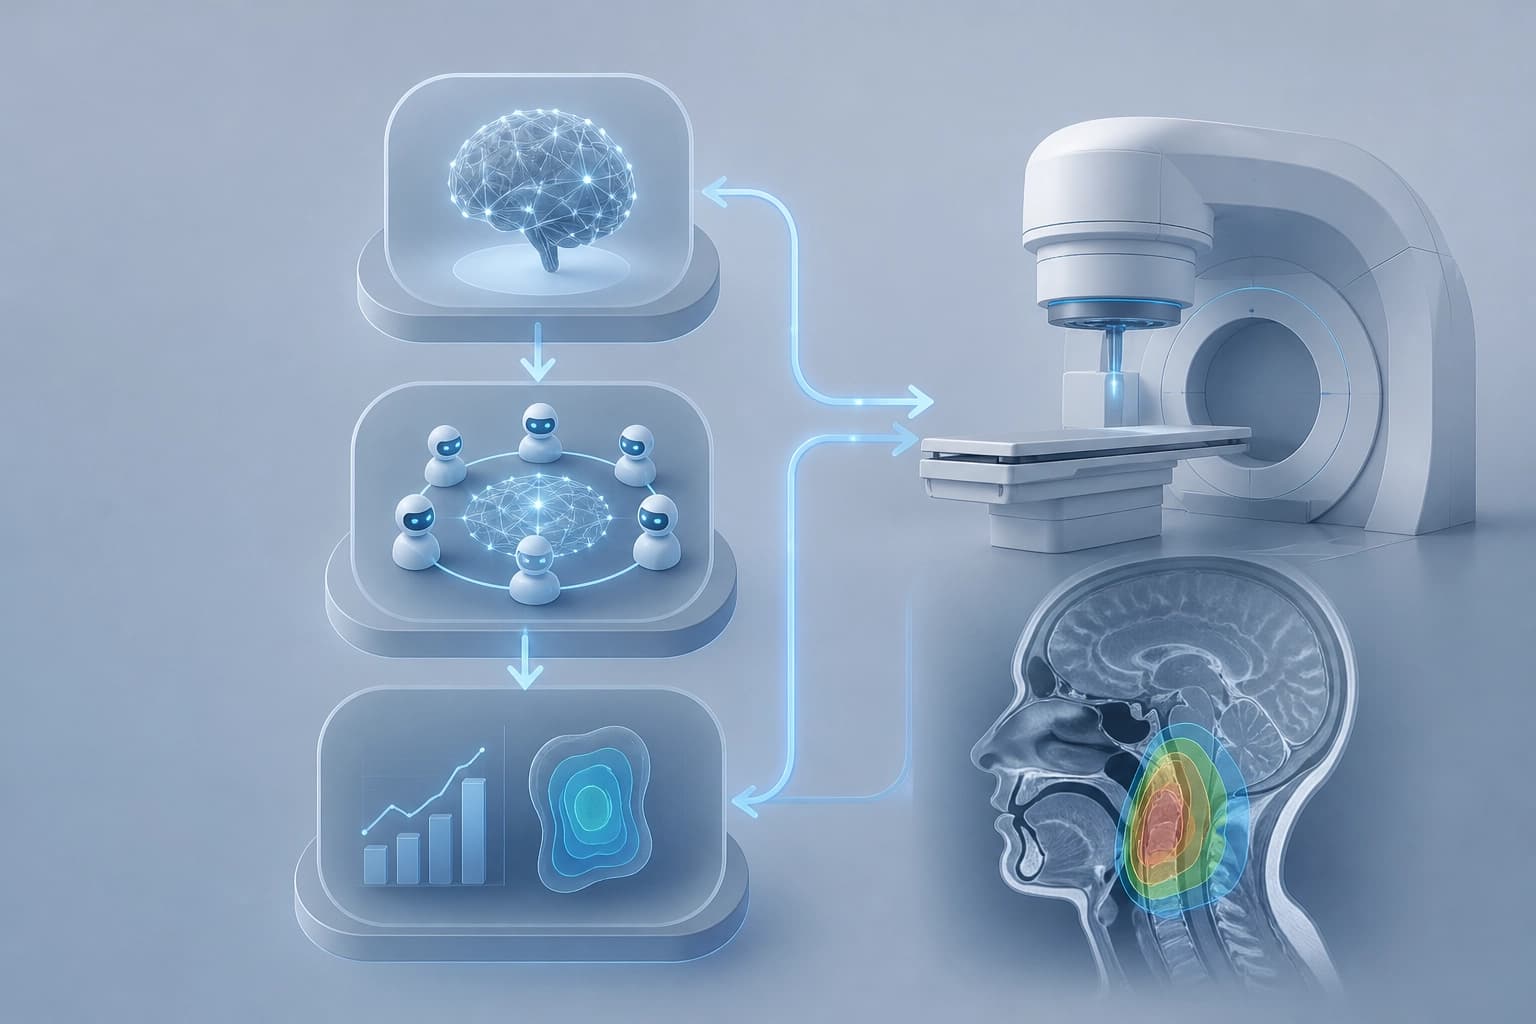
基于 DRL 的自动阶段会生成一组计划。系统选择其中一个计划作为目标计划,并将其他计划作为优化时的参考。对于复杂病例,系统采用多智能体 LLM 架构,通过自然语言对话优化计划。结论:该方案将自动生成与基于数据的对话式优化分开处理。
基于 PPO 的自动计划生成
自动阶段基于 PPO policy network。作者在无人参与的情况下训练该网络;网络首先生成多个计划。训练和评估使用了 21 名头颈癌患者的数据。作者为每位患者生成了 5 个 PPO 计划。
多个计划构成了选择目标计划的素材,也为优化提供参考依据。评判标准是:自动生成应输出一组计划,而非单个计划。这样,优化环节才有据可依。
多智能体优化环节
对于复杂病例,系统采用多智能体 LLM 架构,通过自然语言交互优化计划。该环节包括规划智能体、聊天机器人和评估智能体。
规划智能体基于数据提出调整建议。聊天机器人作为统一的对话界面。评估智能体构成证据链:提取临床指标并识别约束违规情况。
这种环节使优化过程能够通过临床指标和约束进行验证。评判标准是:优化应基于可量化的临床指标,而不能仅依赖对话文本。
规划智能体的训练
规划智能体基于 Qwen3-14B 运行。它依据此前生成的计划数据,为建议提供依据。为了进一步训练模型以完成相关任务,作者采用了 SFT 和 GRPO。
与基础 LLM 相比,经过微调的 Qwen3-14B 展现出更强的能力。它在遵循指令、提取信息和领域推理方面表现更好。
| 评判标准 | 基础 LLM | 微调后的 Qwen3-14B |
|---|---|---|
| 遵循指令 | 基础能力 | 能力有所提升 |
| 信息提取 | 基础能力 | 能力有所提升 |
| 领域推理 | 基础能力 | 能力有所提升 |
实践标准:对于规划智能体而言,重要的不只是生成能力,还包括遵循指令、提取数据和领域推理。通过 SFT 和 GRPO 进行微调可以增强这些能力。
评估与临床权衡
作者选取了 50 个计划,并根据指令对其进行优化。调整更有效地改善了用户优先考虑的目标,同时对其他竞争目标造成的负面影响有限。作者称,这些调整使计划优化能够在考虑患者个体情况的基础上实现更符合临床需求的权衡。
实践标准:应根据优先目标的改善程度,以及竞争目标受到的有限负面影响来评估优化效果。
常问问题
相关材料
所有材料
以计算筛选取代经验试错:电池材料的新方法
本文介绍了计算数据库、机器学习和生成式模型如何缩小有前景配方的筛选范围,以及自动化实验室如何加快验证;但最终结果仍取决于合成与测试,预测值可能与实际电导率不符。
20 十一月 2026
随着任务池规模扩大,智能体基准测试的演进:证据筛选与顺序竞赛的作用
这项研究解释了为什么增加任务数量可能会阻碍智能体基准的演进:问题在于证据选择不当,而非数据量本身。所提出的 Successive Scale Racing 通过轮流挑选多样化的任务组合,并以较低成本比较候选方案;在三个基准测试中,随着任务池从 40 个扩大到 200 个,成功运行的比例有所提高,而基线方法则表现退化,验证运行次数也减少了约 60%。
19 十一月 2026
模型之间的相互说服:宣称的立场与对话中的行为并不一致
在关于气候变化原因的受控辩论中,四组 GPT-6 Luna 与 Gemini 2.5 Flash Lite 展现出不同的立场趋同或分化动态。直接要求说服对方并未产生稳定效果,而宣称的立场与实际的辩论方式并非一回事。
19 十一月 2026