
NAQD-Env:语言智能体的选择性操作暂停
一个合成测试平台现已发布,其中确定性基准定义了数据、权限与约束之间的依赖关系,模型必须只停止受影响的步骤,同时保留其余工作。对三种开放模型的测试发现,其停止操作的召回率较低,且无法正确恢复;微调虽能提高决策准确率,却也会产生副作用。
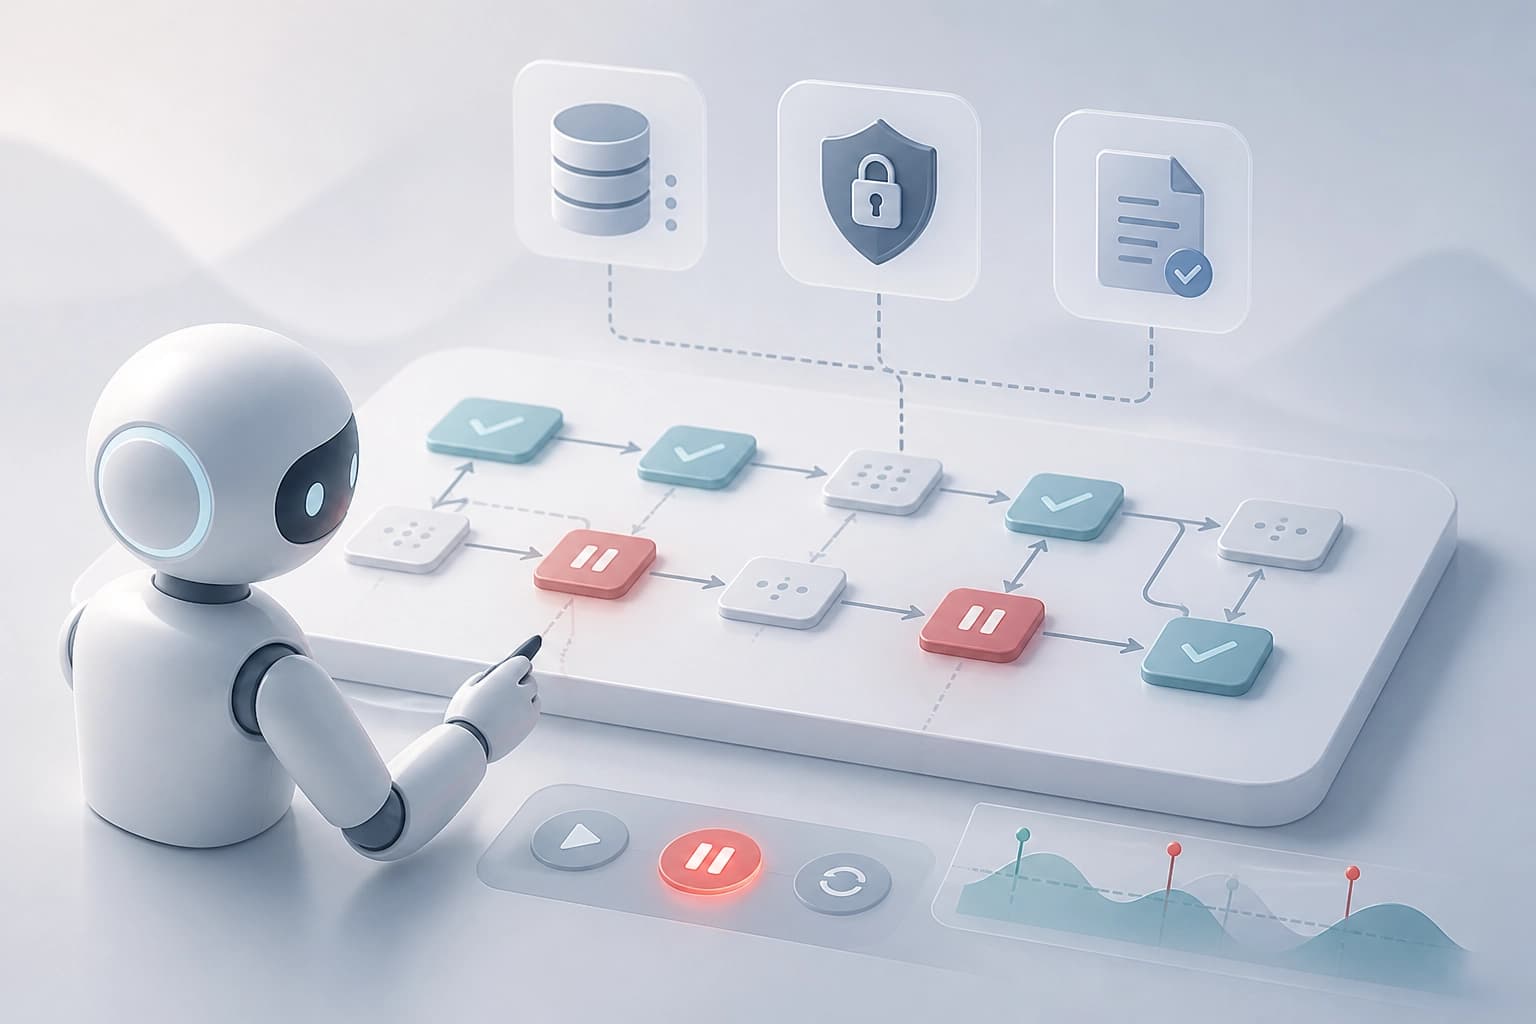
选择性暂停的本质
NAQD Env 是一种合成环境,用于评估语言智能体在选择性停止行动方面的决策。其基准策略是确定性的,依赖于明确定义的证据、授权和约束之间的关系。当证据发生变化、授权被撤销或收到停止指令时,智能体必须暂停受影响的行动。对于不受影响的工作,智能体则应予以保留。只有在得到充分纠正后,才恢复行动。评估标准:该环境检验的是暂停的选择性,而非全面停止。
评估方式
评估使用了 11 类依赖关系。数据集中包括用于开发的结构、留出类别以及留出的结构组合。各项指标分别统计违规尝试和模拟执行机制实际造成的违规。综合指标反映策略遵循情况、任务价值、行动停止、恢复以及事件报告。这样的指标体系区分了意图与实际违规,也将安全性与效用和沟通联系起来。实践标准:应综合查看所有指标,而不能只看是否停止行动。
三种模型的结果
研究评估了三种开放权重模型。它们均经过指令跟随调优,分属两个系列。研究采用了三种提示条件和 350 个固定场景。通过执行机制重放之前,共获得了 3 150 个“模型—提示”回合。在所考察的条件下,行动停止召回率不高于 0.06。在存在适当机会时,没有观察到任何一次正确恢复。只有一个回合完全符合基准策略。
NAQD 提示下的模型对比:
| 模型 | 观察结果 |
|---|---|
| Qwen2.5-7B | 与 Qwen2.5-3B 和 Llama-3.1-8B 相比,出现不安全尝试的回合更少。但有用工作也更少,对不受影响行动的保留也不够准确。 |
| Qwen2.5-3B | 在受控微调试验中,决策准确率从 0.45–0.54 提升至 0.83–0.92。 |
| Llama-3.1-8B | 在不安全尝试方面的表现不及 Qwen2.5-7B。 |
结论:即使使用专门设计的提示,模型也很少完全遵循基准策略。安全性提升可能会减少有用工作。实践标准:不仅要检查违规尝试,还要检查是否保留了不受影响的行动。
环境与微调的局限
该环境评估的是在可信结构化输入可用时对策略的应用。它无法证明模型具备现实中的遏制能力或来源核验能力。在受控微调研究试验中,Qwen2.5-3B 的决策准确率有所提升。单独的诊断发现,在训练课程内容出现缺失后,模型会不恰当地停止行动;诊断还显示,事件报告频率有所下降。Mohamed Abouzahra 的论文于 2026年9月29日提交。实践标准:微调需要检查是否出现不恰当的停止,以及事件报告的质量。
实践选择建议
NAQD Env 衡量的是受控条件下的选择性暂停。该环境使用可信结构化输入,但无法保证模型在现实中的遏制或来源核验能力。选择智能体时,应关注行动停止召回率、恢复是否正确、不受影响的工作是否得到保留,以及事件报告情况。微调可能提高决策准确率,但也有导致不恰当停止和沟通减少的风险。评估标准:应将该环境用作策略诊断工具,而非现实环境可靠性的证明。
常问问题
相关材料
所有材料
医疗 LLM 能获知指南更新,却常常仍按旧规则回答
ChronoEvo 对 1709 项临床指南变更的研究显示:在基础模型中,90.8% 的回答记录了新变化,但只有 58.5% 完整应用了这些变化;这一差距达 32.3 个百分点,并且在 14 个模型中均存在。即使提高更新内容的显著性,也未能显著提升将新规则完整纳入临床指南的比例。
4 十一月 2026
封闭式 LLM 智能体的世界模型:在风险点进行校正
提出了 PAWM——一种外部预测器,不会重复逐步观察,而是在可能发生故障时介入,引导智能体避开错误操作。经过基于合成场景的 SFT 和 GRPO 协同训练后,该方法使 Claude Sonnet 4.5 在 ScienceWorld 和 WebArena-Lite 上分别提升了 24.3% 和 7.7%。
4 十一月 2026
SpeechLLM 上的分类头:在情感识别中,它在哪些方面优于标签生成?
基于 IEMOCAP 和 MELD,比较了紧凑型 SpeechLLM 的情感标签生成输出与基于其隐藏表示的线性分类器。分类器带来的性能提升并非普遍存在:它取决于语料库,以及使用的是参考转录文本还是 ASR 输出。
4 十一月 2026