
封闭式 LLM 智能体的世界模型:在风险点进行校正
提出了 PAWM——一种外部预测器,不会重复逐步观察,而是在可能发生故障时介入,引导智能体避开错误操作。经过基于合成场景的 SFT 和 GRPO 协同训练后,该方法使 Claude Sonnet 4.5 在 ScienceWorld 和 WebArena-Lite 上分别提升了 24.3% 和 7.7%。
问题:智能体缺乏环境知识
基于黑箱式 LLM 的先进智能体擅长进行长程推理和精确生成行动。但对于具体的智能体任务,它们并未习得环境如何演变的知识。arXiv:2610.29139 这篇文章于 2026 年 10 月 21 日提交,描述了这一差距。
世界模型为智能体提供有关特定环境的知识。它会预测环境对智能体即将执行的行动作何反应。这样的模型能够补充任务相关信息。
实践标准:检查世界模型与目标环境之间的关联。通用推理知识无法弥补对具体任务理解的不足。
纠错模式:瞄准风险点,而非每一步
此前用于 LLM 智能体的世界模型主要预测每一步的下一次观测。这种模式成本高且信息价值有限。单次观测所提供的任务相关指引有限。并不需要在每一步都进行预判。
一项试点研究表明:当世界模型预判有限多步未来中的陷阱时,其指引最有用。这意味着纠错应在风险点触发,而非持续运行。
| 方案 | 已知情况 |
|---|---|
| 逐步预测 | 预测每一步的下一次观测;成本高且信息价值有限。 |
| 陷阱预判 | 预判有限多步未来中的陷阱;提供最有用的指引。 |
实践标准:选择在可能出现陷阱时触发的模式,而不是把预判用于每一步。
陷阱预判如何运作
作者提出了 Pitfall Anticipation World Model (PAWM)。该模型通过三个要素运作:
- 在可能出现陷阱时选择性介入;
- 预测即将发生的失败;
- 在风险点引导智能体避开陷阱。
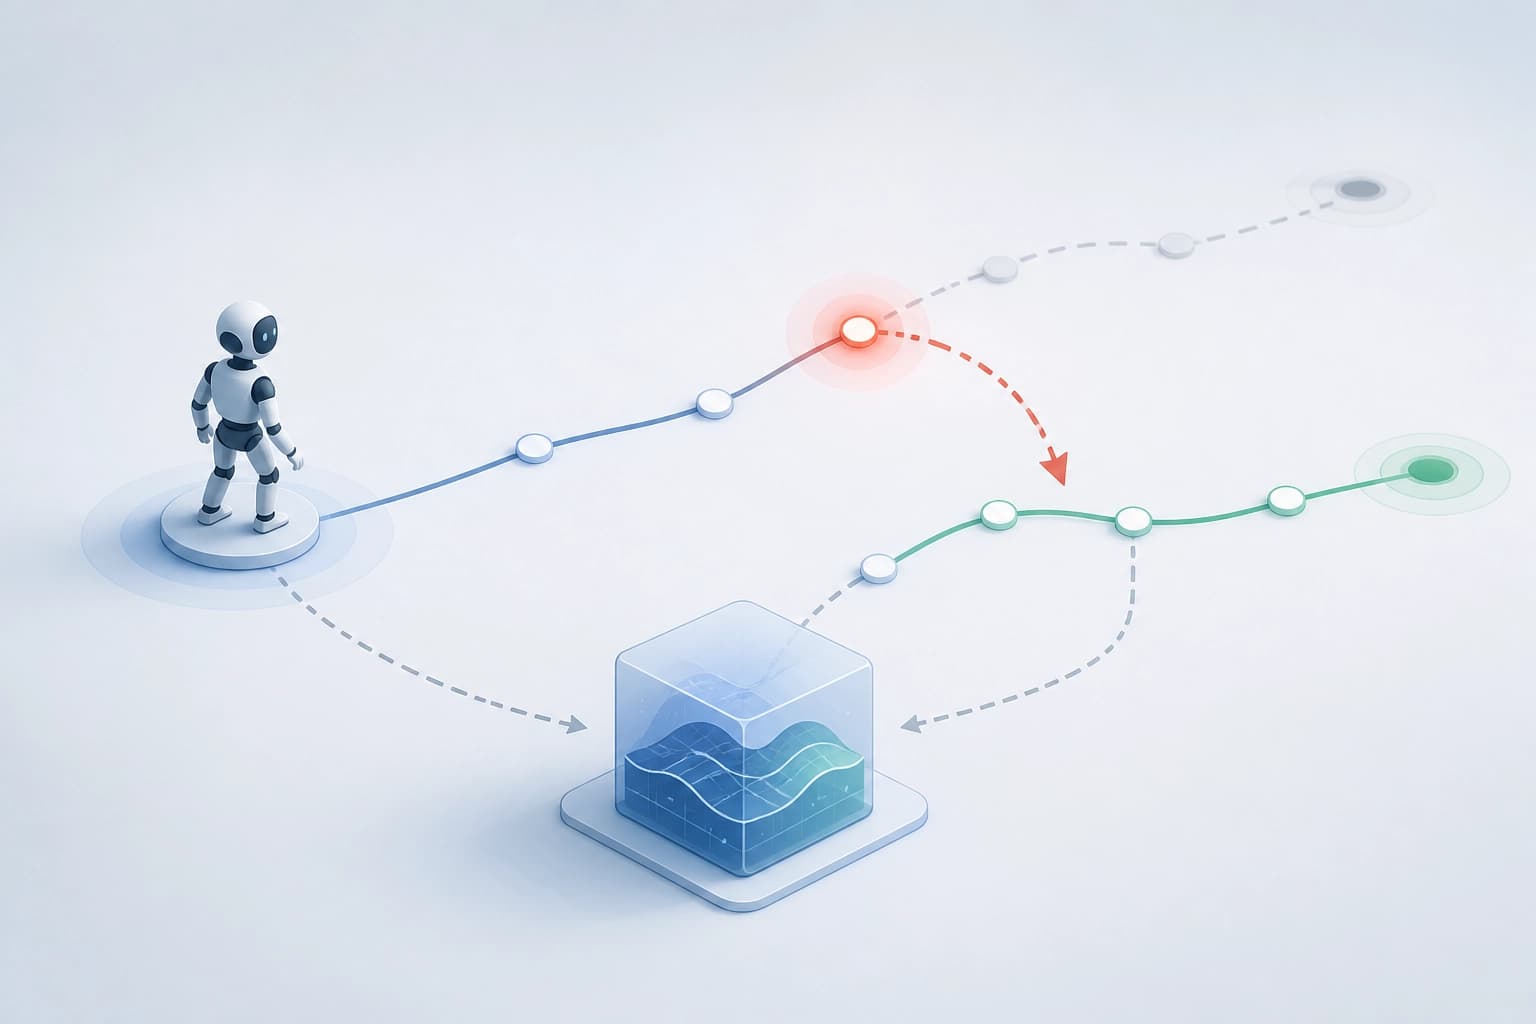
实践标准:纠错触发机制应基于潜在陷阱和对即将发生失败的预测。
模型的两阶段训练
作者分两个阶段训练 Pitfall Anticipation World Model (PAWM)。
- 在合成数据上进行 Supervised Fine-Tuning (SFT)。合成数据包含针对智能体的陷阱标注。
- 与黑箱式 LLM 进行 GRPO co-training,以在目标环境中优化模型。
实践标准:检查两个阶段——陷阱标注以及在目标环境中的 co-training。
评估:关注哪些方面的提升
该方法使 Claude Sonnet 4.5 在 ScienceWorld 中的表现提升了 24.3%,在 WebArena-Lite 中提升了 7.7%。
| 环境 | Claude Sonnet 4.5 的提升幅度 |
|---|---|
| ScienceWorld | 24.3% |
| WebArena-Lite | 7.7% |
作者还指出,该模型优于若干基线方法。实践标准:关注目标环境中的提升幅度,以及与基线方法的比较。跨环境迁移结果需要单独验证。
常问问题
相关材料
所有材料
SpeechLLM 上的分类头:在情感识别中,它在哪些方面优于标签生成?
基于 IEMOCAP 和 MELD,比较了紧凑型 SpeechLLM 的情感标签生成输出与基于其隐藏表示的线性分类器。分类器带来的性能提升并非普遍存在:它取决于语料库,以及使用的是参考转录文本还是 ASR 输出。
4 十一月 2026
从个体评分到可接受集合:DDI 约束下的全局解码
本文将基于 mixed-integer linear programming 实现的精确全局兼容药物组合选择,与在 MIMIC-III 上使用固定 FLAME 评分的多种局部 DDI 冲突消解方案进行了比较。在测试集上,全局方案的 Jaccard 得分略有提升,但优势稳定;随着约束收紧,优势进一步扩大,相较于最强的局部基线方法达到 +0.0064。
4 十一月 2026
转向概率单纯形可缩小对比式多模态模型中的模态差距
在论文 arXiv:2610.32890 中,作者提出用概率单纯形替代球面嵌入,并加入轻量级 softmax 适配器和总变差相似度。在五个检索基准测试中,模态间的质心 ℓ2 距离降低了 97–99%,同时检索质量保持不变或有所提升。
3 十一月 2026