
SpeechLLM 上的分类头:在情感识别中,它在哪些方面优于标签生成?
基于 IEMOCAP 和 MELD,比较了紧凑型 SpeechLLM 的情感标签生成输出与基于其隐藏表示的线性分类器。分类器带来的性能提升并非普遍存在:它取决于语料库,以及使用的是参考转录文本还是 ASR 输出。
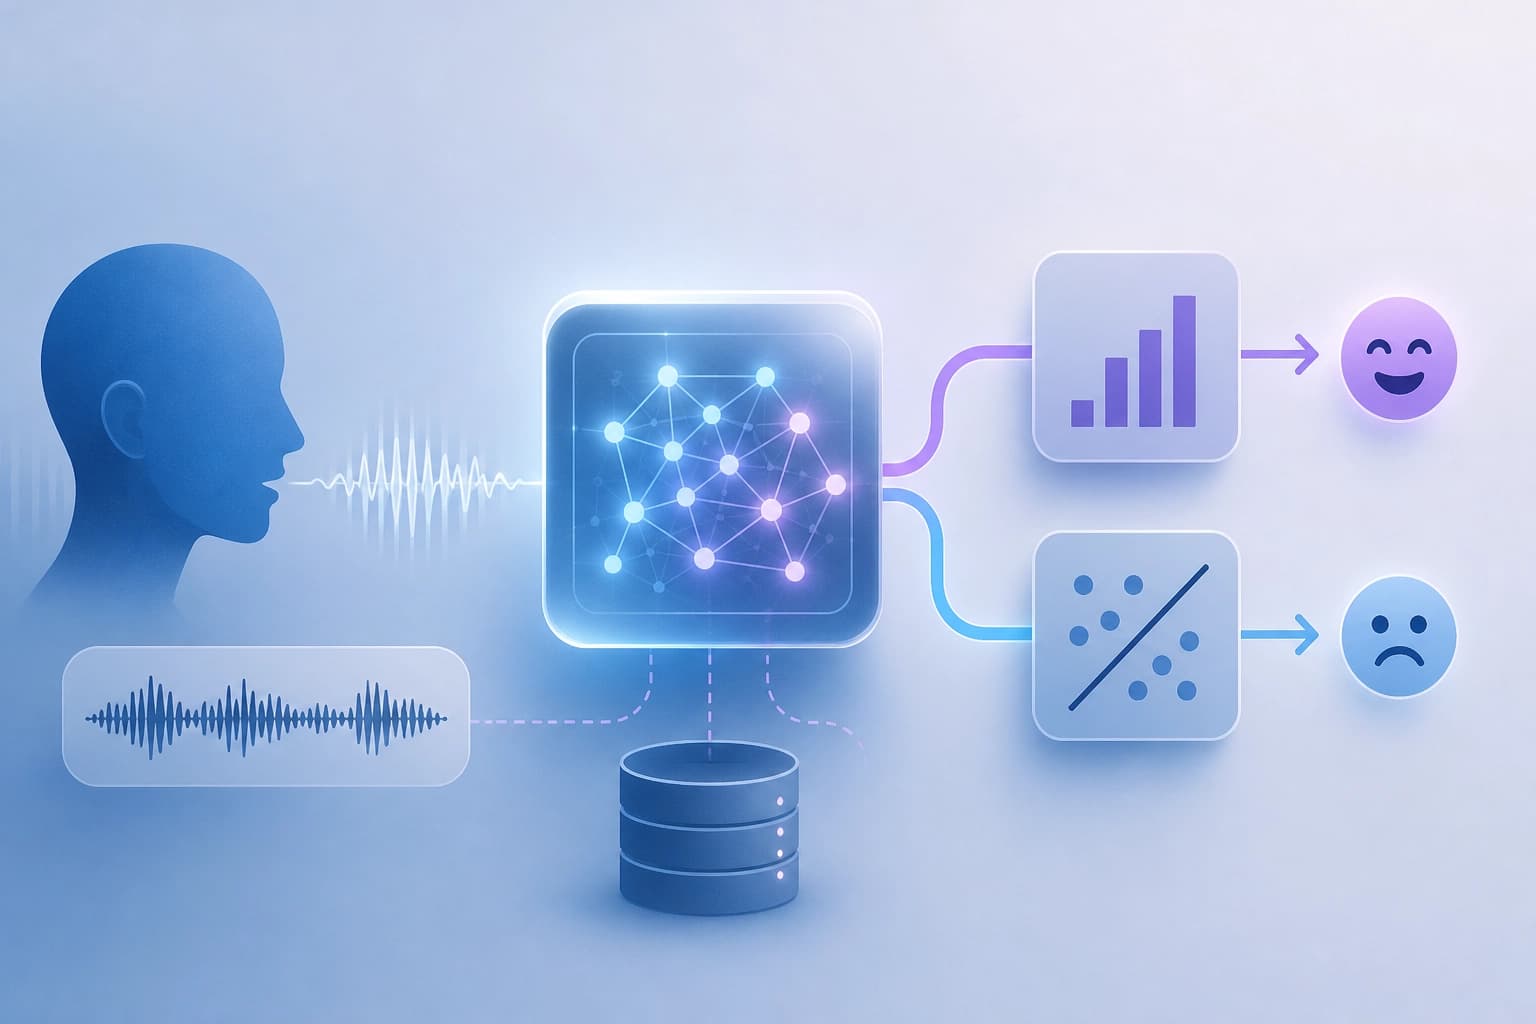
两种情绪识别方法
本文比较了 LLM 标签 token 生成与判别式分类,后者是在 LLM 隐状态之上添加线性分类头。生成式方法依赖 LLM 现有的输出表示。判别式方法则为模型添加独立的分类头。
| 标准 | 标签 token 生成 | 判别式分类 |
|---|---|---|
| LLM 的作用 | 提供标签的输出表示 | 为分类头提供隐状态 |
| 决策机制 | LLM 生成标签 token | 线性分类头对隐状态进行分类 |
| 使用内容 | 模型现成的输出 | LLM 的隐状态 |
实际区别在于:生成式方法使用模型现成的输出,而分类头读取隐状态。
比较条件
比较在 IEMOCAP 和 MELD 上进行。使用了紧凑型 SpeechLLM:冻结的 Whisper-medium 编码器和 3B LLM。每次比较都采用了人工标注转录文本和 ASR 转录文本。比较涵盖两种文本来源,因此分别针对每种来源检验分类头的效果。评估标准:只在同一数据集、同一转录文本来源内比较结果。
分类头在哪些情况下优于标签生成
分类头在 14 种配置中的 10 种提升了 Macro F1。在 IEMOCAP 上,分类头提升了所有使用 ASR 转录文本的配置,并达到 76.97% Macro F1。同样在 IEMOCAP 上,仅使用语音的模式也显示出显著提升。在 MELD 上,分类头在仅使用语音时有所帮助,但在使用 ASR 转录文本时没有帮助。结论:收益取决于数据集和转录文本来源。标签生成并非在所有情况下都能被超越。
为什么不能将人工标注转录文本上的结论直接套用
在 MELD 上,ASR 转录文本的 WER 为 32.38%。在 6 种使用文本的配置中,有 4 种的分类头效果在人工标注转录文本和 ASR 转录文本之间发生反转。因此,根据人工标注转录文本得出的结论不一定适用于 ASR。实践标准:应在实际使用的文本来源上检验分类头。
词表中最近邻 token 显示了什么
在 IEMOCAP 和 MELD 上,与学习到的类别向量最近邻的 LLM 词表 token 大多是与情绪相关的词,但并非明确的情绪名称。这表明,明确的情绪名称不一定与最近邻词表 token 一致。检验标准:查看哪些 token 与类别向量接近,而不只是查看标签名称。
选择标准
选择方法取决于两个因素:数据集和转录文本来源。
- 对于 ASR 转录文本,应在 ASR 上检验分类头,而不是在人工标注文本上检验。
- 对于仅使用语音的模式,应考虑其在 IEMOCAP 和 MELD 上的提升。
- 对于人工标注转录文本,不要将结论直接套用到 ASR 上。
- 要解释类别含义,应查看 LLM 词表中的最近邻 token。
最终标准:只有在目标数据集和转录文本来源上的测试显示出优势时,分类头才优于标签生成。
常问问题
相关材料
所有材料
医疗 LLM 能获知指南更新,却常常仍按旧规则回答
ChronoEvo 对 1709 项临床指南变更的研究显示:在基础模型中,90.8% 的回答记录了新变化,但只有 58.5% 完整应用了这些变化;这一差距达 32.3 个百分点,并且在 14 个模型中均存在。即使提高更新内容的显著性,也未能显著提升将新规则完整纳入临床指南的比例。
4 十一月 2026
封闭式 LLM 智能体的世界模型:在风险点进行校正
提出了 PAWM——一种外部预测器,不会重复逐步观察,而是在可能发生故障时介入,引导智能体避开错误操作。经过基于合成场景的 SFT 和 GRPO 协同训练后,该方法使 Claude Sonnet 4.5 在 ScienceWorld 和 WebArena-Lite 上分别提升了 24.3% 和 7.7%。
4 十一月 2026
从个体评分到可接受集合:DDI 约束下的全局解码
本文将基于 mixed-integer linear programming 实现的精确全局兼容药物组合选择,与在 MIMIC-III 上使用固定 FLAME 评分的多种局部 DDI 冲突消解方案进行了比较。在测试集上,全局方案的 Jaccard 得分略有提升,但优势稳定;随着约束收紧,优势进一步扩大,相较于最强的局部基线方法达到 +0.0064。
4 十一月 2026