为什么智能体式 RAG 会卡在岔路口
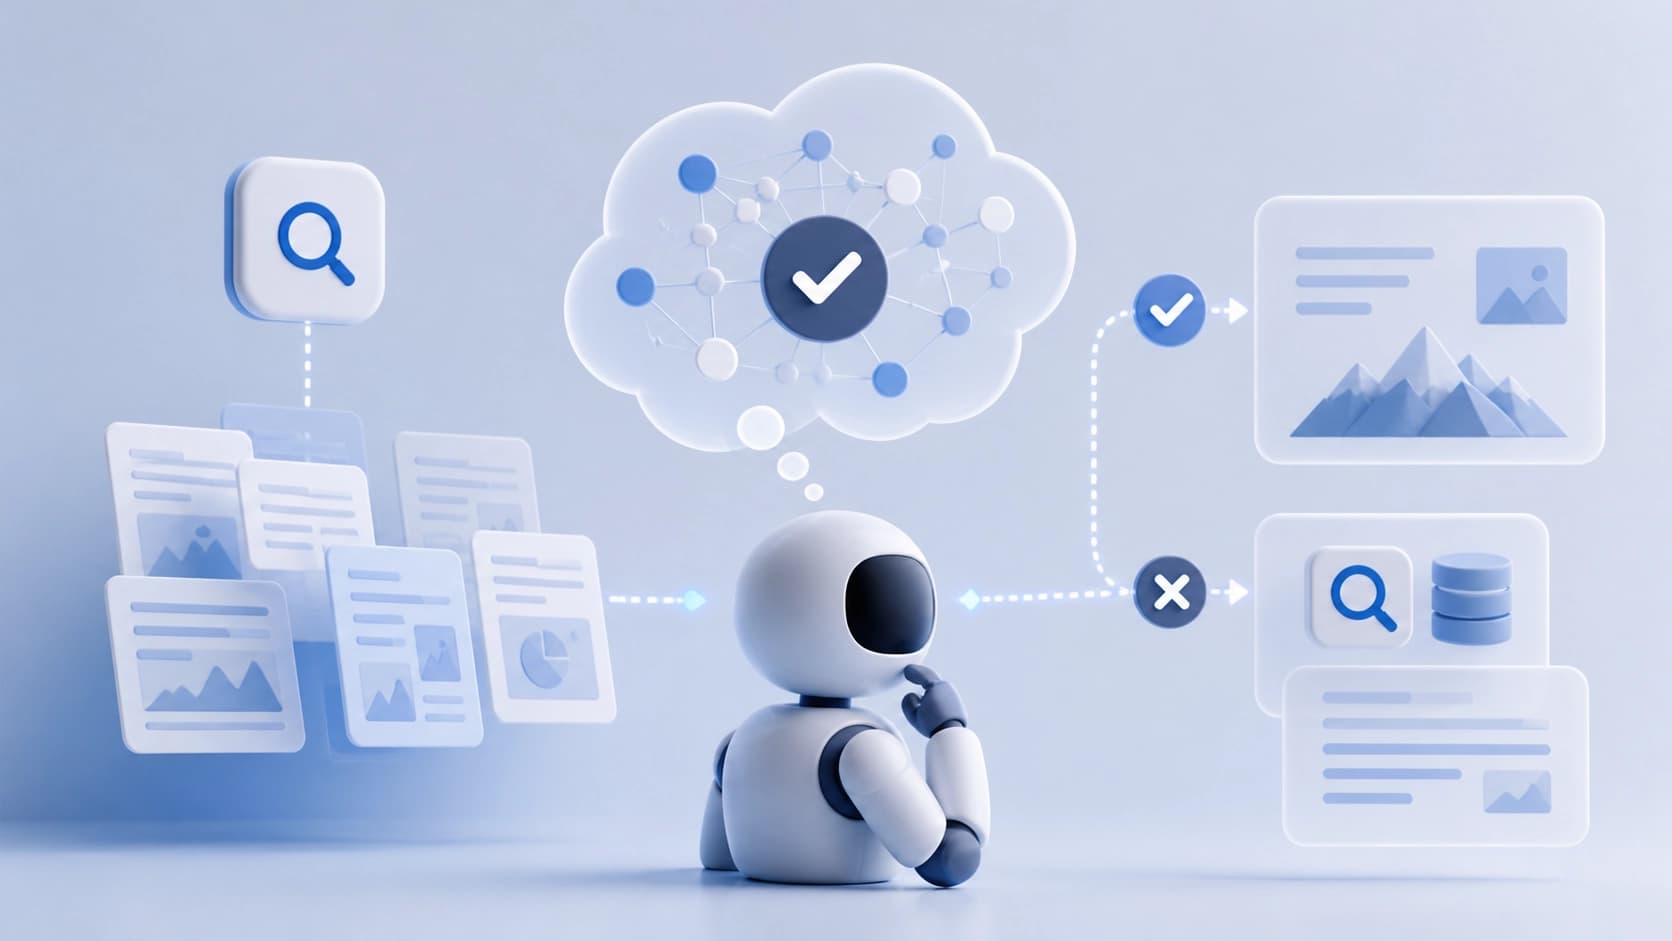
智能体式 RAG 的运作方式是一个循环:模型读取问题,判断是否需要再一次检索查询,获取结果后再次选择——是继续搜索还是直接作答。每一次多余的迭代都要付出金钱和时间的代价,每一次遗漏都可能导致回答不完整。于是,智能体的核心能力并非提取文档,而是懂得在恰当的时候说「证据已经足够了」。
经典强化学习从外部评估这种行为:答案与标准答案一致就加分,不一致就减分。至于模型自身如何看待所收集材料的充分性,则无人问津。由此产生两种对称的病症:策略要么在内部已经明确的情况下继续深挖,要么在数据明显不足时中断搜索。外部奖励无法区分这两种情形——结果相同,行为却截然不同。
问题设定的转变
MetaRAG 论文的作者提出,不仅要看动作本身,还要看它与智能体关于证据充分性的内部信念有多吻合。他们将这种设定称为信念与动作的对齐——belief-action alignment。道理很简单:搜索决策的质量不是叠加在答案之上的一个独立指标,而是模型「所想」与「所做」之间的一致性。
MetaRAG 是如何构建的
该框架由三部分组成:动作前的显式验证、内部信念探针,以及将两者关联起来的特殊奖励。
动作前的验证
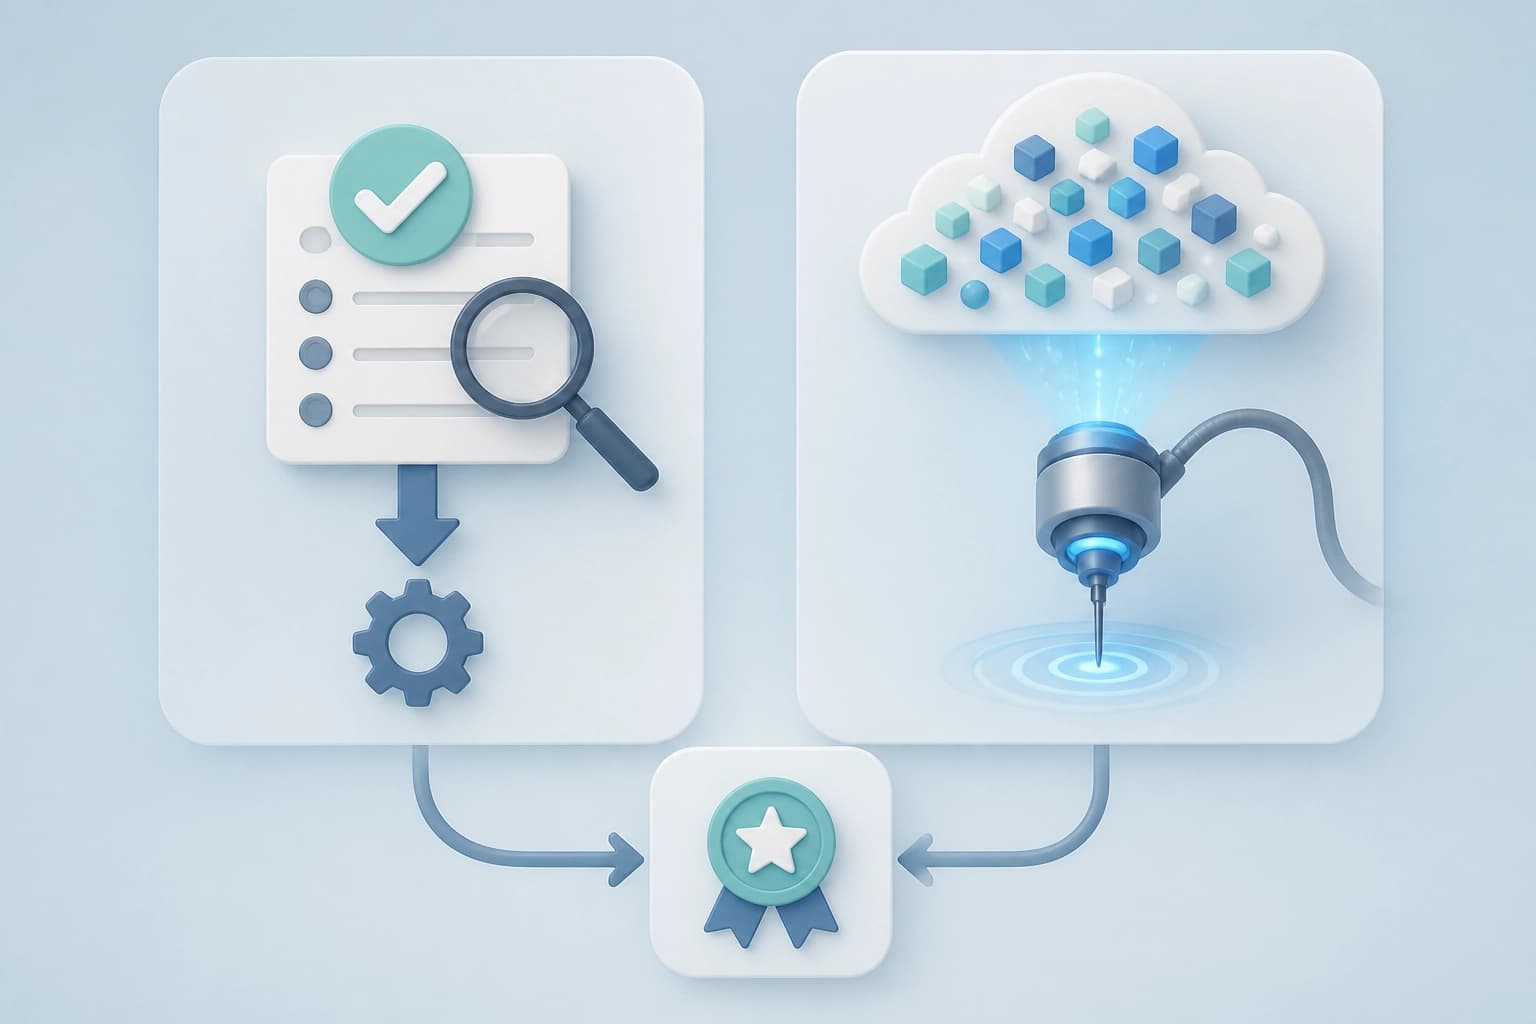
第一个组件是 Verify-first Action Generation。策略不是直接输出下一步,而是先将该步骤通过一个显式验证流程:这个动作是否适合当前的搜索状态。其思路是在冲动决策进入轨迹之前就将其筛除。本质上,这是内置于生成过程中的一个「定格」,而快速智能体通常缺少这一环节。
内部信念探针
第二个组件是 Internal Belief Probing。从策略所看到的同一上下文中(问题加上动作与观察的历史),单独读取它自己的判断:现在是否已经可以回答该问题。重要的是,这既不是外部评判模型,也不是人工标注——信号取自同一个策略,只是以另一种方式获取。
带保护机制的连贯性奖励
从这两个信号中推导出 consistency reward:当智能体的动作与其对证据充分性的内部评估一致时,就给予奖励。这里有一个明显的陷阱——如果模型一贯且自洽地犯错,就可能开始奖励「自信的错误」行为。作者用一个门控堵住了这个漏洞:只有当答案正确时,连贯性奖励才被计入。换言之,连贯性并非目的本身,而是正确性的一个乘数。
对实践者而言一个重要的细节:信念探针只存在于训练阶段。在推理时它不会被调用,因此每次请求不会产生额外计算——开销保持为零。
实验展示了什么
该工作在七个公开问答基准上进行了验证。所宣称的结果是:相对于智能体式 RAG 的强力 RL 基线方法,在准确性与效率之间的权衡上取得了稳定改善。也就是说,收益不在于单纯回答得更准,而在于不必为此付出无休止搜索的代价。
随后作者检验了该效果的迁移能力:在深度研究(deep research)场景、不同优化器以及不同基础模型上。据其数据,在所有这些配置中该方法都保持了优势。这正是常常缺失的那类验证:在单一模型和单一数据集上的提升,很容易与调参运气混为一谈。
这在实践中意味着什么
对于智能体式搜索系统的开发者,MetaRAG 指出了一个比想象中更廉价的方向。如果你已经有策略训练,加入内部信念信号并不需要新的标注人员:策略本就看到的同一上下文,可以作为信号来源。而正确性门控在此必不可少——没有它,智能体可能学会漂亮而自信地犯错。
第二个结论关乎奖励设计本身。外部指标回答的是「是否成功」,但几乎无法说明「智能体在当下是否合理」。区分这两者正是这篇论文的核心思想:信念与动作之间的一致性是一个独立的、可单独优化的对象,而不是准确性提升的副产品。
不过,也要记住其边界:实验局限于问答基准和深度研究场景,而且该方法本身是搭建在 RL 训练之上的,因此无法「开箱即用」于根本不训练策略的系统。对于这类情况,更有价值的是其理念本身——在执行前显式验证动作,并单独评估决策是否与对数据充分性的内部感觉相符。
全文见 arXiv:2608.24214(v1,2026 年 8 月 25 日,cs.AI 分区)——该工作已被 EMNLP 2026 会议主程序接收。