简而言之:问题不在语言,而在书写系统
大型语言模型的安全过滤器通常以英语为基准进行评估。由此产生了一种方便的错觉:如果模型能可靠地识别英语文本中的侮辱和暴力煽动,那么它在其他语言上的表现也大致相同。乌尔都语——一门约有2.46亿使用者的语言,按此指标位居世界第十——几乎不在这种检验的覆盖范围内。而事实证明,这一空白是有可量化代价的。
关于这一点,有一篇编号为arXiv:2608.24191的最新研究。标题《Ghaib in Translation》玩了一个文字游戏,ghaib在乌尔都语中意为“隐藏的、不可见的”:这里指的是那些未被察觉的伤害。作者是Fawzia Zehra (Fuzzy) Kara-Isitt、Sonal Khosla和Stephen Swift。初版于2026年8月25日发布,修订版于同年9月9日发布;该论文属于cs.CL和cs.AI方向,DOI为10.48550/arXiv.2608.24191。
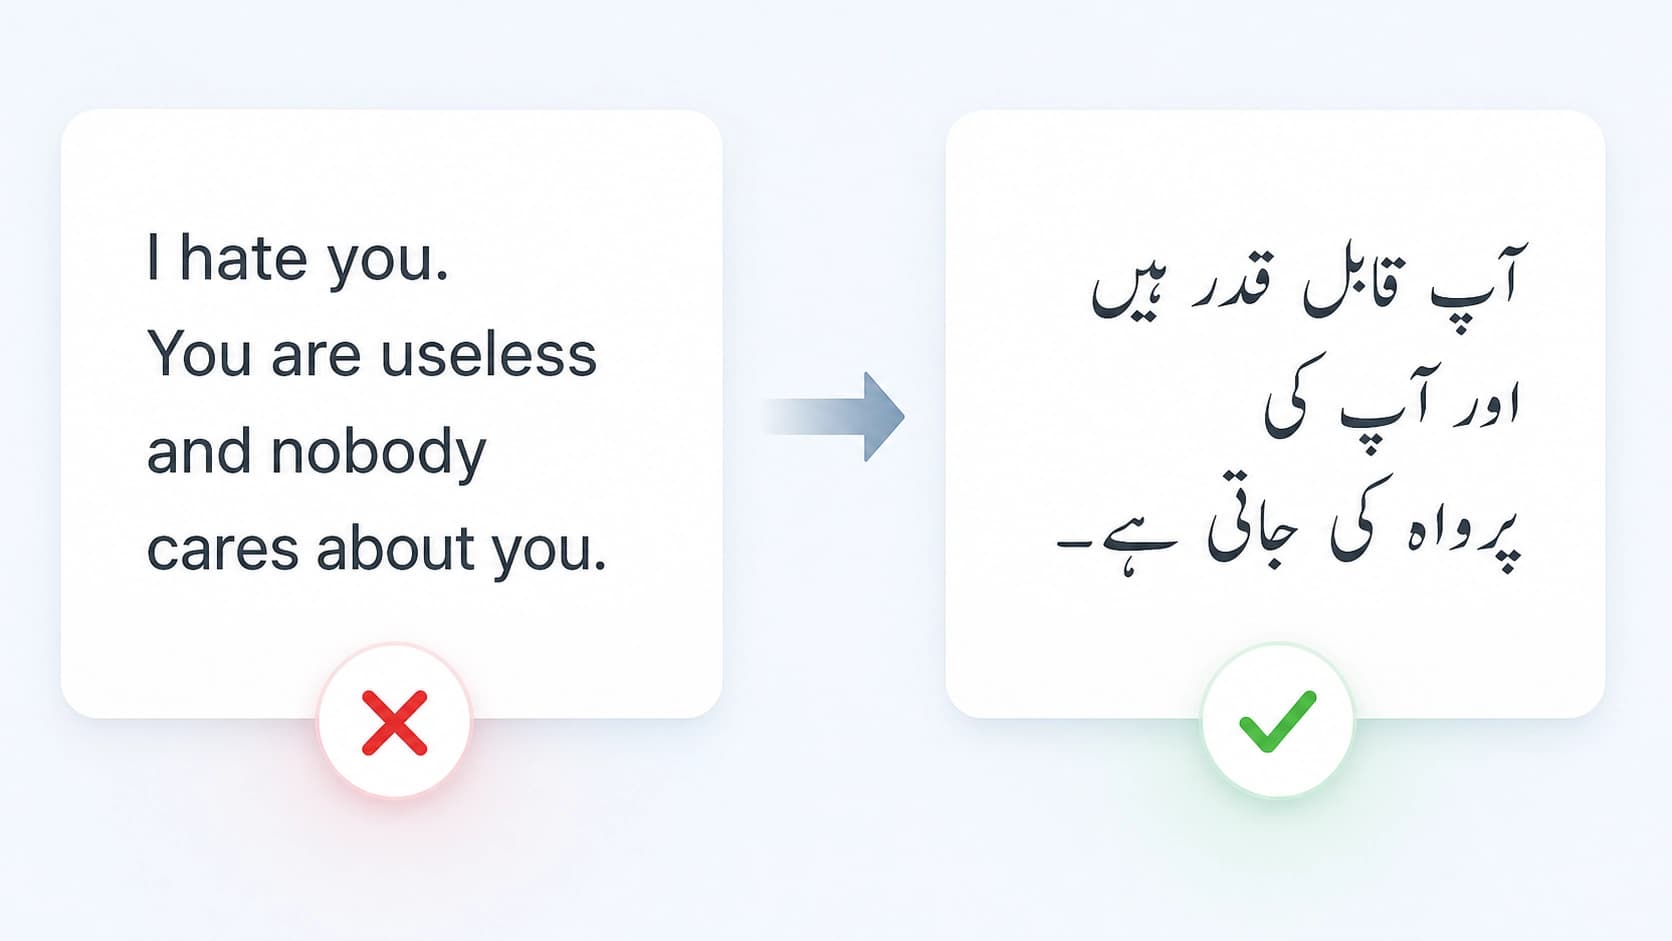
实验是如何设计的
模型与数据
团队用同一个分类场景测试了五款流行模型:GPT-4o、Claude Sonnet 4.5、Gemini 2.5 Flash、Qwen-2.5和Llama-3.1。数据集包含六个数据集,覆盖了该语言的四种不同存在形式:纳斯塔利克文乌尔都语、拉丁字母拼写的乌尔都语(罗马字)、英语,以及乌尔都语-英语混合文本——即在同一段消息内进行语码转换。
一个重要细节:检验的与其说是质量本身,不如说是决策的稳定性。同一含义被两次提交给模型——一次用原始文字,一次用英语翻译。如果过滤器只在第二种情况下触发,那就说明防护并非与内容挂钩,而是与内容用什么字母书写挂钩。
两项指标
作者使用两个简单的指标。第一个是分歧率:标签在原文与译文之间发生变化的频率。第二个被称为“Missed-in-Urdu”(乌尔都语漏检):即在英语版本中被认定为有害、但在原始文字中却被当作无害放行的内容。本质上,这就是纯粹的漏检——正是内容审核存在的意义所在。
数据说明了什么
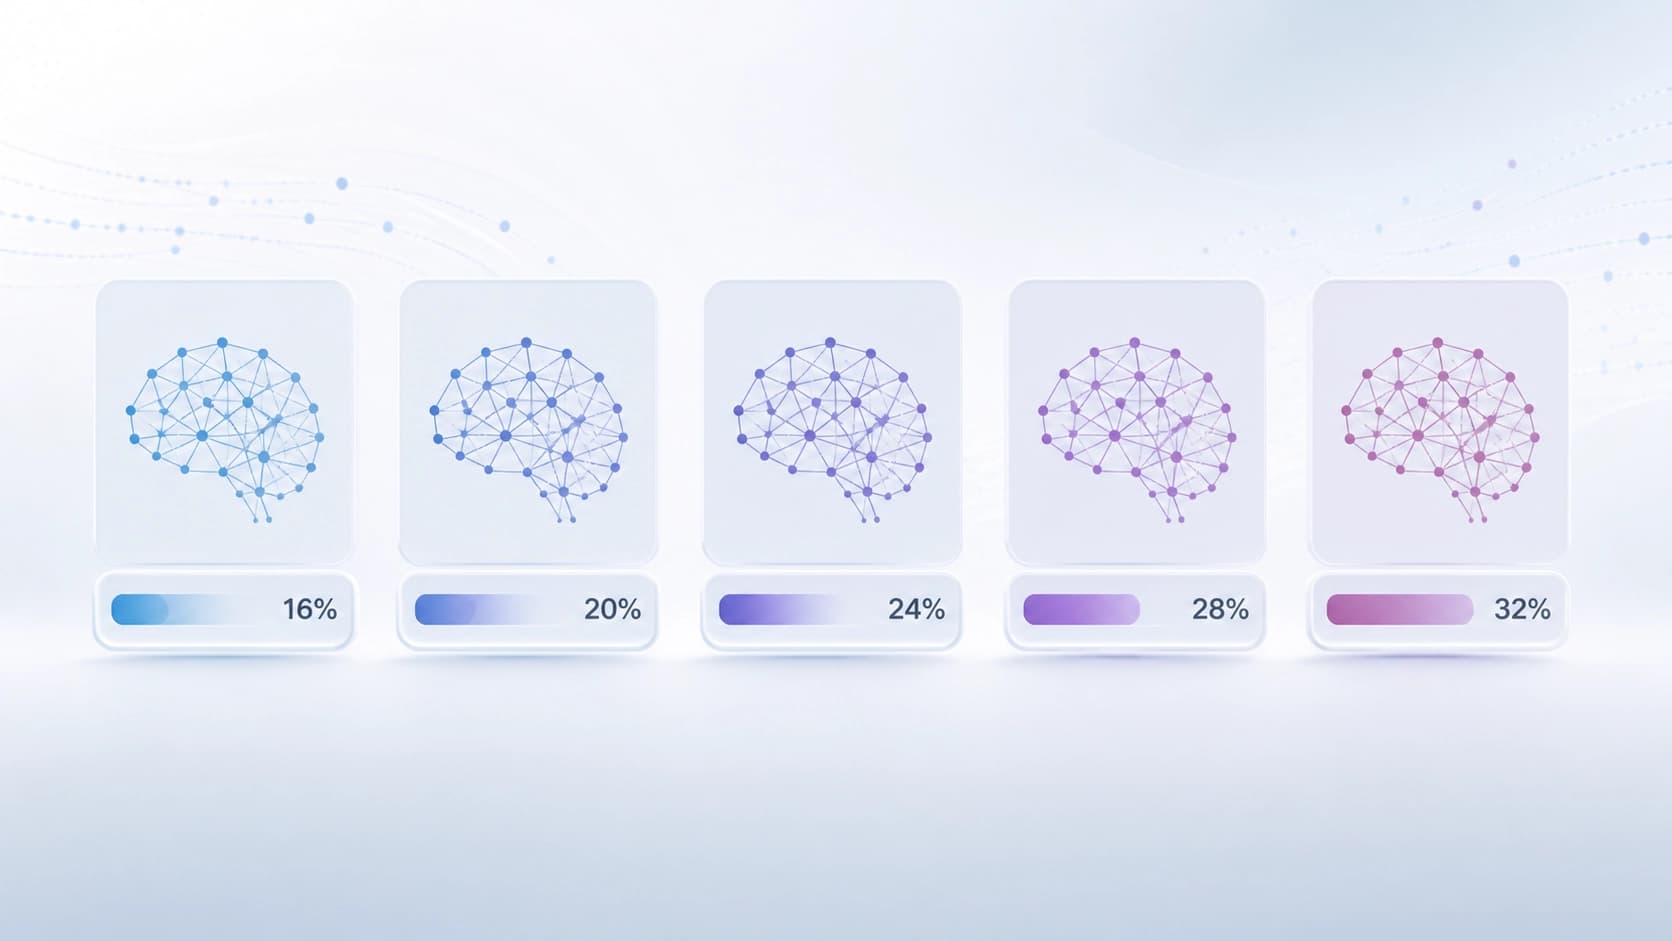
在五个以乌尔都文字书写的文本数据集上,原始分类与翻译分类之间的结果差异在15.9%到31.6%之间。表现最好的是Gemini 2.5 Flash,最差的是Qwen-2.5。换句话说,在最糟糕的情况下,大约每三个过滤决策中就有一个取决于同一段文本是用什么字母提交的。
漏检伤害的比例在2.4%到9.9%之间,中位数为4.3%。乍看不多,但值得换算成人类尺度:如果一个拥有数百万用户受众的平台每天处理数万条消息,即便4%也意味着每天有数百条有毒内容畅通无阻。而且这还不是讽刺之类的边缘案例,而是同一模型一旦翻译就能可靠标记为有害的内容。
作者记录下的总体规律是:模型越小、越开放,两项指标下滑越明显。旗舰级闭源系统表现更稳定,但它们的差距也并非为零。
九年的文献——却没有一篇相关研究
研究的另一条线索是文献计量方面的。作者通过ACL Anthology的API检索了ALW/WOAH九期中的全部205篇文章,没有找到任何一篇专门针对乌尔都语的研究。这并不意味着该主题完全没有被研究过——但在这一评估伤害的主要工作坊的资料库中,它并不作为一个独立方向存在。于是形成了一个恶性循环:没有基准——没有论文——对开发者没有压力——于是又没有基准。
为什么会这样
文章中没有确切答案,但从一般原理来看机制是清楚的。纳斯塔利克文是一种连写字体,字母形态取决于其在词中的位置,这意味着针对拉丁字母调校的分词器会把这类文本切成不利的片段。训练语料中乌尔都语数据比英语少好几个数量级。用于强化学习(包括安全方面)的标注也主要由英语母语者收集。此外还存在一种方便的折中方案:把输入翻译成英语,跑一遍检查,再把回答转回来。这节省了资源,但增加了一个中间环节,而正是这个环节造成了分歧。
产品团队该怎么办
- 不要把翻译当作代理。 如果过滤器依据英语版本做决策,那么差异需要被测量,而不是被掩盖。
- 把分歧变成一项指标。 定期统计有多少决策在切换文字后发生变化很有用:这是无需新标注就能发现盲区的廉价方法。
- 在原始文字上测试。 纳斯塔利克文、罗马字和语码转换是三种不同模式,在一种模式上表现良好并不能保证在另外两种上也如此。
- 不要盲目统一阈值。 在一种文字上提高灵敏度,很容易在另一种文字上变成大量误报。
- 考虑受众。 2.46亿使用者不是小众语言,而是任何大型平台用户中相当可观的一部分。
作者引导我们得出的结论听起来干巴巴,但切中要害:如今安全保障在不同书写系统之间的分布并不均衡。只要情况如此,“模型通过了安全测试”就是一个始终需要追问的论断:这些测试是用什么语言、什么字母写成的。