简而言之:他们发布了什么
2026年8月底,LAION团队发布了LAION-BVD——一个开放视频语料库,预印本中将其描述为规模空前的多模态训练数据集。该工作于2026年8月25日发布在arXiv上,分类为计算机视觉、人工智能和机器学习。
冷冰冰的数字如下:
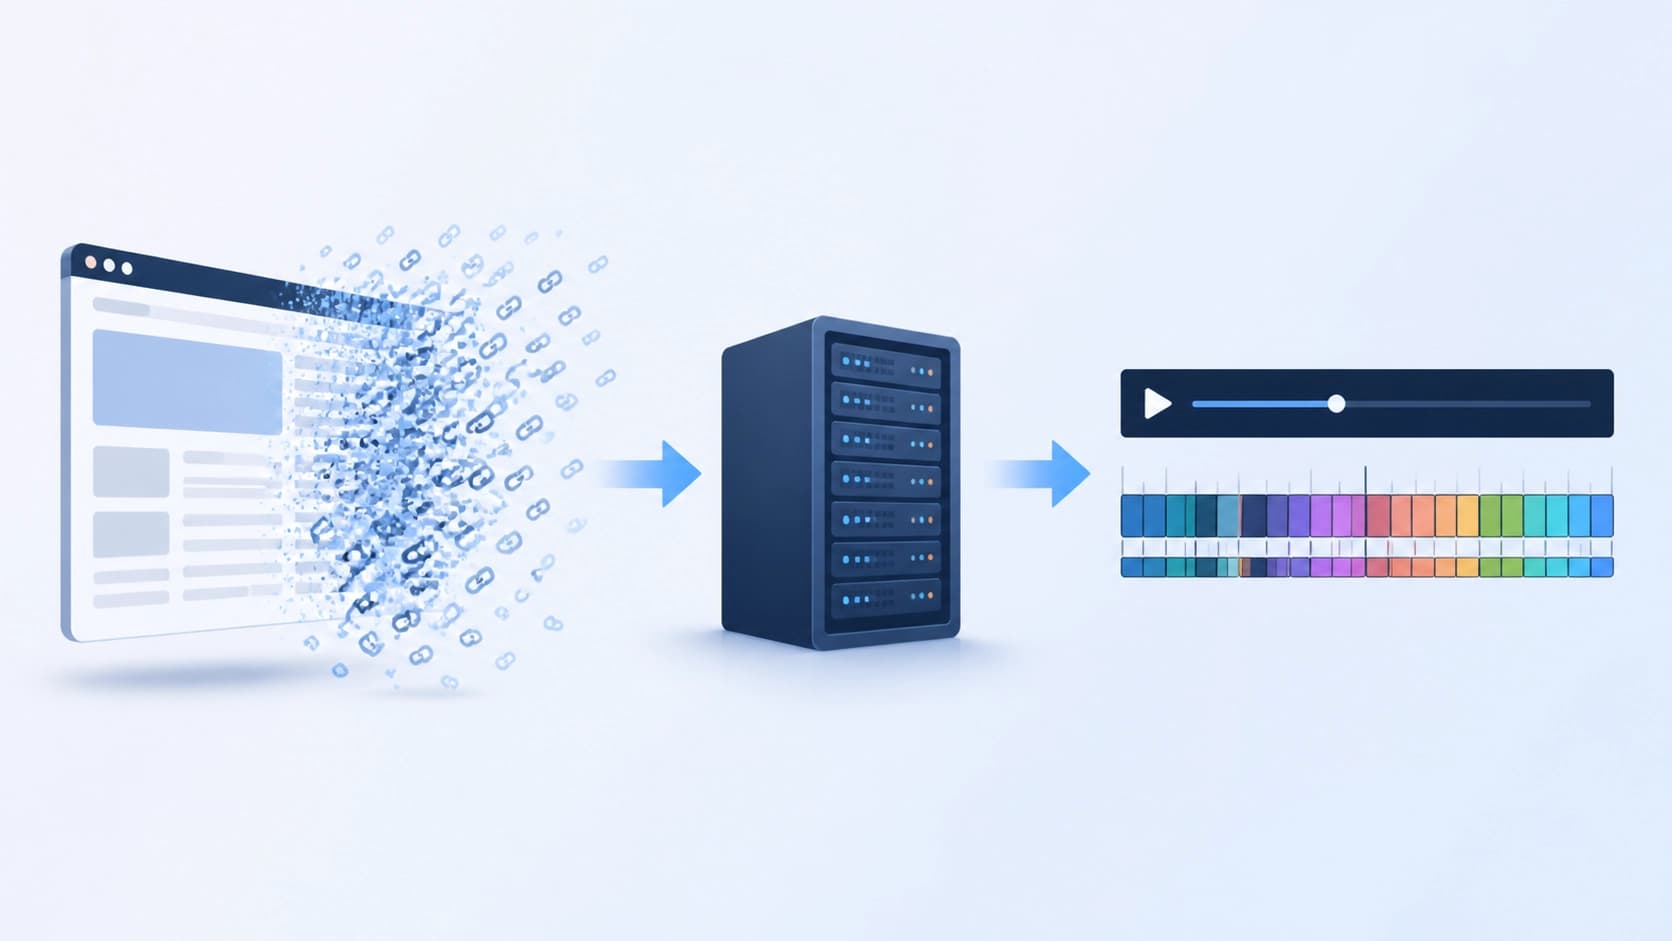
- 13亿条视频链接——这是构建的起点,链接从CommonCrawl网页抓取中提取,并绑定到具体平台;
- 8000万个视频通过这些链接实际下载成功——并非索引中找到的所有内容都能撑到下载完成;
- 1000万小时的总时长。
最后一个数字让人难以想象:这相当于一千多年的连续观看。正因如此,这次发布被称为一种转变——改变了没有企业预算的研究者所能获取的资源——此前同等规模的视频语料库都留在封闭的实验室内部。
如何构建
从链接到成品片段
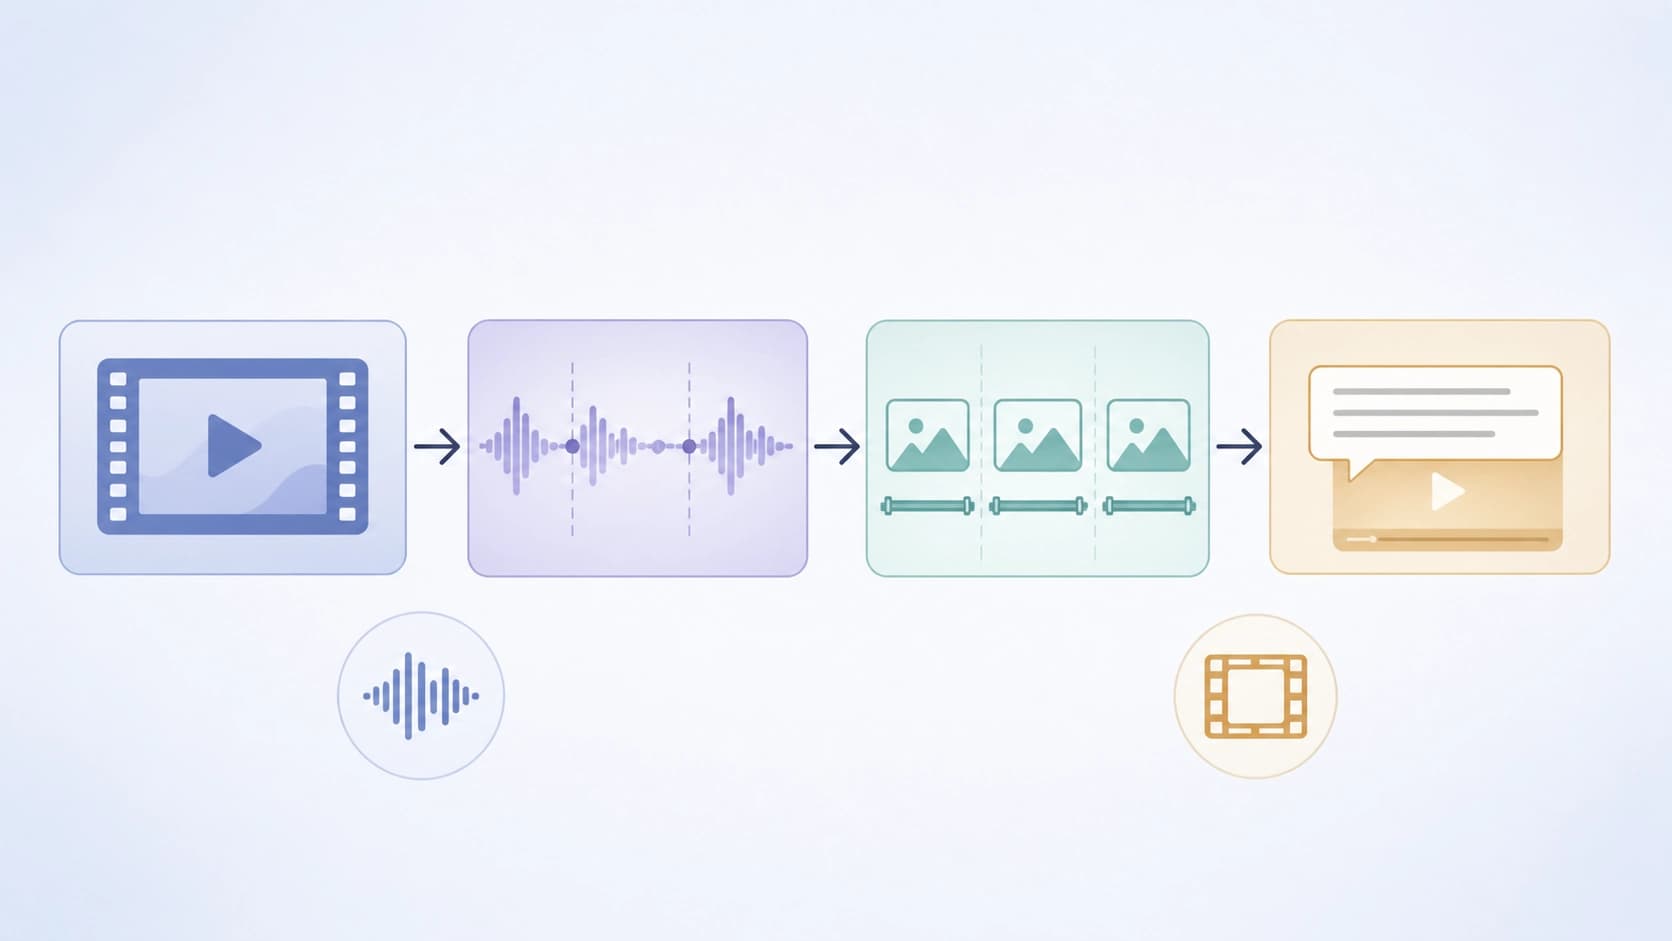
流水线由多个阶段组成,每个阶段都各有其重要性。首先,链接被筛选并统一格式。然后开始大规模下载。接着,内容感知的场景检测登场:长视频不是按固定时间码切分,而是按真实的剪辑接点来切割。
接下来是最有意思的部分。对于得到的片段,字幕是合成生成的、自动的,而且同时覆盖两种模态:与视频画面配对的文本,以及单独与音轨配对的文本。也就是说,音频在这里不是副产品,而是完整的训练信号。
最终的结构针对三种数据类型的同时预训练进行了优化:视频、音频和图像。
帧作为独立资源
作者们没有止步于片段。从场景中提取出对应切换时刻的帧,作为独立的“图像—文本”配对来源。逻辑很简单:视频画面提供了与普通网络图片集不同的视觉世界切面——有着不同的题材分布、视角和日常细节。对于图像检索任务来说,这种分布偏移可能比从与以往相同来源再添一百万张照片更有用。
实验展示了什么
视频与声音
在新语料库上训练的模型,在“视频—文本”和“音频—文本”的标准基准测试中达到了有竞争力的水平。更重要的是:随着数据量或模型规模的增加,质量持续提升。这正是区分一个“只是很大”的数据集和一个值得进一步扩展的数据集的关键特征。
图像
另一条实验路线是在提取的帧上进行训练。这里结果同样是正面的:在图像检索中表现强劲。而且帧的分布与常见的网络语料库明显不同——也就是说,收益并非来自体量本身,而是来自视觉数据的另一种特性。
值得记住的几点
- 字幕是合成的:它们节省了数千工时,但带来了噪声和系统性错误。在这里,过滤质量比语料库规模更重要。
- 构建从网页链接出发,因此会出现此类项目常见的问题:链接的持久性、原始来源的使用条款、署名。数据集的开放许可并不能消除对原始来源的疑问。
- 该语料库被声明为研究性发布——实际上这意味着入门门槛低于企业内部数据集,但他人结果的可复现性仍然需要亲手验证。
为什么这很重要
迄今为止,如此规模的开放多模态视频更像是一个承诺而非现实:学术数据集以数千小时计,而一切以百万计的都归公司所有,不对外公开。LAION-BVD改变了这个算术——也改变了那些构建自己模型的人的门槛。
实际影响有几点。第一,出现了公平比较的基础:如果大家都在同一个开放语料库上训练,关于谁的结果更好的争论就更有实质意义。第二,小型团队和大学有了替代租用他人嵌入的方案——可以训练自己的。第三,音频不再是视频的附属品,而获得了自己独立的训练路线。
现在主要的问题不是数据够不够,而是谁先学会清洗它们。合成字幕、数千万个视频以及样本中不可避免的垃圾,使过滤和质量评估成为整个计划的瓶颈。数据集已经开放——接下来一切取决于社区。