为什么要拆解流水线中的错误
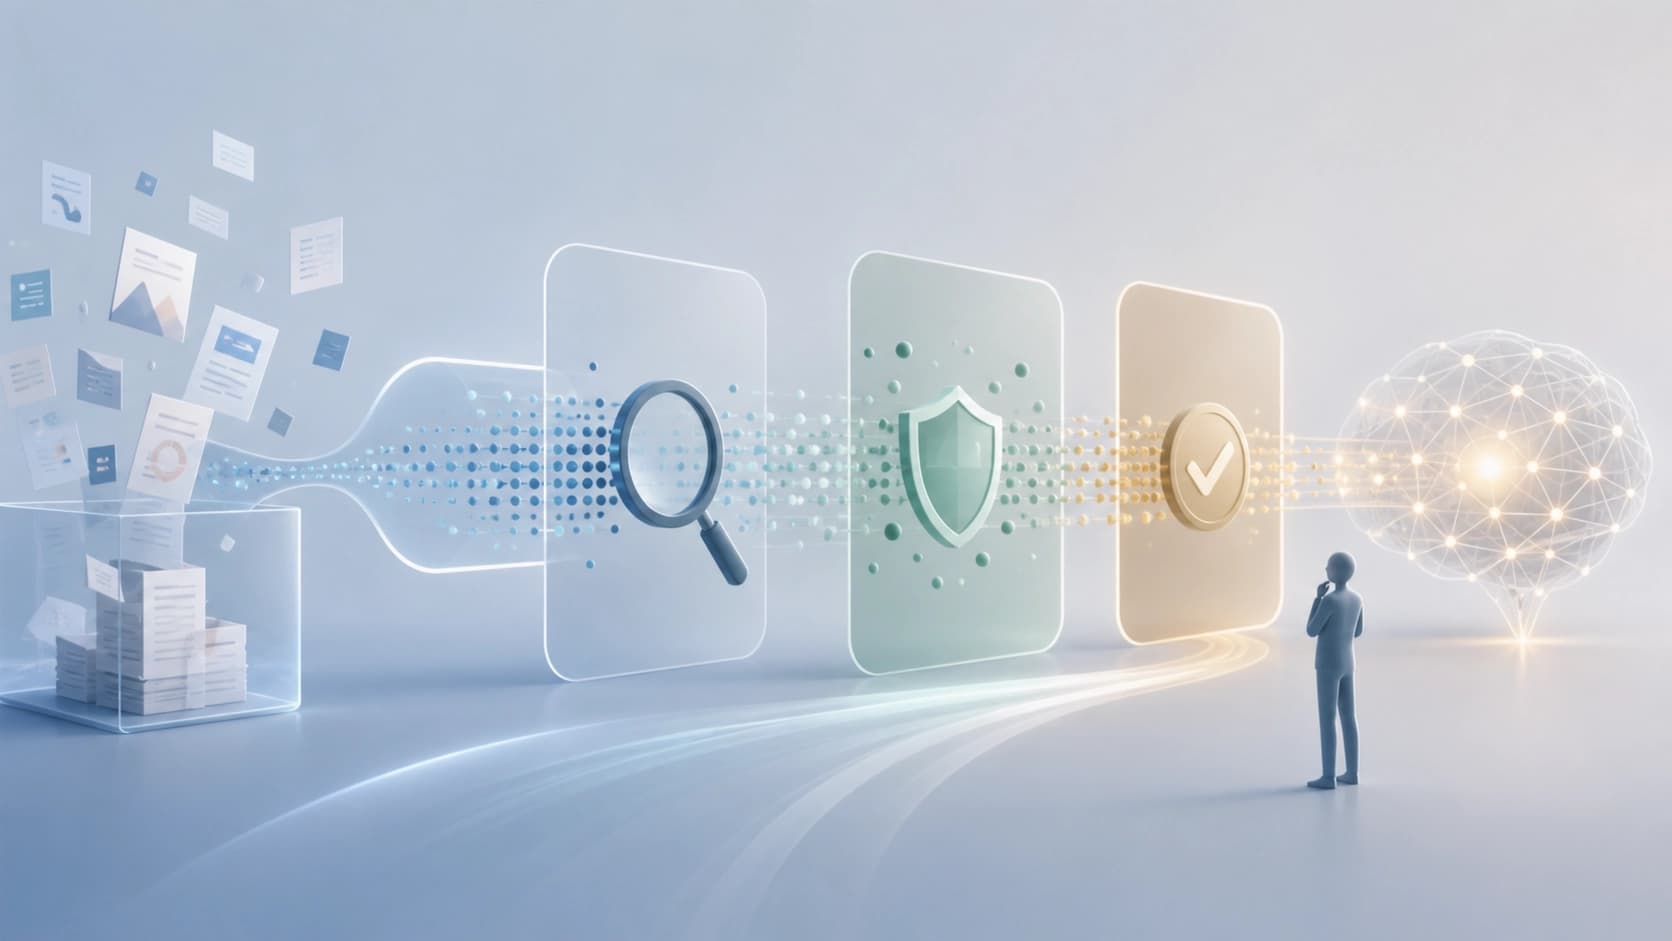
用单一数字来评估 RAG 系统虽然方便,但几乎没什么用。端到端指标回答的是“答案是否符合预期”,而不是“它为什么符合或不符合预期”。然而 RAG 并不是一个铁板一块的模块,而是一条链条:首先从库中检索到某些内容,然后系统判断检索到的内容是否足够,最后才由生成器写出文本。任何一个环节出问题,都会在输出端产生同样“错误”的答案,尽管这两类失败的成因可能截然相反。
The RAT: A Unified Bayesian Model for RAG Evaluation(arXiv:2608.24753,cs.CL 分类,2026 年 8 月 25 日提交)这篇工作正是针对这一问题。作者 Pius von Däniken、Felix Matthias Saaro、Mark Cieliebak 和 Jan Deriu 提出,不要整体地衡量流水线,而是将其描述为一个概率模型,其中每个阶段都是一个独立的随机变量,各自具有相应的关联。这样一来,对系统的评估就转化为一个推断问题:隐变量的哪些取值最能解释观测到的答案和标注。
贝叶斯框架究竟建模了什么
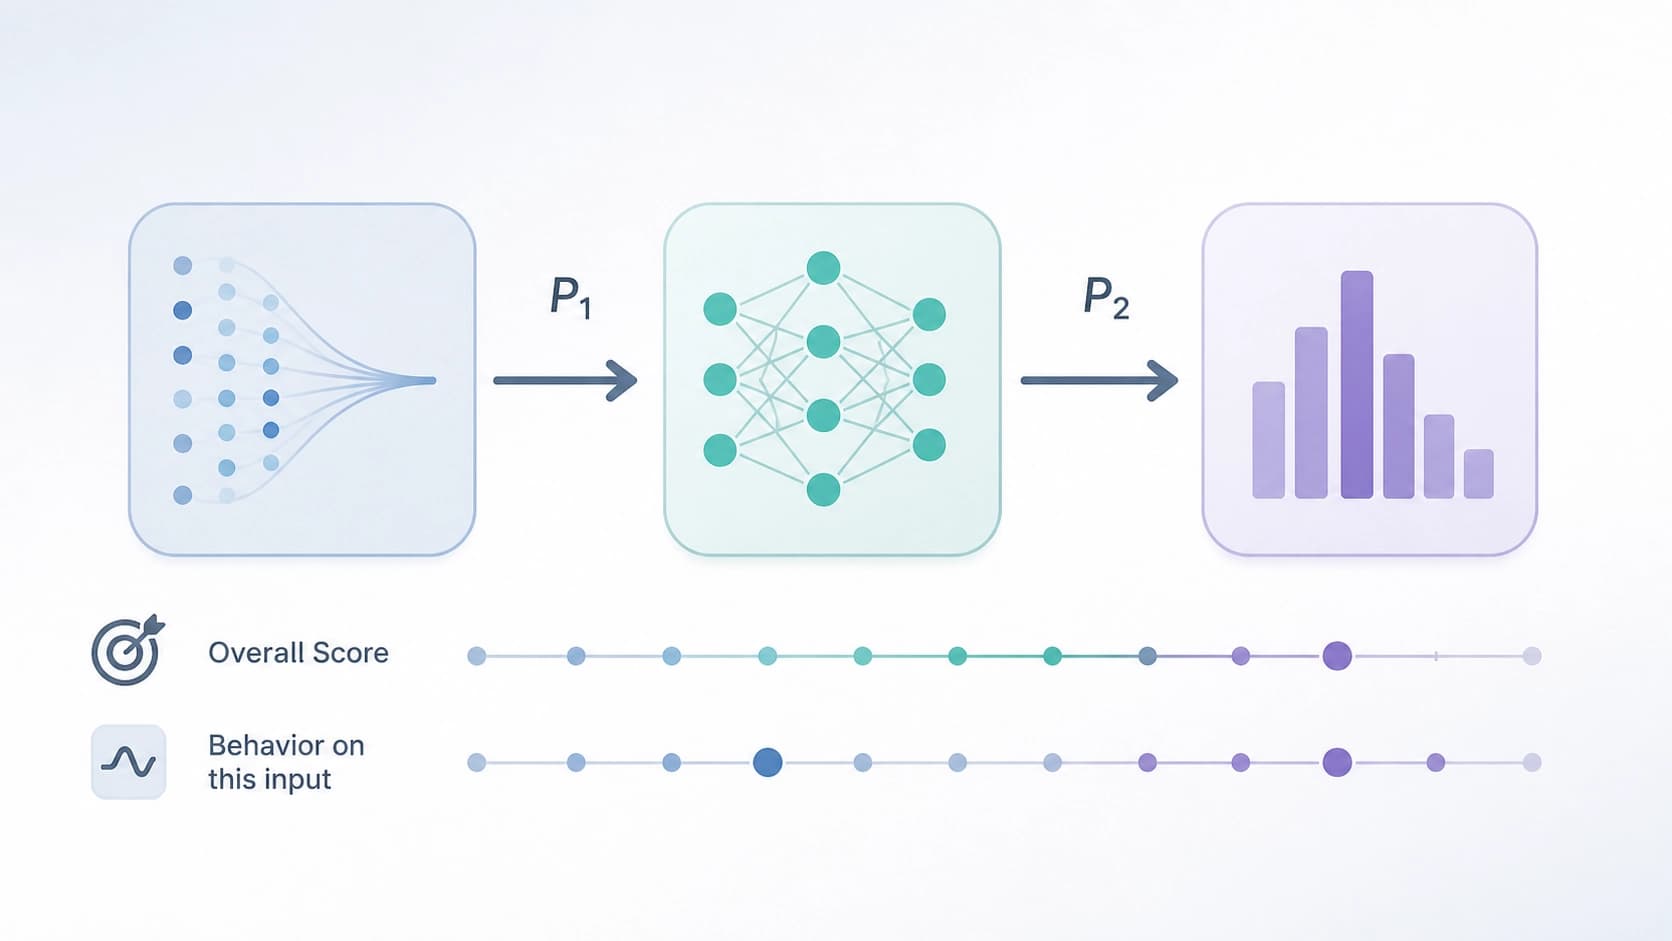
核心思路是按信息流进行因子分解。变量的引入不是机械地“按流水线组件”来划分,而是按照信息在系统中实际流动的顺序:检索的成功与否会影响生成器应有的行为,而生成器的行为连同检索的结果共同决定了最终答案的正确性。这样的结构使依赖关系变得显式,而不是隐藏在聚合指标之中。
由此,The RAT 模型得到了三个有实质意义的层次,而它们通常会被合并成一个指标。
任务成功与生成器成功是两个不同的问题
第一层是 task success(任务成功):用户最终是否得到了正确的答案。第二层是 generator success(生成器成功):在给定输入的情况下,生成器的行为是否得当。形式上,后者是一种条件质量:模型的行为相对于给定的检索结果是否恰当,而不是泛泛而言。
这一区别至关重要。系统可能在不佳检索的情况下给出正确答案——生成器凭借参数化记忆猜对了。形式上这是任务成功,但行为却是不当的:系统在回答时并未依据来源,而在另一个查询上,这种习惯会演变成幻觉。反之亦然:检索找到了所有需要的内容,生成器也谨慎作答——但最终结果仍然错误,因为问题被理解错了。端到端指标无法区分这两种情况,条件指标则可以。
弃答不是故障,而是一种决策
模型的第三个要素是 abstention behavior(弃答行为)。在 RAG 语境下,拒绝作答有时是唯一正确的反应:如果库中没有任何相关内容,诚实的“我不知道”胜过自信的编造。但当所需文档已被检索到,而系统却未加以利用时,同样的拒绝就变成了错误。
因此,弃答不能脱离检索结果来评估——只能条件地评估。The RAT 模型直接考虑了这一点:它考察拒绝或作答这一事实是否与上下文中实际存在的内容相匹配。这种视角对产品决策也有用:如果系统在检索成功时大量弃答,问题不在生成器,而在于上下文是如何传递给它的。
为什么边际指标会骗人
作者将该框架应用于 27 种配置——即三个数据集、三个检索器和三个生成器,穷举了所有组合。这里的全排列并非目的本身:它展示了当恰好一个环节发生变化、其余保持不变时,分解会如何表现。
这项工作的核心结果:条件分解能揭示出那些在边际指标上看起来等价的系统之间显著的行为差异。两条流水线可能显示出相同的正确答案比例,却在错误发生的具体位置——检索、弃答策略还是生成——上相差数十个百分点。对于为产品选择配置的人来说,这是不同的系统;对于只看表格中一个数字的人来说,它们是一样的。
标注预算该花在哪里
这项工作的另一部分专门讨论标注的分配。标注成本高昂,因此很自然会问:如果只能对每个样本向人工提一个问题,该选哪个问题?
作者的回答是:如果目标是评判系统对策略的遵守情况(policy adherence),那么关于检索成功的标注比关于任务成功的标注信息量更大。原因不在于便利性,而在于模型的结构:检索标注落在因果链起点的变量上,因此它也能“照亮”下游各层。最终成功的标注针对的是输出端的变量,它对内部发生了什么说明得少得多。作者为这种非对称效应给出了信息论层面的解释。
实践结论很简单:如果预算有限,应该问标注者的不是“答案是否正确”,而是“是否找到了所需内容”。前者在报告中听起来更悦耳,后者对诊断更有用。
LLM 评判者作为带噪观测
第三部分是将模型扩展到自动评估。The RAT 的方案允许将 LLM-as-a-judge 的裁决接入,不是作为人工的替代,而是作为经过校准的带噪观测:评判者有其自身的出错概率,且该概率在同一概率模型框架内被估计。
这消除了“昂贵的人工标注对抗廉价的自动评估”这种人为对立。在同一个模型中,既可以保留一小批专家判断语料来设定尺度和校准,又可以保留大量自动评估流来细化参数。评判者不再是神谕,而成为又一个信号来源——其误差是已知的,且重要的是,是可测量的。
可以带进自己实践的东西
- 不要把流水线当作一个节点来计数。 一旦报告中出现针对检索的单独指标、针对生成器行为的单独指标和针对弃答的单独指标,“哪里坏了”的争论就会变成诊断,而不是假设的穷举。
- 条件地评估行为。 答案的正确性与给定上下文下行为的恰当性是不同的问题,好的结果并不能为糟糕的过程开脱。
- 按切片而非平均值来构建报告。 两个端到端质量相同的系统,可能需要完全不同的改进。
- 选择标注什么。 如果人力资源有限,对早期阶段的标注能提供关于系统整体的更多信息。
- 给自动评估拴上绳子。 LLM 评判者作为带有误差模型的观测是有用的,而不是作为最终真理。
这里的贝叶斯视角价值不在于数学本身,而在于思维的纪律:它迫使你事先说清楚哪些量是隐藏的、哪些是可观测的,以及一个如何与另一个相关联。此后,任何一张结果表格都不再是一堆数字,而是对系统如何做出决策的描述。