短推理链并不总是最优
经过“出声思考”训练的大模型,依靠长推理链取得优势。任务越复杂,模型在给出答案前写下的中间步骤就越多。通常被认为对这种质量至关重要的机制之一,是自我反思:回顾已经完成的步骤、发现错误并重写解题过程的能力。
问题在于,这种能力是有代价的。每一次重新审视,都意味着推理时额外的 token,也就是金钱、时间和算力。而直到不久前,还没有人真正解释清楚,模型“停下来重新检查自己”的决定究竟由什么驱动。自我反思就像是黑箱中的黑箱:我们知道它有效,却不知道它如何运作。
Ge Yan、Chung-En Sun、Linbo Liu 和 Tsui-Wei Weng 的论文(arXiv:2512.13979,已被 COLM 2026 接收)从意想不到的角度切入这个问题——不是通过提示词,也不是通过微调,而是通过模型的潜在表示。
模型内部的反思方向
寻找什么,发现了什么
研究者将 representation engineering 的方法应用于自我反思——这一方向研究的不是模型输出的文本,而是其内部激活。逻辑很简单:如果模型“决定”进行反思,那么这个决定一定反映在它的表示中。也就是说,它可以被找到、被描述,而且——最关键的是——被利用。
事实果然如此。在潜在空间中发现了这样一个特定方向,沿着它,带反思的步骤与不带反思的步骤得以区分。本质上,这是一条“重新检查 / 不重新检查”的轴,而点在这条轴上的位置能够稳定地区分两类步骤。
反思由不确定性主导
论文中最有趣的观察是:沿所发现方向的激活幅度,能够很好地预测最终答案是否正确。换句话说,反思并非随机触发,也不是按计划触发——它与模型内部的不确定性相关联。当模型“感觉”到情况棘手时,它会停下来重新审视;当一切清晰时,它便继续前进。
这是认知图景中的一次重要转变。反思不再是一种需要单独培养的能力,而更像是一种信号——表明模型对自己这一步心存疑虑的指示器。
ReflCtrl 是如何构建的
如果关于反思的决定存在于激活之中,就可以直接对它施加影响——通过干预表示,而不是重写提示词。ReflCtrl 正是建立在这一基础之上:一个通过 steering——沿所发现方向移动激活——来管理自我反思的框架。
关键细节——究竟在何时干预
最朴素的做法显而易见:在每一个生成的 token 上都施加所需的偏移。这也是最先想到的做法——而恰恰是它效果不佳。对表示的持续施压会损害生成质量:模型失去连贯性,因为干预也发生在毫无意义的地方。
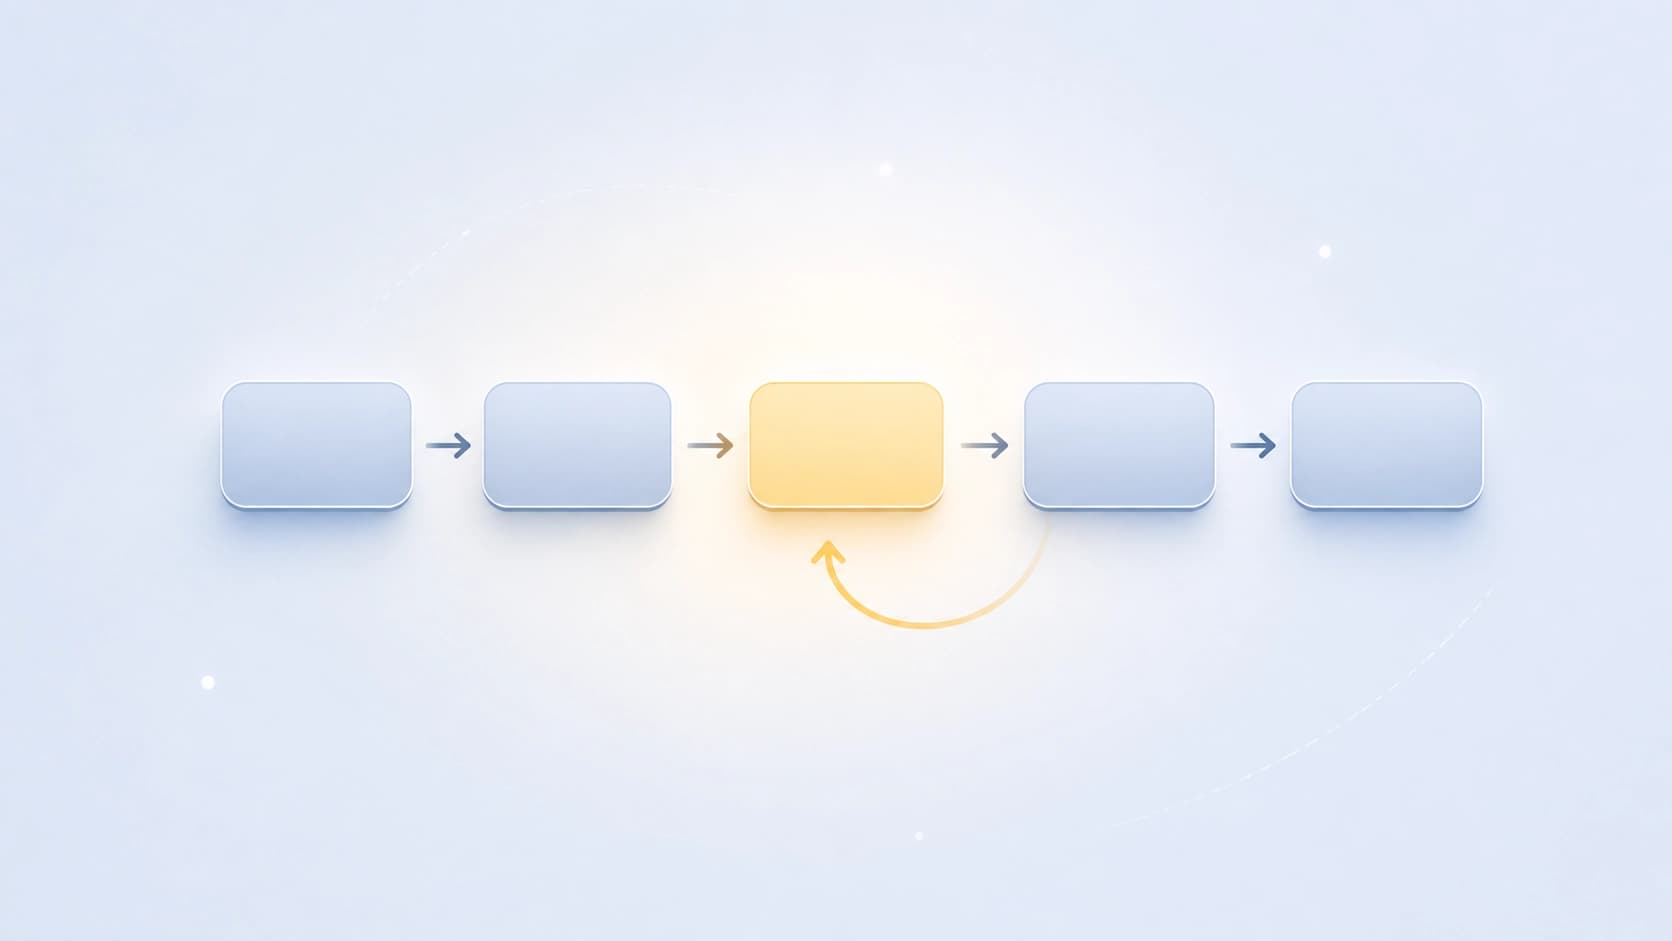
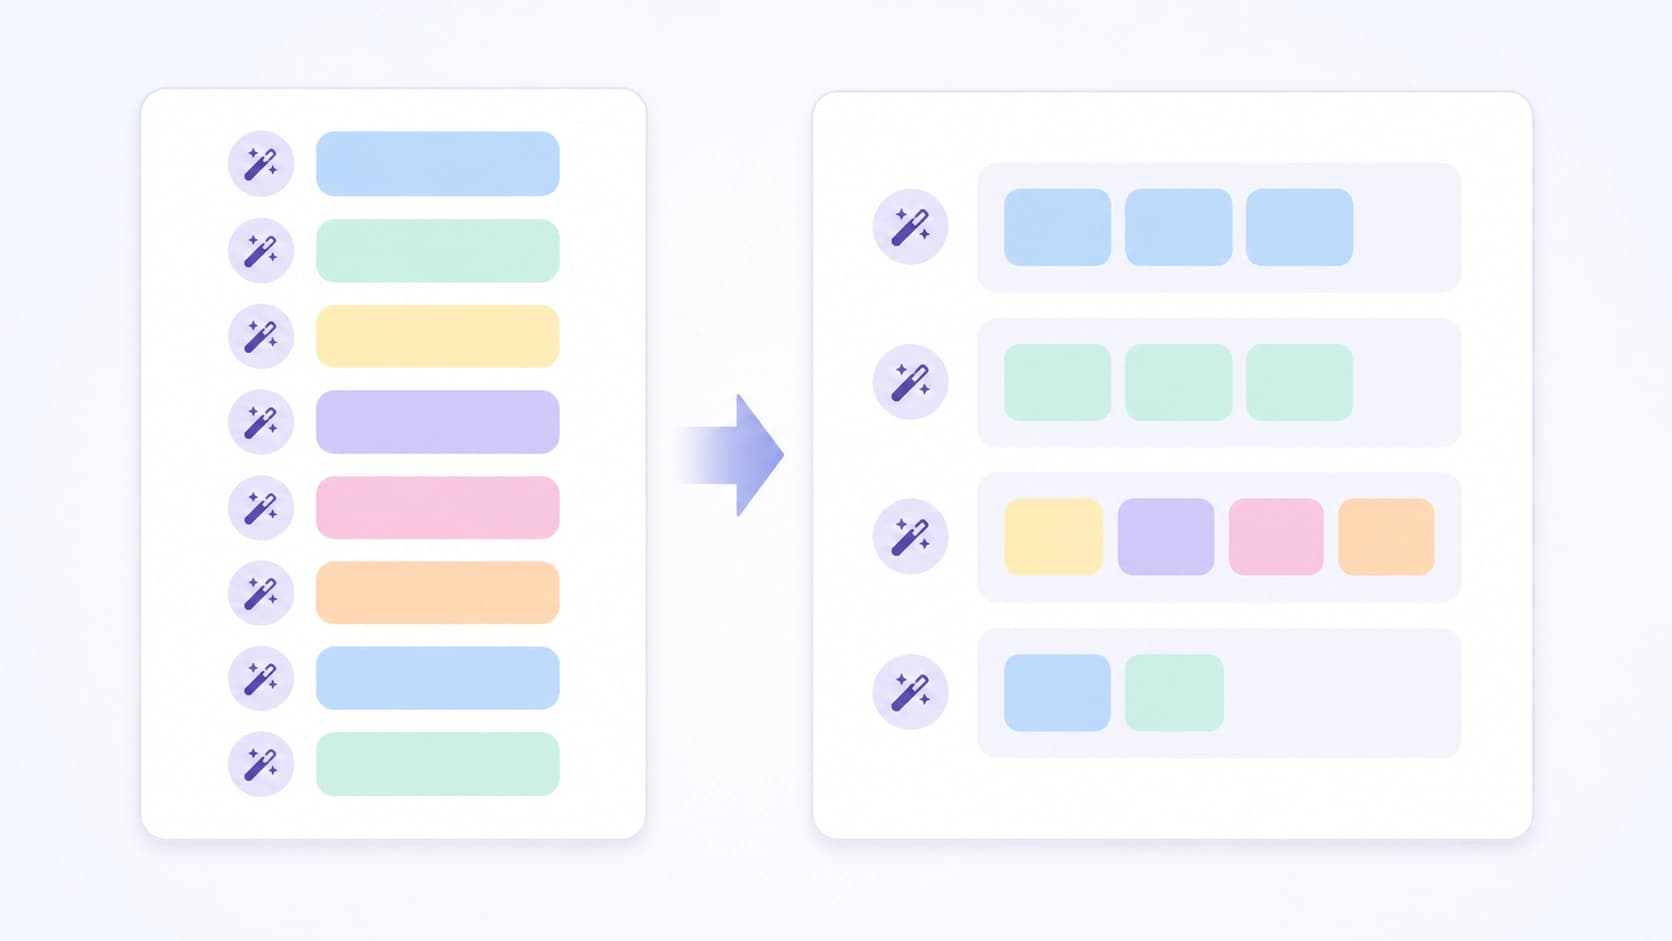
作者提出了逐步(step-level)方案。干预只施加一次——在每个新推理步骤的最开始。之后,模型自由地生成该步骤的 token,不受干扰。这样就实现了精细调控:反思的频率改变了,而步骤内部的思路本身保持原样。
正是这种组合——用罕见、精准的干预取代持续干预——带来了主要的收益。
实验展示了什么
测试在数学推理和通用推理基准上进行。结果得出了一个对行业而言相当尴尬的结论:反思往往是多余的。
- 推理 token 数量最多可削减至原始规模的 43.2%——同时保持准确率。
- 在更强的模型上效果尤为明显:模型越强,它就越频繁地无谓地重新检查自己。
- 在 token 预算相当的情况下,逐步 steering 明显优于传统的逐拍 steering。
第二点和第三点是相关的。强模型对自己的步骤更有信心,因此它的反思更常成为空转——而逐拍 steering 恰恰苦于无法及时停下。
为什么这在实验室之外也很重要
推理的经济账并非抽象概念。长推理链会推高推理账单、增加延迟,并限制现有硬件究竟能处理多少请求。如果几乎一半的“思考”可以在不损失质量的情况下被去掉,那就是规模上的直接节省。
还有一层不那么明显的意义。这项工作表明,模型行为可以在表示层面进行调节——比提示词更温和、更精准,也比微调更便宜。可控性正在成为一个独立的工程维度:不是“在指令里写什么”,而是“把激活往哪里移、在什么时刻移”。
最后,这也是对可解释性的贡献。我们越来越清楚,当模型停下来对自己说“让我重新看看”时,内部究竟发生了什么。
开放问题
适用边界目前尚未完全厘清。沿单一方向的 steering 是一种狭窄的工具:它能很好地捕捉所发现的反思轴,但对于其他类型的自我纠错该怎么办,尚不清楚。还有一个问题是,所发现的方向在不同架构之间的可迁移性如何:每个模型都有自己的表示,为一个模型有效的向量未必对另一个模型有用。
在错误代价高昂的任务上,节省与可靠性之间的权衡也尚未完全明晰。在保持平均准确率的同时削减 43.2% 的 token 是强有力的结果,但平均准确率并不等于不存在罕见的灾难性失败。如何区分“多余”的反思与那唯一能挽救答案的反思,很可能是这一研究方向的下一步任务。