
如何从 DALL- E 3 开始 : 从设置到完成图像的一步步向导
神经网络OpenAI从文本描述中创建图像. 我们分解了如何获得访问,如何精心制作一个提示,并下载结果,以及哪里有免费的选项.
什么是DALL-E 3,它在哪里工作
DALL-E 3 是OpenAI的基因图像模型的最新版本. 它将纯文本描述变为现成的图片,而且它比其前身更明显地准确。 关键区别在于与聊天界面的内置整合:您不仅可以发送一个即时,还可以与神经网络讨论,澄清细节,一步一步地指导生成过程. 因此,模型从一个简单的生成器转变为一个具有对话模式的完整的插图.
可以通过付费计划获得该模型。 对于个人用户来说,最明显的选择是ChatGPT Plus订阅,每月20美元. 它允许您每3小时创建多达50幅图像,使其既适合常规实验,也适合商业任务. 企业可以报名参加企业法人计划,具体讨论条件. 如果你还不想付钱,有一条更轻的路径——免费的第三方网站与模型合作. 它们通常有日常的生成限制,但对于第一次尝试来说就足够了.
连接并开始生成
选择访问方法
首先,决定你在哪里工作。 如果您需要完整的功能集和无缝聊天集成,请在 官方OpenAI网站. 付款后,可进入 DALL-E 3 将会在您的账户中打开 —— 该模型已经整合到聊天界面中 。 为了快速测试,没有注册,像dalle3.org这样的网站运作良好. 这类平台通常不需要银行卡,但每天的尝试次数有限——尽管如此,还是可以弄清楚这种互动风格是否适合你.
登录到您的账户并发送您的第一个请求
订阅者只需要到ChatGPT网站开始新的对话. 在那里,你会看到一个常规的输入字段——这就是你输入你的提示的地方. 界面还让你请模型帮助措辞:写下"在开花的森林里与宇航员一起详细描述一个场景"——神经网络将建议扩展版本的请求,然后可以直接发送到一代人. 第一个图像会在几秒钟内出现,之后你要么保存它,要么继续完善细节.
如何制定提示和完善结果
细节最重要
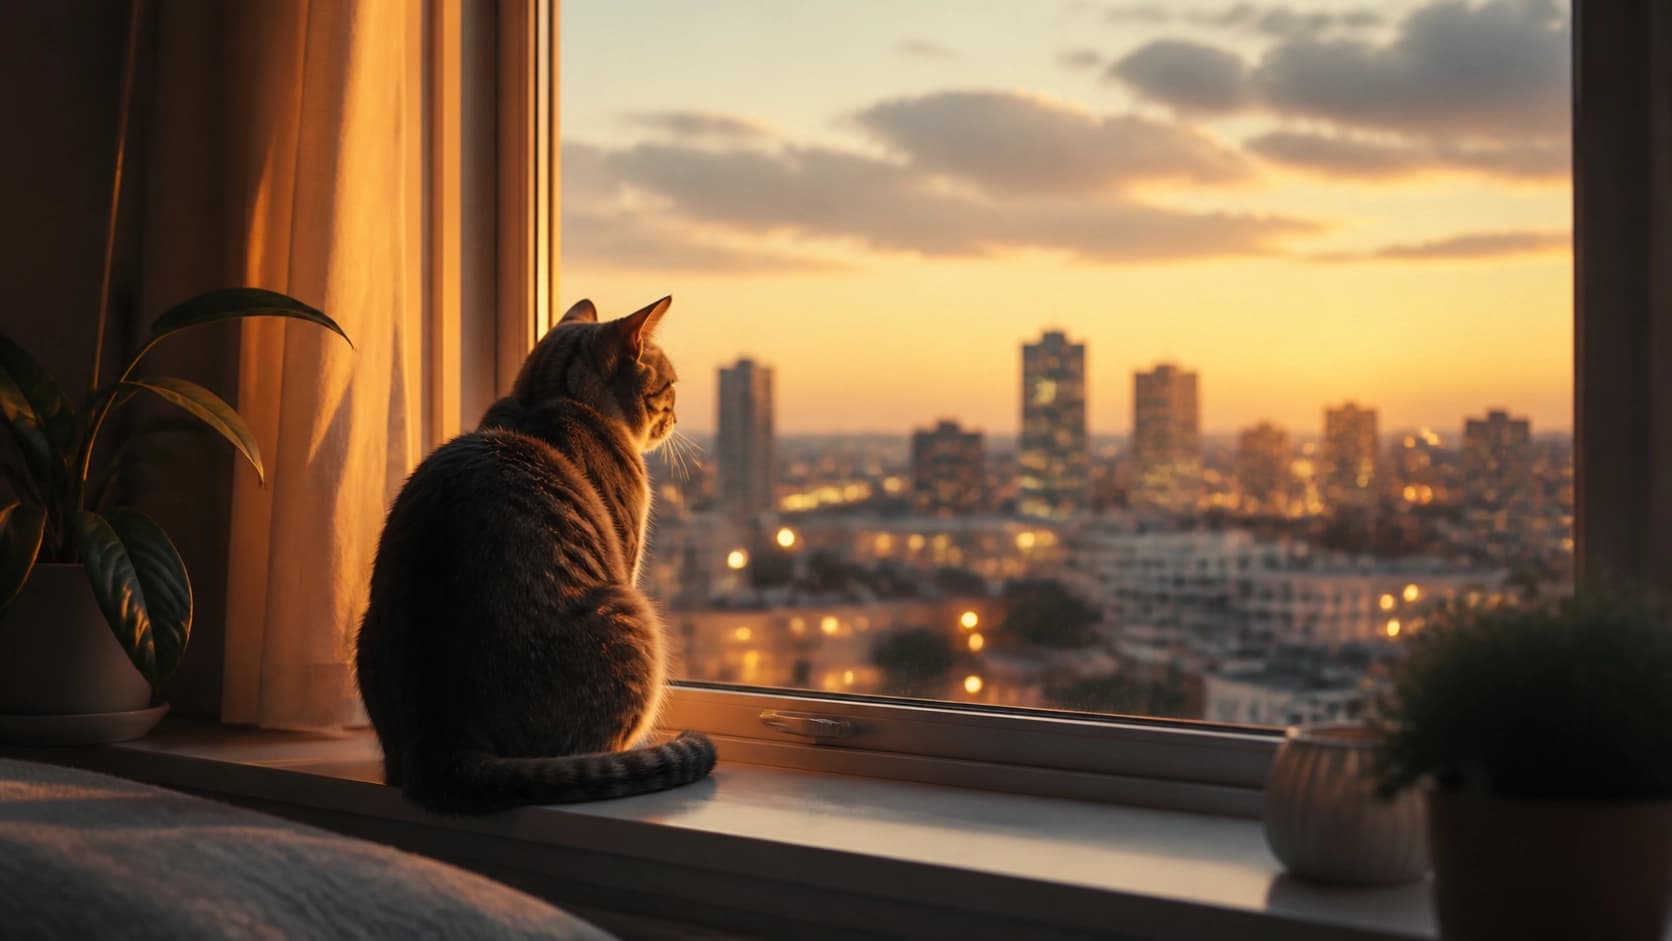
DALL-E 3 对丰富的描述有很好的理解,但没有具体内容,结果往往模糊不清。 指定颜色、大小、材料、照明、物体放置、甚至心情。 与其说"画一只猫",不如写"一只灰色的条纹猫躺在窗台上,晚光照亮,城市在窗外,数字绘画风格". 模型将此类细节转化为精确的视觉元素. 如果你不确定如何构建一个快件,你可以向ChatGPT请求帮助——它会将一个短请求重写成一个详细的场景,重复的回合会更少.
精炼和下载
默认情况下,DALL-E 3会为每个请求产生两个图像变体. 如果其中之一已经工作了——很好,你可以直接移动到下载. 但更常见的是,你会想改变一些东西:颜色,背景,人物姿势,或构成. 与其从零开始,只需在谈话中写出要修补的内容,模型会根据你的编辑内容重新绘制图像. 你可以继续对话 直到得到你想要的结果 一旦图像准备就绪,点击下载图标——文件将高质量地保存到您的设备中.
在哪里使用生成的图像
这些图片的应用范围实际上是无限的. 在营销中,它们被用于社交媒体,广告横幅,以及事件公告. 设计者用它们作为概念、演示和模型的基础。 世代也用于在服装,杯子,贺卡等个性化产品上创造指纹.
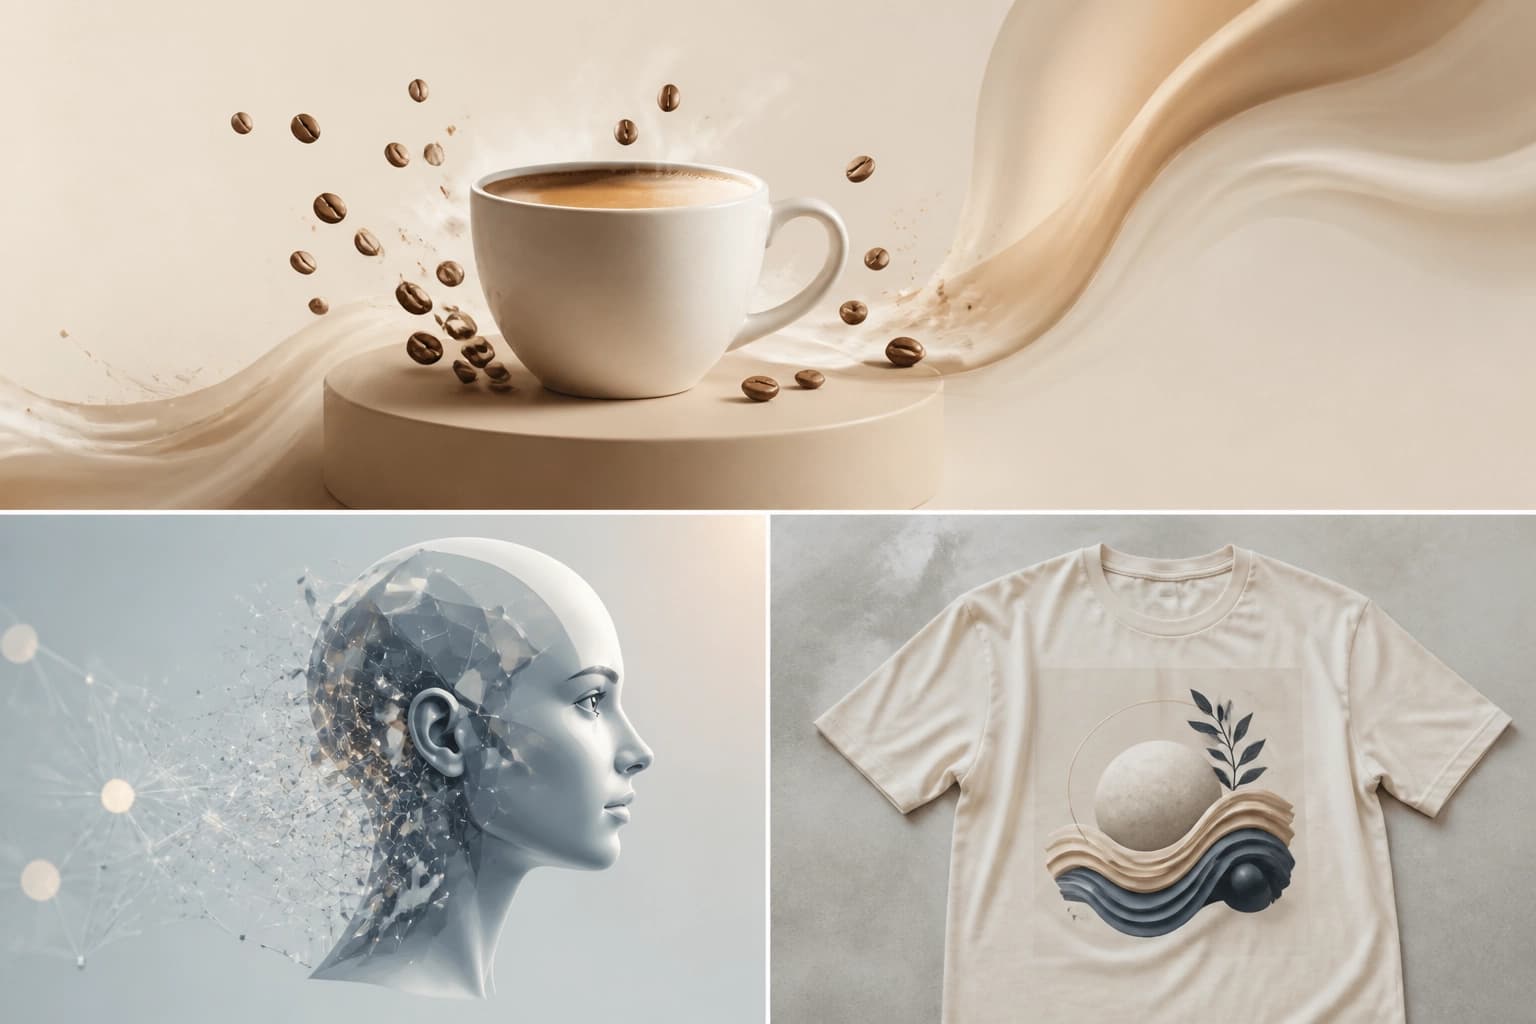
在教育方面,这种图像有助于为课程和课程以及媒体和娱乐制作视觉材料——以说明文章、录像、封面和游戏概念艺术。 最主要的是总是检查结果是否与任务相符,在对话中毫不犹豫地加以完善,因为正是互动微调的能力使得与这个模型的合作变得如此方便.
常问问题
相关材料
所有材料
GoldiMask 扩散语言模型微调方法:上下文选择与目标加权
本文提出 GoldiMask:一种面向离散扩散语言模型的监督微调方法,通过近似最大化子模函数来选择可见词元,并根据其训练效用为其余目标分配权重。在多个模型和数据集上的实验表明,该方法提升了平均准确率和逻辑推理、编程任务的表现,并在 GSM8K 和 MATH-500 上以相近的性能减少了并行解码迭代次数。
30 十月 2026
Google Research 的 MSEB:符合基准测试约定的音频编码器实现及其在四类任务上的评估
对 mseb==0.1.0 软件包的实用解析:介绍 types、encoder 和 evaluators 分层架构,在合成语料库上演示两个编码器,并直接调用分类、聚类、检索和分割指标。本文展示如何让自定义模型适配抽象的 MultiModalEncoder、解读 SoundEmbedding 格式,以及构建 TaskMetadata 以便后续提交至基准测试。
10 十月 2026
零基 LoRA:在 RL 后微调 LLM 而不丧失推理能力
作者提出了一种参数高效的适配方法:将 LoRA 更新投影到推理激活的近似零空间中。该方法能够将推理准确率保持在微调前的水平,同时适配质量不逊于常规 LoRA。
5 十月 2026