为什么 RL 后的 SFT 会威胁推理能力
强化学习能够提升大型语言模型的推理能力。这种方法已成为 LLM 后训练的有效方式。后续的监督微调会让经过 RL 的模型适应新的知识领域或行为类型。这样的 SFT 可能会严重覆盖已获得的能力。
现有的减轻遗忘方法包括:
- 重放经验;
- 专门的初始化;
- 带梯度投影的受限优化。
这些方法要么只能有限地保留能力,要么需要大量额外计算。实用判断标准:对于经过 RL 的模型,应选择能够降低推理能力被覆盖风险的方法。
将零空间用作适配资源
作者表明,与推理相关的激活集中在低维子空间中。零空间仍保留了大量可用于适配的容量。通过少量样本即可可靠地估算近似零空间。
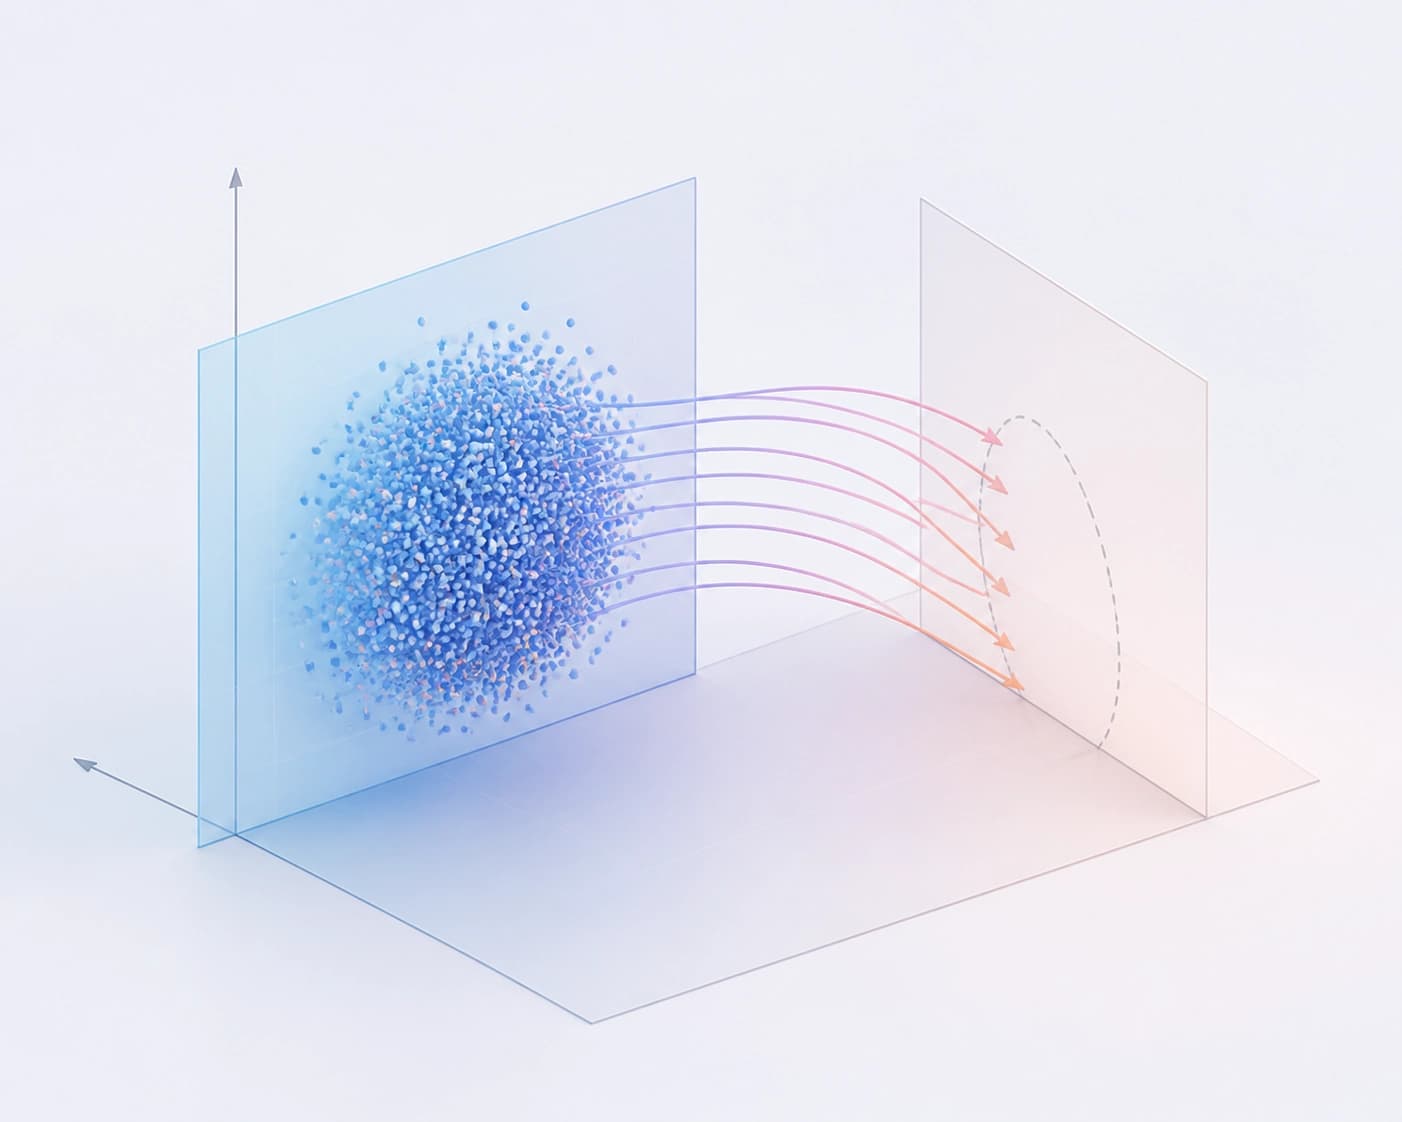
实用判断标准:在零空间中构建更新的方法能够利用闲置容量,而不会影响推理激活。
NB-LoRA 的设计
Null-Basis Low-Rank Adaptation (NB-LoRA) 是一种用于后 RL LLM 的参数高效适配方法。该方法由论文 arXiv:2609.25618 提出,能够保留已获得的推理能力。
工作步骤:
- 根据推理激活构建一个固定的近似零基。
- 通过该基对 LoRA 更新进行重新参数化。
- 将保留推理能力表述为对层级隐藏状态保持不变的约束。
- 在整个微调过程中遵守该约束。
实用判断标准:如果需要进行 SFT 并保留后 RL 模型的推理能力,可以选择 NB-LoRA。
与现有方法的比较
下表比较了机制和特点。
| 标准 | 现有方法 | NB-LoRA |
|---|---|---|
| 机制 | 重放经验、专门的初始化、带梯度投影的受限优化 | 通过固定的近似零基对 LoRA 进行重新参数化 |
| 特点 | 能力保留有限,或需要大量额外计算 | 对层级隐藏状态保持不变的约束 |
实用判断标准:如果优先考虑保留推理能力,NB-LoRA 提供了内置约束。现有方法则需要在有限的能力保留和额外计算之间作出选择。
实验结果与选择标准
实验涵盖了多个经过 RL 训练的 LLM 和各种后续任务。NB-LoRA 的适配质量与标准 LoRA 相当。该方法能将推理准确率保持在接近微调前的水平。这种保留效果也能迁移到留出的推理基准测试中。
实用判断标准:对于 SFT 可能威胁推理能力的后 RL LLM,NB-LoRA 值得在自己的任务上进行测试。