
GoldiMask 扩散语言模型微调方法:上下文选择与目标加权
本文提出 GoldiMask:一种面向离散扩散语言模型的监督微调方法,通过近似最大化子模函数来选择可见词元,并根据其训练效用为其余目标分配权重。在多个模型和数据集上的实验表明,该方法提升了平均准确率和逻辑推理、编程任务的表现,并在 GSM8K 和 MATH-500 上以相近的性能减少了并行解码迭代次数。
掩码策略同时决定两件事
离散扩散语言模型的微调依赖于恢复被掩码的 token。部分回答 token 会被掩码遮住,模型根据可见上下文预测它们的原始值。
掩码策略同时决定两件事:它规定模型可以利用哪些上下文,也规定哪些 token 会成为预测目标。
这两项决定彼此关联:一个 token 一旦被揭示,就不再是预测目标。均匀随机掩码没有考虑这种关联。因此,有些 token 会在几乎无助于预测的情况下被揭示。
GoldiMask 方法见论文《利用上下文选择和目标加权微调扩散语言模型》(Fine-Tuning Diffusion Language Models with Context Selection and Target Weighting,arXiv:2609.38385,2026 年 9 月 29 日)。该方法面向离散扩散语言模型的监督微调。
| 决策 | 均匀随机掩码 | GoldiMask |
|---|---|---|
| 揭示哪些 token 作为上下文 | 随机选择 | 根据子模目标函数选择 |
| 剩余目标 token 的权重 | 与所选上下文无关 | 取决于上下文带来的帮助和学习潜力 |
| 两项决策之间的关联 | 不予考虑 | 通过模型信号加以考虑 |
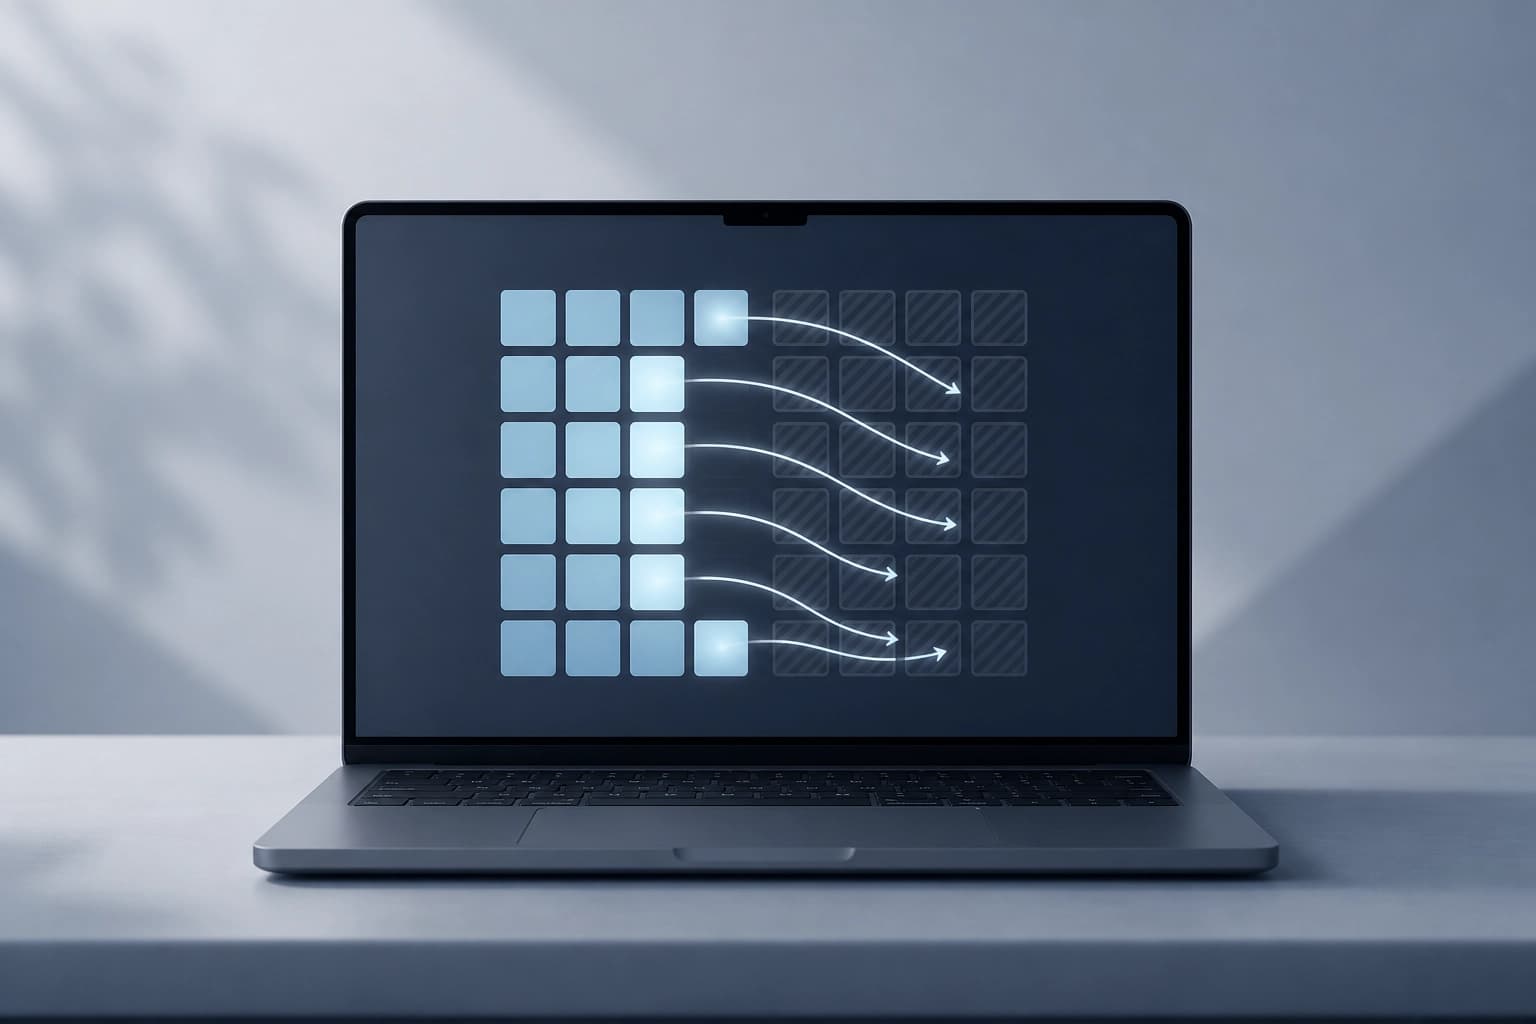
判断标准:应将掩码策略视为对上下文和目标的一项整体决策来评估。这样才能看出哪些 token 值得揭示,哪些则不值得。
根据模型信号筛选上下文
GoldiMask 会选择要揭示为上下文的 token。其选择近似于最大化一个子模目标函数。
该方法利用模型信号,在以下两项之间取得平衡:
- 揭示某个 token 所带来的收益;
- 该 token 作为预测目标的价值。
有助于预测周围内容的 token 值得揭示。模型难以预测的 token 则更适合保留为目标。
实践判断标准:随机筛选上下文不会利用模型信号。如果采用的正是这种方案,就没有发挥上下文筛选的潜力。
对目标 token 加权
筛选上下文后,部分 token 会继续作为预测目标。GoldiMask 会根据两个因素为它们加权:
- 所选上下文对预测特定 token 的帮助程度;
- 该 token 尚存的学习潜力。
这样一来,权重就将目标与已经做出的上下文决策关联起来。加权不会决定揭示哪些内容,而是决定那些仍被遮住的 token 对训练的贡献。
判断标准:分析掩码策略时,最好将两个问题分开考虑——揭示什么,以及如何为剩余内容的学习设置权重。
在模型和数据集上的结果
GoldiMask 在三个基础模型和三个训练数据集上进行了测试。在大多数评估设置中,该方法的平均准确率最高。
该方法在推理和代码生成任务上均取得了提升。组件消融实验表明,两种机制都对提升有所贡献:上下文筛选和目标 token 加权。
实践判断标准:在大多数设置中取得最高准确率,并不意味着每种配置都能获益。是否采用该方法,应针对具体的“基础模型 + 训练数据集”组合进行验证。
对并行解码的影响
另一项结果涉及带置信度阈值的并行解码。在 GSM8K 和 MATH-500 上,GoldiMask 减少了解码迭代次数。
在更高的置信度阈值下,准确率仍然保持在相近水平。
实践判断标准:如果流程中采用带置信度阈值的并行解码,该方法会同时影响解码步数和准确率。因此,仅依据准确率进行评估并不全面。
常问问题
相关材料
所有材料
医疗 LLM 能获知指南更新,却常常仍按旧规则回答
ChronoEvo 对 1709 项临床指南变更的研究显示:在基础模型中,90.8% 的回答记录了新变化,但只有 58.5% 完整应用了这些变化;这一差距达 32.3 个百分点,并且在 14 个模型中均存在。即使提高更新内容的显著性,也未能显著提升将新规则完整纳入临床指南的比例。
4 十一月 2026
封闭式 LLM 智能体的世界模型:在风险点进行校正
提出了 PAWM——一种外部预测器,不会重复逐步观察,而是在可能发生故障时介入,引导智能体避开错误操作。经过基于合成场景的 SFT 和 GRPO 协同训练后,该方法使 Claude Sonnet 4.5 在 ScienceWorld 和 WebArena-Lite 上分别提升了 24.3% 和 7.7%。
4 十一月 2026
SpeechLLM 上的分类头:在情感识别中,它在哪些方面优于标签生成?
基于 IEMOCAP 和 MELD,比较了紧凑型 SpeechLLM 的情感标签生成输出与基于其隐藏表示的线性分类器。分类器带来的性能提升并非普遍存在:它取决于语料库,以及使用的是参考转录文本还是 ASR 输出。
4 十一月 2026