长编码任务不是一次请求,而是几十次:模型调用、工具访问、文件修改、反复运行测试。几乎每一次这样的运行中都会冒出一个念头:要不要现在就换个模型?
为什么中途切换看起来划算
账其实很简单。强模型每 token 更贵,但推理更好。弱模型更便宜,但在复杂问题上会卡住。由此产生两种自然的操作:
- 升级 —— 当便宜模型卡住时,接入昂贵而强大的模型。
- 降级 —— 当困难部分过去后,回到便宜模型,以免为常规工作多付钱。
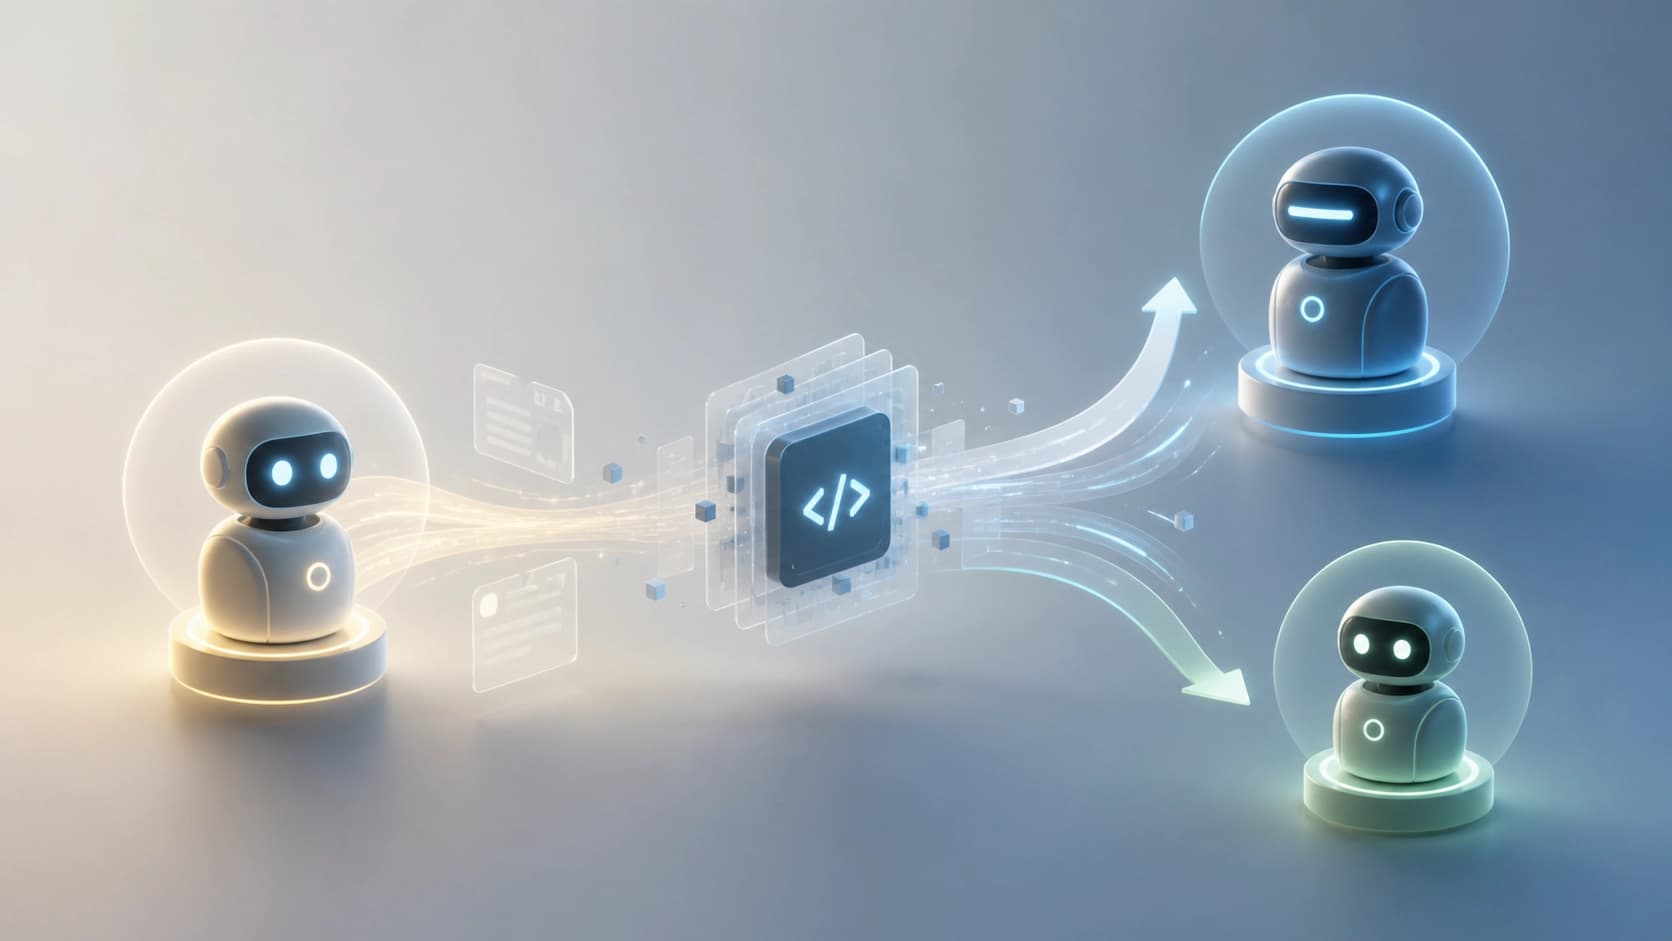
纸面上看,混合路线堪称完美:昂贵模型只在真正需要的地方付费。但智能体传给下一个模型的不只是文件和仓库状态。它传递的是历史:推理链、工具输出、死胡同式的尝试、中间决策。接收方延续的是另一个模型构建的轨迹——不同的风格、不同的细致程度、不同的习惯。这正是预印本《The Handoff Tax: Continuing Non-Native Trajectories in LLM Agents》(arXiv:2608.24358,2026年8月25日)的作者所剖析的关键点。
实验是如何设计的
这项研究基于成对的模型:便宜且能力较弱的(文中称为 LC,low cost)对比昂贵且更强的(HC,high cost)。这些配对取自两个家族——Claude 和 GPT,也就是说检验不是在一家厂商上进行的,而是同时在两家上,这显著提升了结论的价值。
他们改变了三件事:
- 传递方向 —— 向上,传给更强的模型;向下,传给更弱的模型。
- 长任务中切换的时机。
- 上下文传递格式 —— 也就是作者所称的接口。
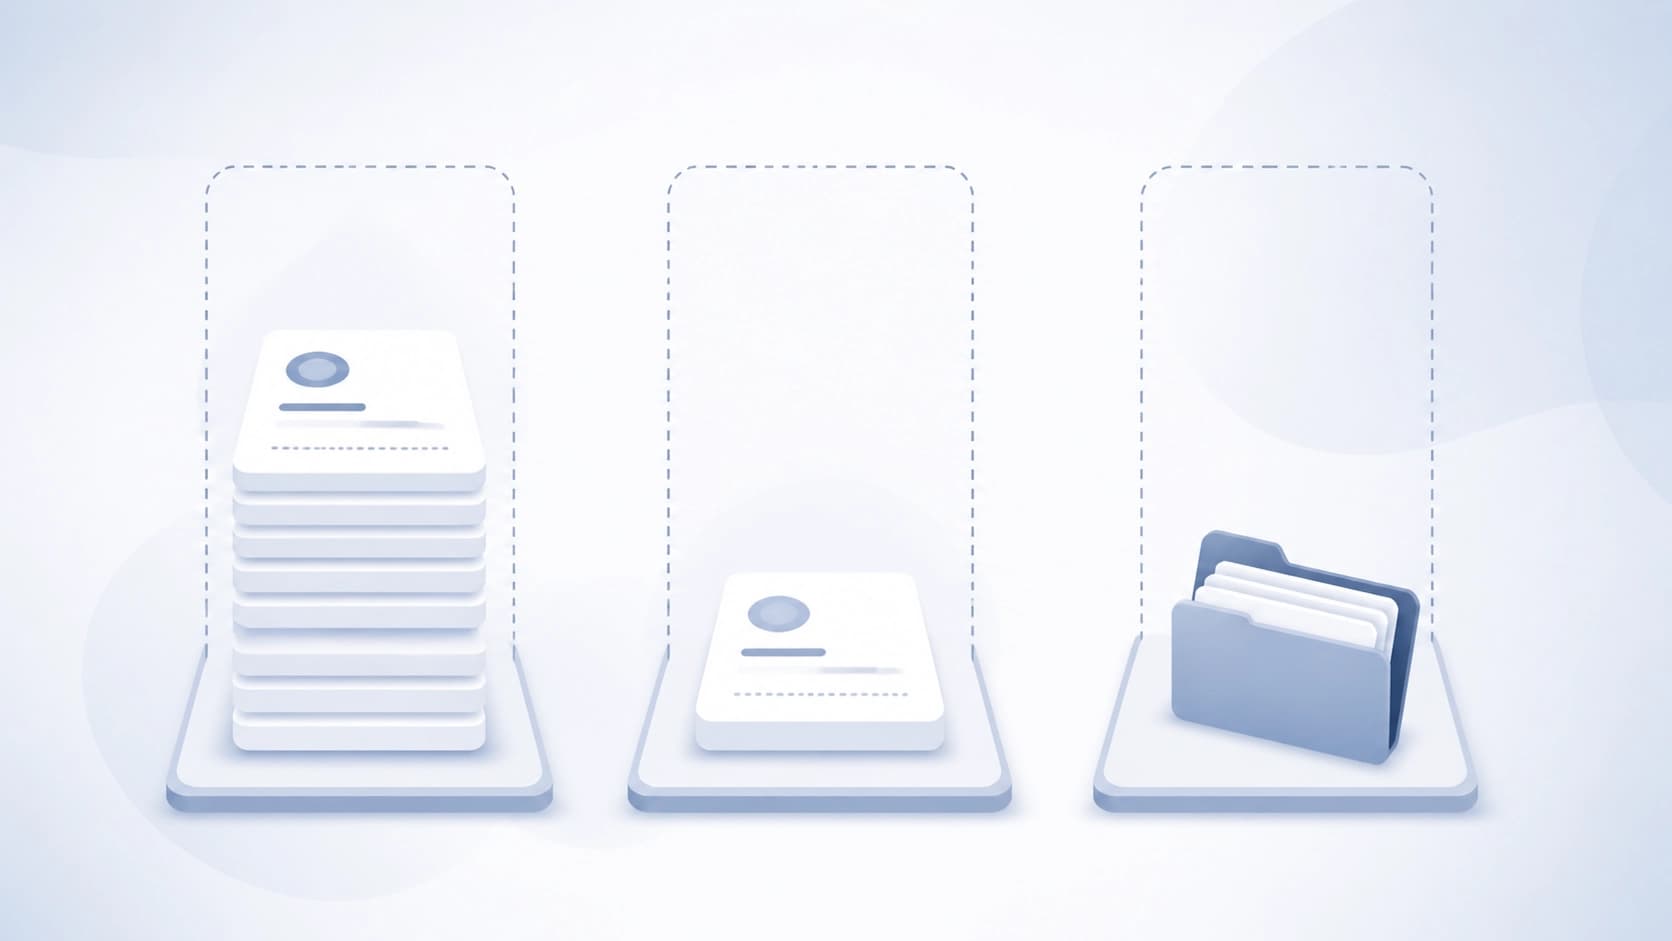
最后一点最有意思。比较了三种方案:完整传递整条轨迹、压缩(对历史做精简提炼),以及删除轨迹只保留仓库状态。换句话说,问题是这样提出的:到底值得给新模型看多少别人的“思考”?
主要结果:传递税
结论令人清醒。在升级时,完整传递历史只能弥合弱模型与强模型之间质量差距的不到一半——而且还伴随着明显的成本增加。也就是说,你按昂贵模型的费率付费,却只得到它的一部分优势。作者把这一差额称为 handoff tax——交接税。
而且这不是某一家厂商的产物:这一图景在两个家族中都重现了。合乎逻辑的解释是——强模型把上下文花在解读别人的迷宫里,部分继承了前驱的错误假设,起步时不是一张白纸,而是背着包袱。它的一部分能力被用于“读别人的日记”,而不是解决问题。
不对称性:向下可以,向上则有保留
最有用的观察是,这种税并不对称。降级反而给出了性价比上的有利点:在复杂推理完成后切换到便宜模型是有效的。
更有意思的是,首选的上下文传递格式会随方向不同而变成相反的:
- 在升级时,精简弱模型轨迹的信息更有帮助。垃圾越少——起步越干净。
- 在降级时,删除强模型的轨迹会降低质量。在这里历史起到支撑作用,值得保留。
解释自然而然:弱模型身后拖着一串死胡同的痕迹,对强模型只会碍事。而强模型身后是经过检验的计划和正确的决策,弱模型可以像沿着轨道一样照着走。这已经是我自己的解读,而不是论文的字面结论,但它与数据吻合得很好。
实践中该怎么做
实际结论如下:
- 切换得比你想的更少。 每一次切换都不是免费操作,而是一笔价格未知的交易。
- 在边界处升级,而不是“卡住时”升级。 好的时机是完成了一个有明确失败的循环(例如测试持续失败),而不是思考到一半。
- 向上——压缩,向下——保留。 在传给强模型之前,整理一份紧凑的提炼:已经做了什么、什么没奏效、有哪些限制。不值得留下完整的尝试记录。
- 向下可以慷慨地给。 弱模型看到强模型留下的计划和修改是有益的。
- 算算你自己的税。 升级时“完整历史”与“压缩”之间的差异,就是一个现成的 A/B 测试,值得在自己的任务上跑一遍:它便宜,而且能快速显示你是否在缴税。
另外一点想法:有时干脆不要在中间换模型更便宜。如果强模型只用于规划,更合理的做法是提前划分角色——强模型出计划,弱模型执行——而不是在同一条轨迹内部搞交接。
总结
任务中途更换模型不是免费的预算优化杠杆,而是一次有自身成本的操作。传递别人的轨迹会吃掉你所付费的那部分优势。从这个意义上说,升级比看起来更有风险;降级反而可预测地有效。而主要的实用技巧不在于选择模型,而在于选择你给这个模型看什么。这些结果是在编码智能体和特定模型配对上得到的,所以不宜原封不动地套用到所有场景——但作为自己测量的工作假设,它们完全适用。