
LLM评审的失误之处:语音代理自动评估的可靠性检验
arXiv预印本作者比较了人类评估者与GPT-4.1和GPT-5模型在电信和零售领域对相同语音代理对话的评判方式——在三种评估方案下按10项效率与安全指标进行。结论:自动化并非处处适用,而部分指标(例如Recovery Turn Count和safety-recall)目前还不能在无人监督的情况下交给机器。
为什么语音智能体的评估如此难以自动化
对话式语音智能体不是单一模型,而是一条流水线:语音识别、推理、工具调用、回复生成、语音合成与音频流式传输。任何一个环节出问题都不会局限在局部——它会沿着链条向下传导,最终在对话本身中浮现出来。正因如此,评判交互质量只有端到端地整体来看才有意义,而不是拆成单个环节。
维持一支真人评估团队既昂贵又不方便:你无法将其扩展到数十万次对话,而且他们的注意力在轮班接近尾声时会下降。自然的出路是把评估交给语言模型。一篇最新的 arXiv 预印本 arXiv:2608.24314(Anupam Purwar、Shashank Singh、Kritika Srivastava)恰恰检验了这条出路在多大程度上站得住脚,以及它在哪里会失灵。
作者如何检验 LLM 评审员
实验建立在来自两个行业——电信和零售——的真实语音智能体对话之上。人类评分与 GPT-4.1 和 GPT-5 的判定结果进行了比对,而且不是依据单一的综合量表,而是依据十项指标:一部分描述对话本身的质量,一部分关乎安全性。
三种配置而非一种
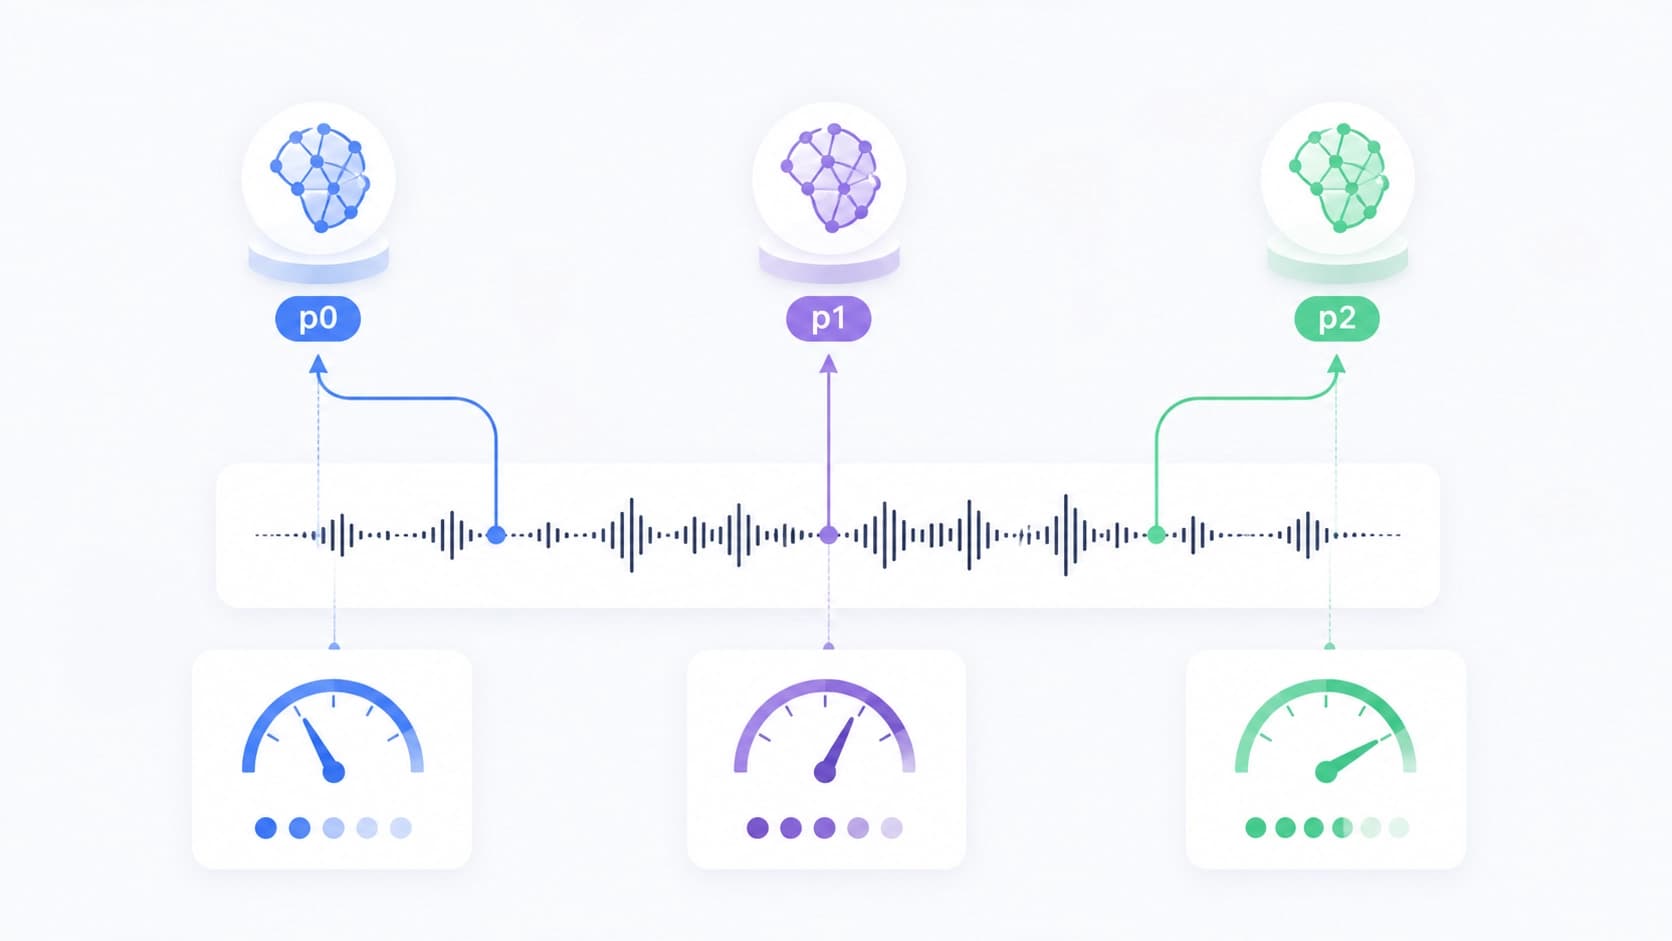
同一批对话被分别通过三套评估方案——p0、p1 和 p2——进行跑测。这个练习的用意很简单:如果判定结果会随评分细则的编写方式而变化,那就说明评审员测量的不是对话质量,而是指令的形式。任何在不同配置之间"漂移"的指标都不适合自动化——至少在没有附加说明的情况下是如此。
究竟比较了什么
聚合一致率——即人与模型判定吻合的百分比——只是最表层。作者挖得更深:他们分别查看每项指标的相关系数,检验评分在人群组内部的稳定性,并剖析人与 LLM 之间的系统性偏差。这样的切分能让人看清,对话的哪些属性适合自动评估,哪些则受制于上下文和解读。
LLM 评审员在哪里出错
核心结论听起来更像是警示,而非对方法的推销:自动评估的可靠性并不均等——它取决于具体指标和配置。同一批评审模型在某些量表上表现稳健,在另一些量表上则明显拉胯。
Recovery Turn Count
这项指标统计智能体需要多少个回合才能把对话从故障中拉回来。自动评估在这里并不可靠:评审员并不总能区分有意义的恢复和碰巧奏效的措辞。一段人类会判定为成功挽救的对话,模型很容易记成失败——反之亦然。
安全类指标的召回率
Safety-recall 是第二个问题区域。错误的逻辑可以预见:评审员看到一段智能体没说出任何危险内容的对话,就打出高分,却不去追问究竟有没有违反策略的机会。漏报违规是最昂贵的一类错误,而自动化恰恰在这里最弱。
领域会改变校准
评审员的可靠性在电信和零售之间存在差异。实践结论是:阈值和评分细则不能机械地从一个行业搬到另一个行业——在一个领域校准好的东西,到了另一个领域就会走样。
校准比一致率更重要
单一的一致率数字会让人放松警惕。模型可能在大样本平均意义上与人类吻合,却在边界案例上系统性地更宽松——而这种偏差在总体百分比背后是看不出来的。因此,对校准做相关性分析、并按每一类案例剖析偏差,比一个汇总指标更有用:它展示的不是"我们有多接近",而是"我们朝哪个方向、在哪些地方说了谎"。
如何将其嵌入真实流水线
作者并不主张放弃自动化——他们提出的是混合方案。LLM 评审员承担大规模评估,人类则留在需要上下文、且对判定有高置信度要求的地方。可操作的规则如下:
- 至少用两到三种配置跑评分细则,并比较结果,而不只是看最终得分;
- 分别计算每项指标的一致率,而不是整个数据集用一个数字;
- 在 safety-recall 和故障恢复类指标上保留人工;
- 在设定自动阈值之前,先在自己的领域上检验校准;
- 保留人/模型判定不一致的案例——这是用于微调评分细则的现成素材。
归根结底
LLM 评审员是大规模评估语音智能体的可用工具,但不能取代评估员。它的可靠性分布并不均匀:一部分指标可以放心交给自动化,一部分则需要人的眼光。这项研究的价值在于,它为这种分工提供了实证框架——并提醒人们,"该不该信任模型来做评估"这个问题本身就不成立,除非先明确是在哪项指标上、在哪个领域里。
常问问题
相关材料
所有材料
陈-西蒙斯储层记忆:连通性的自主动力学与密度输运
本文探讨了储层如何同时在密度分布和几何自由度中保留输入信号的历史。对四种机制的比较表明,电流会形成一个独立的连通分量,改变密度的后续响应;而纳入所有测得的特征,则能在脉冲顺序解码方面带来小幅提升。
10 十一月 2026
STAR:面向端到端事件管理的时间上下文与服务图自适应规范化
STAR 框架通过指标、日志和追踪数据学习表示,并采用可训练的归一化方法,兼顾多尺度时间动态和服务间的依赖结构。在两个真实数据集上,与当前先进的基线方法相比,该流程在异常检测、故障排序和根因定位方面均实现了稳定的性能提升。
10 十一月 2026
验证候选项比生成候选项更昂贵:对抗 LLM 漏洞搜索的诱饵
本文剖析了智能体缺陷搜索中的成本不对称:生成候选版本成本低廉,而通过可达性分析、执行和 PoC 对其进行确认却要耗费主要预算,因此可以将验证本身作为独立的防御目标。本文提出的 RedHerring 是一套针对代码仓库定制、带有隐藏证书的诱饵;在投入相同成本的情况下,它使 33 个 OSS-Fuzz 项目中发现的真实漏洞数量减少了 38.7–60.4%;即使提前告知智能体,降幅仍达 37.2%。
9 十一月 2026