为什么 IBM 会走向智能体方向
企业客户很少为了漂亮的演示而购买模型。他们需要软件能真正做事:处理工单、核对账单、调用内部 API、撰写文档摘要。这正是智能体逻辑所占据的生态位——模型不只是回答问题,而是自己决定下一步该调用哪个工具。
在这段故事里,Granite 4.2 不是“又一个更大的模型”,而是 IBM 试图把产品线补齐,让它在云端和客户的封闭环境中都能同样稳定地运行。赌注押在三件事的组合上:开放权重、对硬件要求不高,以及调用外部函数时行为可预测。
Granite 产品线究竟是什么
IBM 以 Granite 这一共同名称运营开源模型家族已有多年。在此期间形成了一套辨识度很高的理念:模型以多种规模发布,首要面向代码、表格处理、从文档中提取数据以及企业级场景,而不是在通用聊天基准测试中争高下。
规模很重要
产品线呈阶梯式构建——从能装进一块显卡、甚至能在处理器上运行的极小版本,到中端模型。其意义在于,每个任务都能选用刚好够用的最小规模。对于主要做请求路由和函数调用的智能体来说,巨型模型往往过剩:推理成本更高,响应也更慢。
混合架构
在家族的第四代分支中,IBM 转向了混合方案,一部分层基于 Mamba,另一部分基于经典的 Transformer 注意力机制。实际收益很朴素:长上下文处理更便宜,内存占用更节省,同等硬件下吞吐量更高。对智能体场景而言这至关重要,因为上下文中会不断加载工具调用结果、文档片段和步骤历史。
没有意外的许可证
Granite 模型采用 Apache 2.0 许可证分发。对企业法务来说这是条无聊的消息,而这恰恰是好消息:可以微调、嵌入商业产品、在内部边界内部署,无需向厂商报告产品赚了多少钱。
核心论点:这东西可以自己留着
云 API 很方便,直到数据受到监管限制为止。银行、诊所、工业企业和政府机构往往在物理上就无法把部分文档发送到外部。这时关于“自己的硬件”的讨论就开始了。
实际启动需要什么
关键不在于顶级加速器,而在于合理的下限。Granite 的小型版本可以跑在一张消费级显卡上、无 GPU 服务器的容器里,或开发者的笔记本上。中等规模则需要多张显卡或量化。启动通常通过 vLLM 或 Ollama 之类的标准工具进行,这就免除了对厂商专属技术栈的绑定问题。
安全性与可预测性
论点的第二层是控制权。当模型运行在你的边界内,日志写什么、哪些数据进入 prompt、什么被缓存、保存多久,都由你自己决定。对智能体来说这尤其重要:它们能执行动作,而不仅仅是生成文本,而每个这样的动作最好都经过自己的规则和审计。
IBM 在这里卖的不只是模型,还有配套:watsonx 平台、用于过滤不良内容的一组“守卫”模型,以及在自有数据上微调的工具。在这套方案里,模型只是一个部件,尽管是核心部件。
智能体场景在实践中是什么样
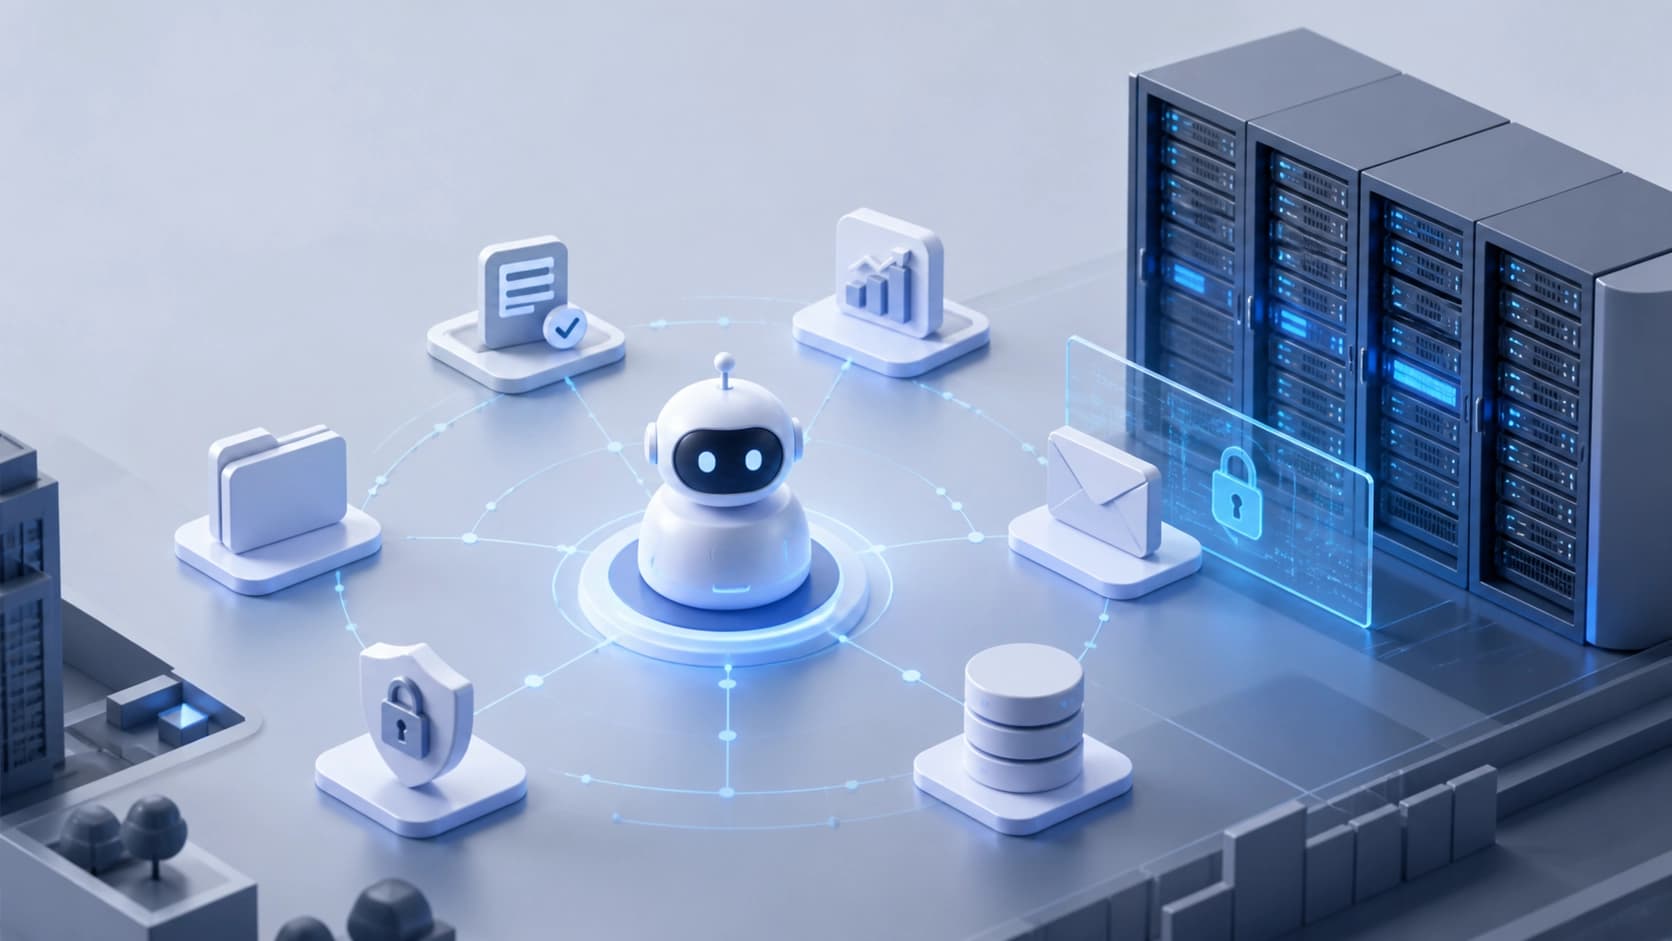
智能体的理念很简单:模型接到任务,判断自己缺哪些数据,调用所需工具,读取返回结果并继续,直到得出结果。“纯聊天”与智能体之间的区别在于是否存在循环和权限。
这类模型通常针对的典型角色:
- 路由器。 分析进来的请求,决定把它交给哪个场景处理。
- 提取器。 从账单、合同、对账单中取出字段并整理成结构化数据。
- 执行者。 调用内部系统的 API:创建工单、更新状态、发送邮件。
- 审核者。 检查上一步的结果,判断是否可以采纳。
在这些步骤的每一步上,小模型往往比一个大模型更划算:更便宜、更快、更易测试,而且同样重要的是,当质量不再令人满意时更容易替换。
该关注什么,限制在哪里
开源模型不是灵丹妙药,坦诚地讨论限制比营销更有用。
规模与推理质量
小模型经济实惠,但在复杂的多步任务上仍逊于大模型。折中方案通常从架构上寻找:在多个小模型之间划分角色,加入确定性的代码校验,把最终决定权留给人。
周边生态
开放权重意味着模型可以轻松在不同框架之间迁移——从 LangChain 到自研编排器。另一面是:针对特定行业的现成“开箱即用”方案比专有平台少,部分集成工作要落到客户团队身上。
硬件与持有成本
自己的硬件不仅省下 API 费用,还有资本支出、电力、散热,以及维护这一切的人员。对小型公司来说,云几乎总是更便宜;对拥有敏感数据的大型公司则相反,而这个门槛会随规模变化而移动。
质量评估
最大的陷阱是用通用基准测试来衡量智能体。一个能工作的智能体要在自己的场景中检验:一组有已知正确答案的真实任务、对垃圾输入数据的鲁棒性,以及当被调用的工具返回错误时的行为。没有这样一套测试,发布说明里的任何数字都只是发布说明里的数字。
由此可以得出什么
IBM 对当前市场态势的反应看起来合乎逻辑。当一些人在云端追逐极致质量时,另一些人在填补一个更看重控制权、每 token 价格以及能否把一切部署在边界内的生态位。开放权重加上对资源的低要求,再加上对工具调用的侧重——这正是那些厌倦了为向外发送数据而走审批流程的企业客户所需要的组合。
关键问题不在于新版本能否在通用测试中超越领先者。问题在于团队是否有足够的纪律,围绕模型搭建起一套像样的智能体闭环:权限受限、有审计、有测试、有清晰的回滚机制。如果做得到——把这样的智能体跑在自己的硬件上就会成为一种相当可行的策略,而不是一种妥协。