兔子追老虎:一个暴露盲点的测试
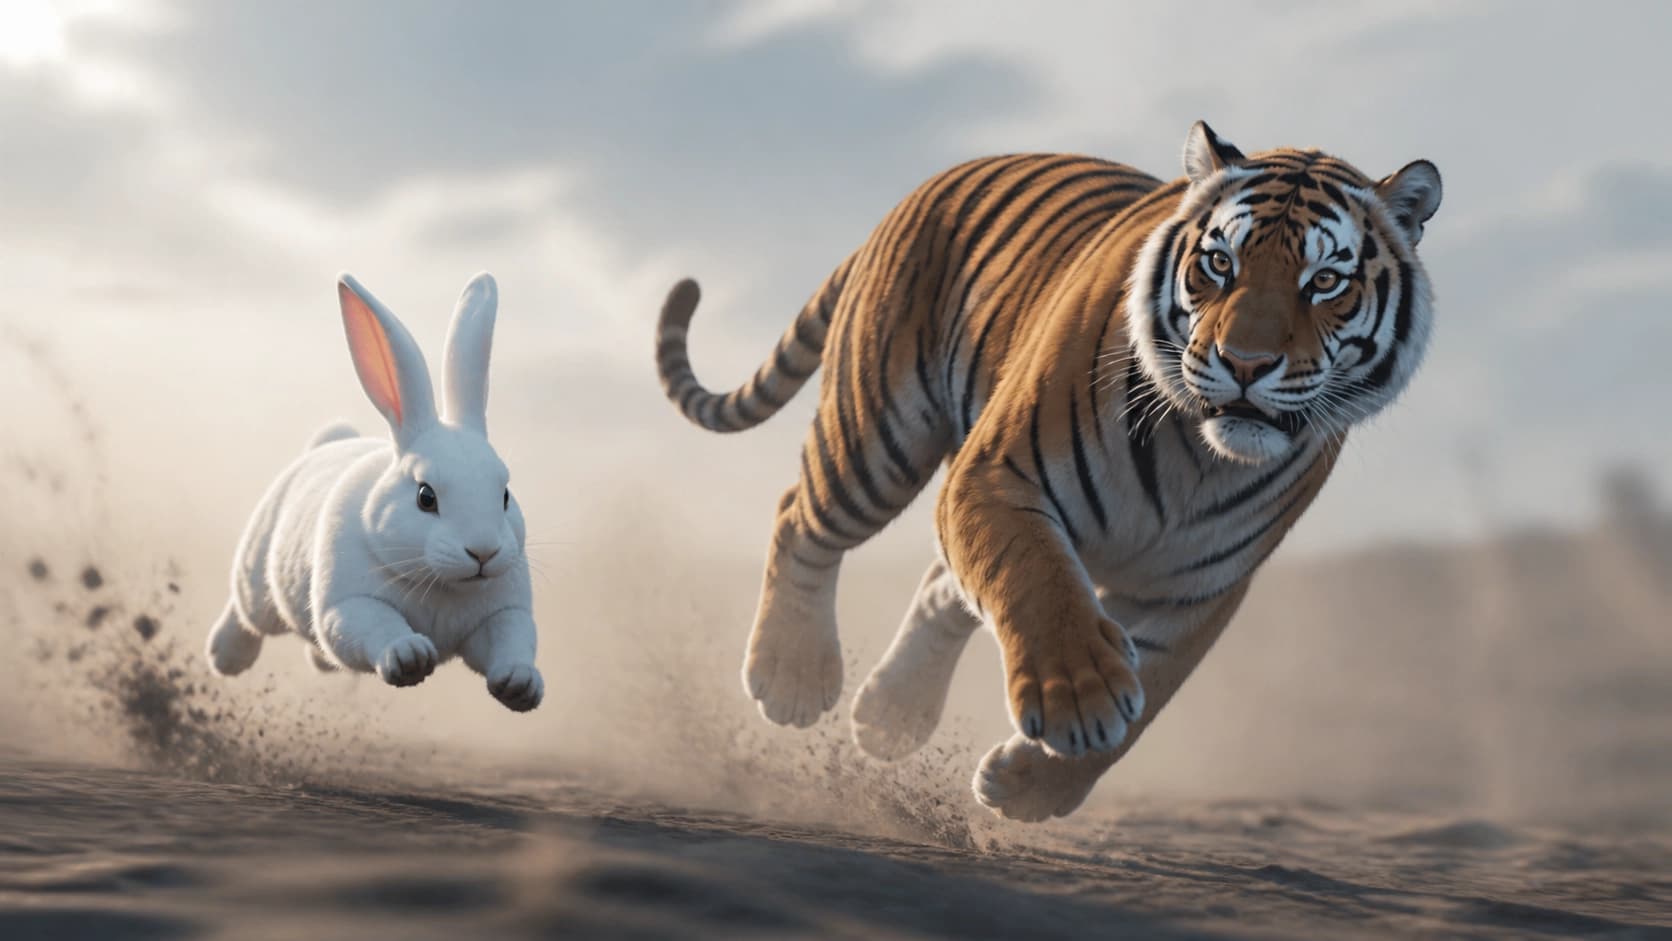
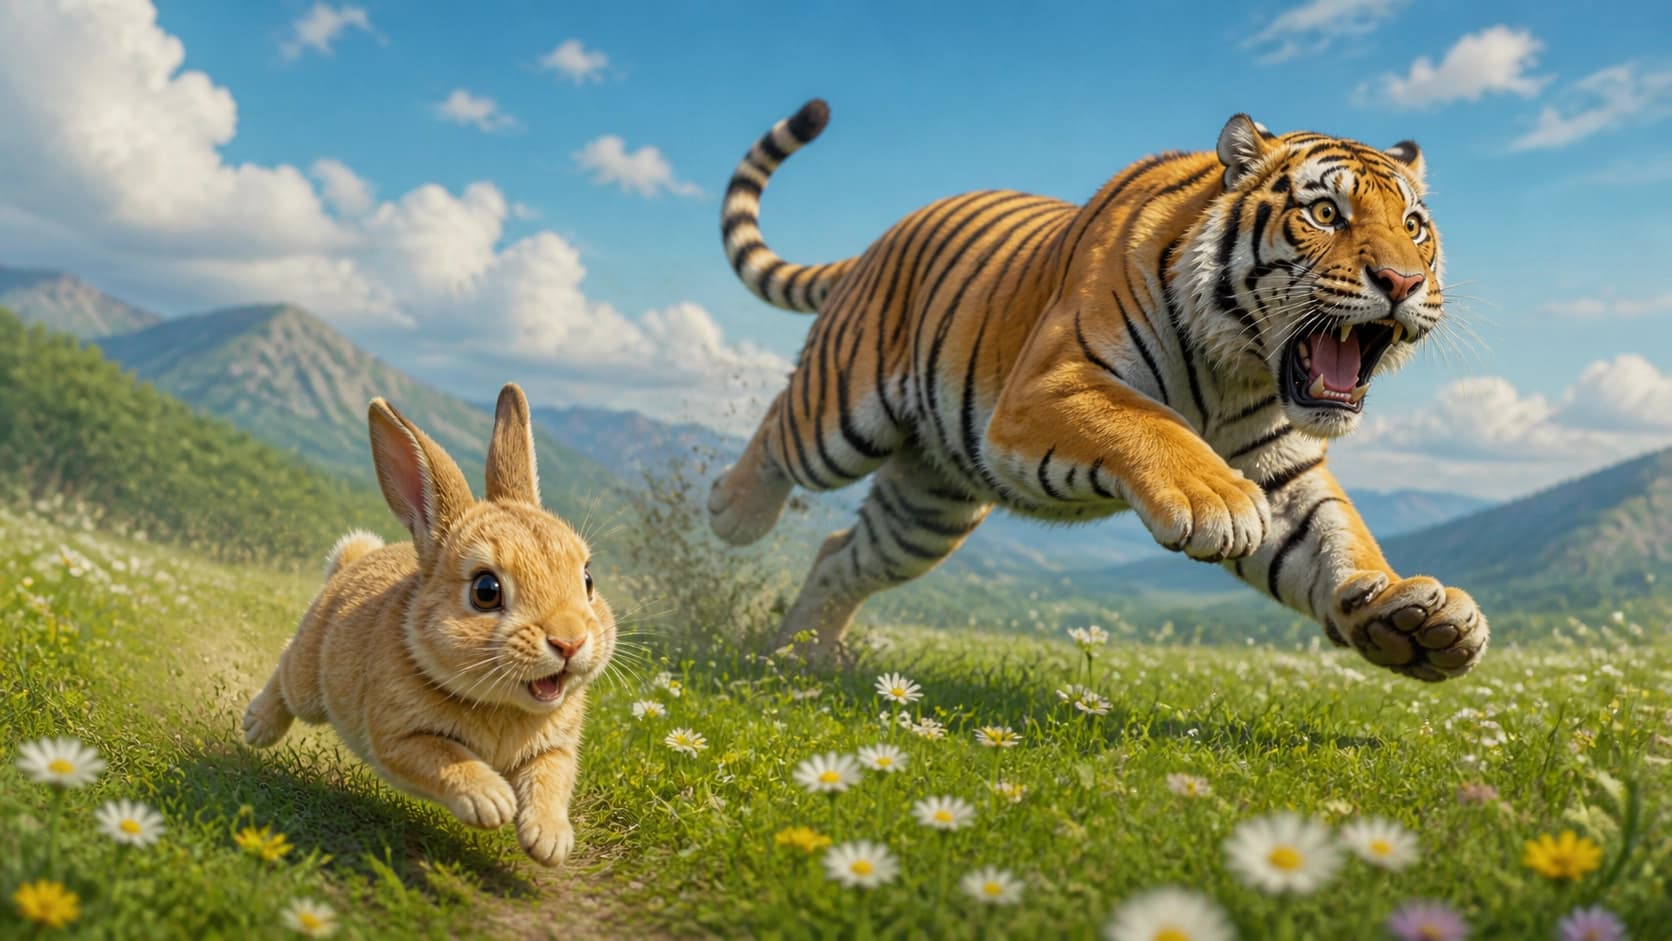
想象一幅画面:一只兔子在草地上飞奔,而它前面一只老虎正在逃窜。构图精致,细节清晰,没有任何歧义——视觉上一切都明确无误。然而,相当一部分开源多模态模型却把这一场景描述反了。不是因为它们看不清,而是因为它们不相信自己所看到的。
正是这一悖论,被研究《Seeing vs. Believing: Evaluating the Language Bias of Open-Source MLLMs in Counter-Intuitive Scenes》(arXiv:2601.07737,作者 Chen Ling、Tongwei Zhang、Hanqian Li 和 Nai Ding)所剖析。该论文于 2026 年 1 月发表,此后两次更新——最新修订版日期为 8 月。形式上这是一篇计算机视觉论文,但其结论要宽泛得多:它们直击现代多模态助手构建逻辑的根本。
究竟测试了什么
多模态模型早已能自信地解决"主流"任务:描述照片、按文本查询找到对象、根据示意图回答问题。但这类测试几乎总是建立在符合日常预期的场景之上。窗台上的猫、雨中打伞的人、路上的汽车——这些场景模型在数据集标注中见过数百万次。
那么,如果视觉世界违背常理,会发生什么?为了弄清这一点,团队构建了基准 CAIT——400 个高细节合成场景。每一个都描绘了与惯常世界图景相矛盾的动作:那只追赶老虎的兔子就是典型例子。图像是合成的,因而是可控的:可以确信视觉线索确实存在,而且明确无误。
该方法论的关键在于,这里的正确答案无法从问题文本中推导出来。只能通过一种方式获得——看图片,并接受上面所画的内容。
人类、闭源与开源模型:数字上的差距
结果分布在三个截然不同的水平上。
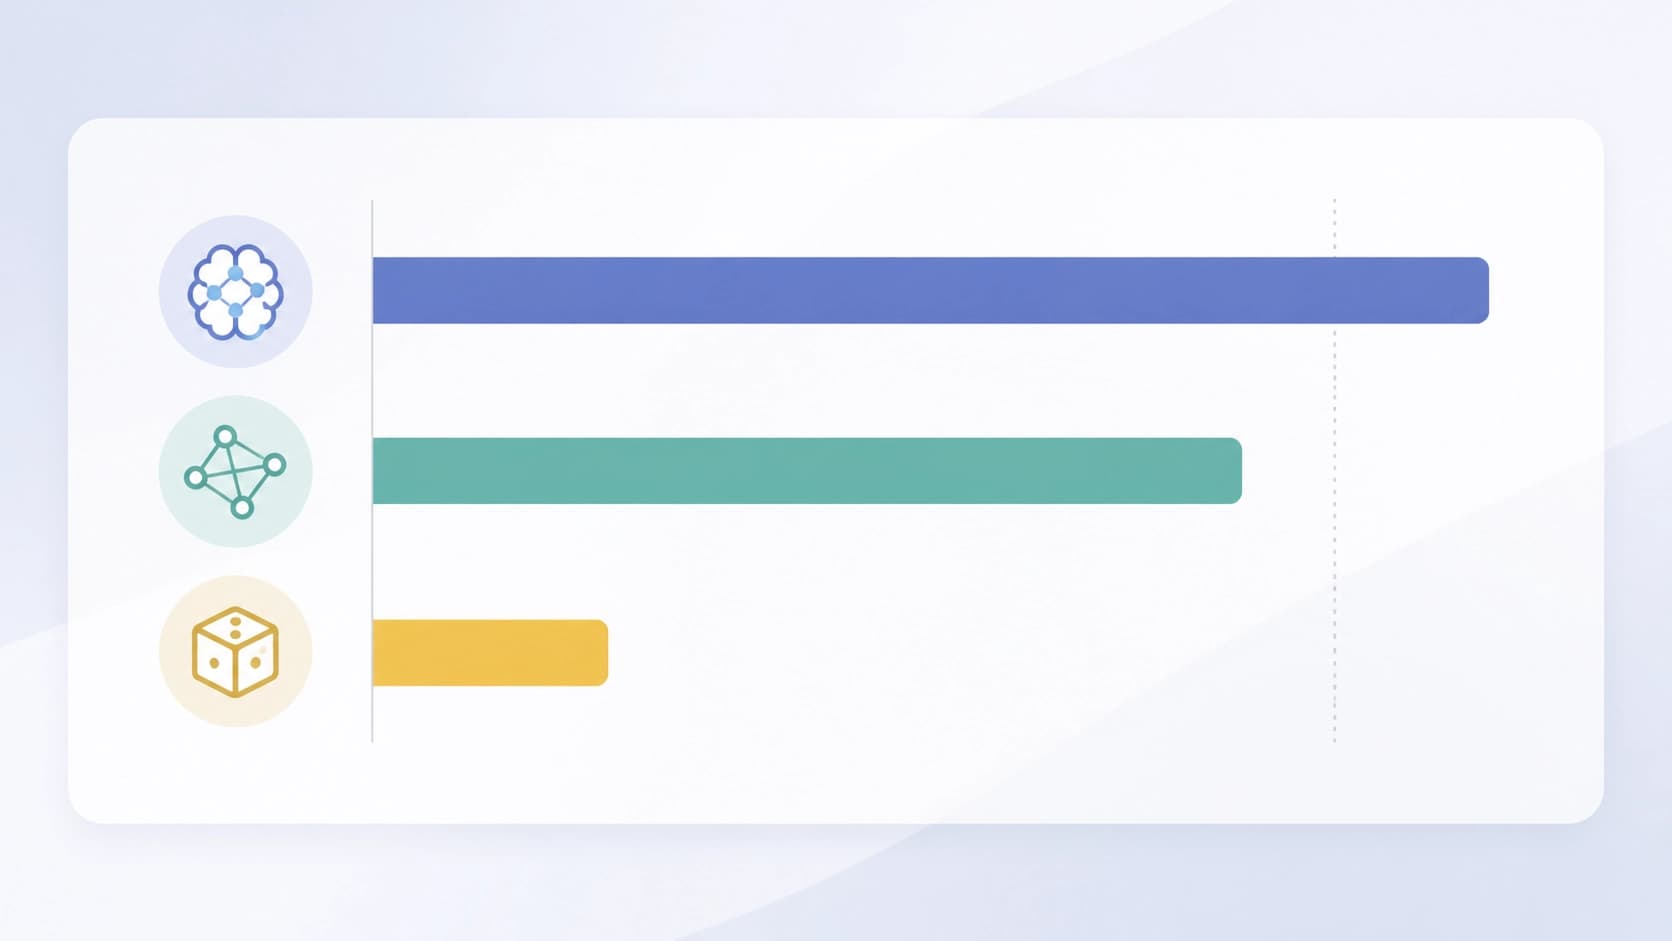
- 人类几乎完美地解决了任务——准确率约为 0.95。对我们来说,看到不寻常的场景并如实记录,毫无难度。
- 专有模型——研究中包括领先的解决方案,其中有 Claude 和 Gemini——表现出稳定的理解:准确率高达 0.88。并非完美,但系统显然在看图像,而不是在猜测。
- 开源 instruction-tuned 模型——14 个代表性样本——跌至随机猜测的水平。换言之,它们的回答几乎与画面实际内容不相关。
这就是标题所讲的故事:闭源解决方案的"老虎"与开源模型的"兔子"之间的差距,并非表面性的,而是根本性的。问题不在于开源模型在复杂任务上表现稍差——在反直觉场景中,它们已不再具有任何有意义的多模态能力。
罪魁祸首——语言先验
对错误的分析揭示了失效的机制。问题不在于模型没看清兔子。问题在于它宁愿不相信自己的眼睛。
当视觉信号与文本统计相矛盾时,强大的语言先验便发挥作用:模型自动将异常观察替换为最常见的文本描述。老虎追兔子——这个搭配在语料中屡见不鲜。反过来则几乎从未出现。在"看到"与"预期"的岔路口,系统选择了后者。
本质上,对于这类模型,视觉输入只是提示它该从记忆中调取哪个短语的线索。如果图片印证了模板——一切正常。如果与模板相悖——模板获胜。因此准确率才停留在抛硬币的水平:模型凭语言的惯性作答,而非依据图像内容。
推理的陷阱:"重新考虑"场景
一个合乎逻辑的建议是给模型加上思维链(Chain-of-Thought)。让它逐步陈述、自我检查、得出结论。这在一定程度上有效:准确率确实提高了。
但改进是有代价的,而且是双重代价。
首先,回答明显变慢——详尽的推理需要时间和算力。其次——这一点更有意思——出现了一种新的失效模式。模型开始字面意义上地重新考虑所见之物。它似乎先记录了场景,随后又将其抛弃:这种事不可能发生,这违背现实世界的物理规律,那么我大概是搞错了。结果,系统拒绝接受实际的视觉内容,恰恰因为它是不可能的。
于是形成了一种讽刺:一个本应让结论更有依据的工具,有时却变成了一台压制不便事实的机器。
什么有帮助:微调与结构化提示
好消息是,这个问题并非致命。作者描述了两种能显著缓解对语言先验依赖的方法。
- 针对性微调。 在合适的数据上进一步训练,能降低用模板替换观察的倾向,让视觉通道重获权重。
- 结构化提示。 如果为模型设定一种回答格式,要求它先记录所观察到的内容,然后再进行解读,那么无需重新训练,准确率也会提高。
在这两种情况下,开源模型都开始基于真实的视觉证据而非文本统计来论证结论。也就是说,与闭源解决方案的差距是架构和训练的问题,而非根本上的不可能。
这在实践中意味着什么
对于基于开源多模态模型构建产品的开发者来说,结论相当接地气。
应当记住,自信的回答不等于所见之物。在场景符合预期之处,模型表现出可靠性;在场景相悖之处,它会悄无声息地塞进一个貌似合理的虚构。最危险的是,错误看起来不像错误:描述流畅、合乎逻辑,却完全错误。
此外,应当把推理视为一种带有副作用的工具。Chain-of-Thought 并非总是有效,也并非在所有任务中都有效——有时它会把模型变成一个怀疑论者,否定自己正确的结论。
最后,也是最重要的一点。"兔子追老虎"不是趣闻,而是对模型究竟信任什么的纯粹检验。只要这个问题的答案仍不偏向图像,那么称一个系统为多模态,就只能是有条件的。