问题:模型在被检验的地方,恰恰是无需再寻找的地方
组织学切片是一幅千兆像素图像。为了做出诊断,病理医生先以低倍镜浏览标本,锁定可疑区域,再近距离观察,将不同放大倍数下的图像相互比对,最后才形成结论。这项工作中相当大的一部分并非用于观察,而是用于寻找:究竟该看哪里。
现有的大多数 AI 病理学基准测试,恰恰剥夺了模型的这部分工作。输入要么是预先裁剪好的图块,要么是已经提取好的切片特征——也就是说,是别人事先决定了哪里重要。模型拿到现成的证据,展示自己基于这些证据进行推理的能力。而它自主获取证据的能力究竟如何,几乎无人检验。
EviPathBench 这项工作正是瞄准了这一空白。作者为 Dankai Liao、Tianyi Zhang、Yufeng Wu、Xinyue Zhang、Qiaochu Xue、Zeyu Liu、Dachun Zhao、Linghan Cai 和 Yueming Jin;预印本于 2026 年 7 月 21 日发布在 arXiv 上,到 8 月 25 日已更新至第四版(arXiv:2607.19261,cs.CV / cs.AI)。如此频繁的修订本身就暗示:作者认为这个议题仍然活跃且存在争议。
基准测试的结构
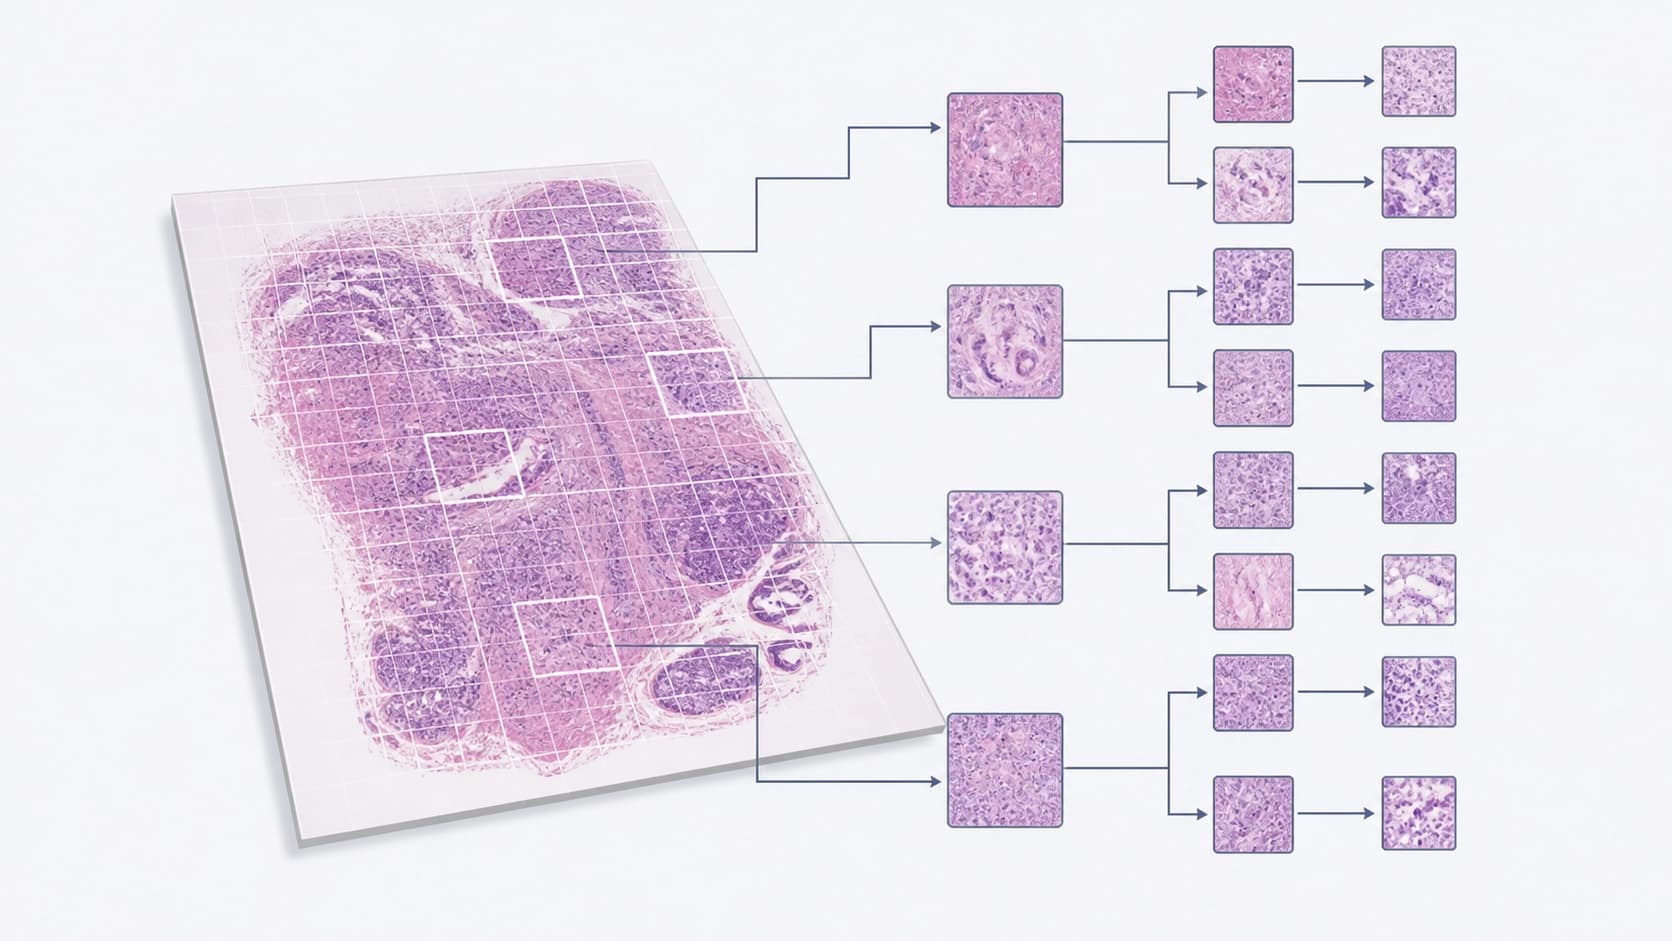
EviPathBench 并非由一道道带选项的独立问题构成,而是一棵诊断树。不同放大倍数下层层嵌套的区域,与特定尺度下的发现相关联,最终指向病理结论级别的诊断。模型需要做的不是简单给出一个"癌症"标签,而是走完一条链条:找到区域,描述该放大倍数下的发现,上升到更高层级,在不同尺度之间协调数据,并将其汇总为总体结论。
四项可检验的能力
作者将处理切片的能力拆解为若干组成部分,并分别评估每一项:
- 图像与文本的匹配——证据解读,即模型将所见与描述关联起来。
- 文本对图像的检索(retrieval)——验证:根据表述在切片中找出对应片段。
- 诊断区域的定位——即证据收集本身:究竟该在哪里寻找。
- 跨层级推理——将不同放大倍数下获得的发现整合为统一图景。
这种划分本身就很有价值:它表明"理解切片"并非单一能力,而是多种能力,且它们之间可能差异极大。
数据与标注
基础数据包括来自 TCGA 的 1,822 张 WSI 和 17,135 条诊断路径,由十位认证病理医生标注。此外还使用了一个包含 190 张乳腺癌切片的私有队列,配有详细注释——它的用途正是检验对整张标本的自主探查,且不提供关于目标区域位置的任何提示。
结果:推理尚可,寻找不行
评估涵盖了 19 个"视觉-语言"模型——通用、医学及病理专用模型——外加一个作为参照基准的纯文本模型。
结果呈现出鲜明反差。最好的开源模型在跨层级推理上准确率超过 93%,在两项跨模态匹配任务上均超过 50%。看起来一切都不错。
但在诊断区域定位上——情况很糟。文本引导的平均 IoU 最佳结果甚至不到 0.09。这比一个完全不做任何分析、直接把矩形框放在切片中央的简单启发式方法还要差。换言之,一个被训练来观察组织的模型,寻找能力还不如一个什么都不看的程序。
尺度会破坏搜索
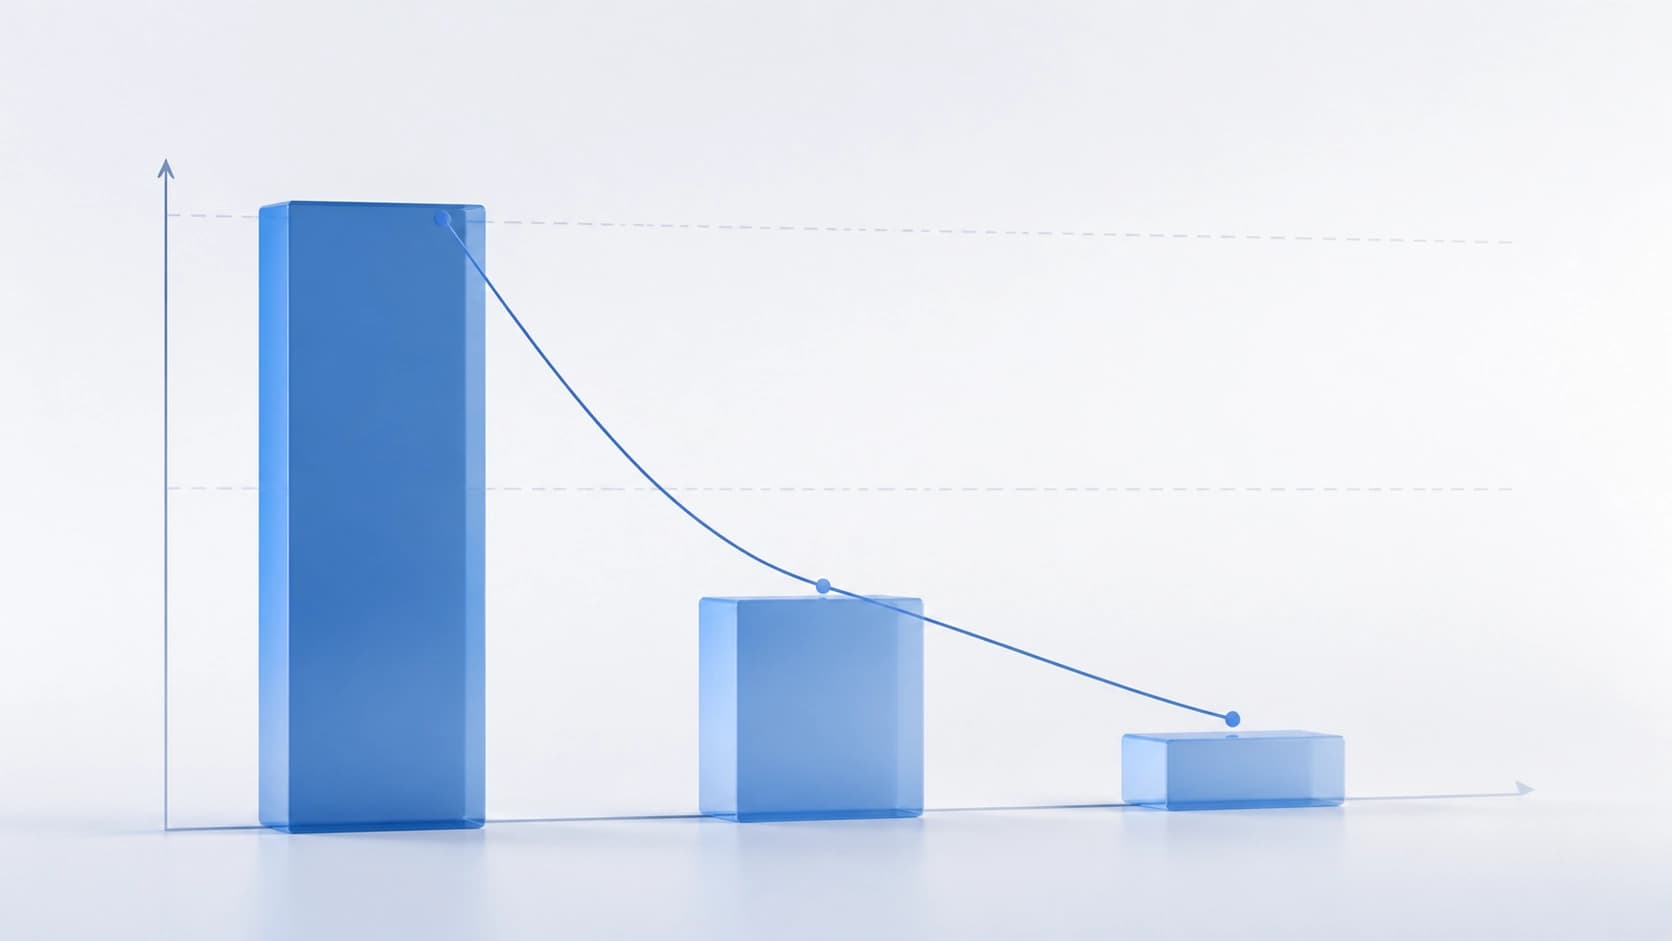
实验的另一条线索是切片的自主探查。在这里,绝对命中率随放大倍数上升而急剧下降:低倍下为 0.522,中倍下为 0.185,高倍下为 0.020。下降的逻辑不难理解:在低倍下,模型能看到组织的整体结构,容易"落在正确区域附近",但放大倍数越高,视野越窄,前一步的每个错误代价也越大。失误不断累积,到最大放大倍数时,模型几乎必然看错地方。
由此得出的结论
这项工作的核心结论很简单:在基于现成证据进行推理的能力,与自主获取这些证据的能力之间,存在一道深深的鸿沟。前者对当代模型来说已经做得不错,后者则几乎做不到。
对实践而言,这意味着目前还不能把切片导航完全"交给"模型,并期待得到有临床意义的结果。不过这个基准测试本身提供了一个通用框架:可以借此同时衡量这两种能力,并观察某项具体改进——强化学习、缩放步骤间的记忆、分层搜索——是否能在失败的那部分取得进展。
也需要记住一些保留意见。私有队列仅限于乳腺癌,而主要数据是 TCGA 的回顾性材料,因此真实的临床多样性并未被完全覆盖。定位指标对区域边界的标注方式很敏感,而预印本一个月内出现四个版本,也说明这些数字仍可能继续修正。