
原始数据而非现成表格
模型正越来越多地扮演代码智能体的角色:人们让它们编写数据处理脚本、绘制图表、计算指标、解析工程数据导出。但有一类任务至今几乎未被检验——处理物理层面的"原始素材"。EMRB(Electromagnetic Reasoning Benchmark,电磁推理基准)正是填补这一空白,其内容见预印本 arXiv:2608.24086(cs.AI、cs.CE、cs.SE 分类)。
核心思路简单,因而有说服力。输入只有原始 I/Q 记录,即从接收机直接输出的正交采样信号。没有任何预处理特征、带标注的频谱图,更不用说现成数值的表格。模型必须首先通过自己编写并运行的代码,在数据中发现与问题相关的物理量。
这与常见测评有何不同
近年来出现了不少让模型对无线电信号进行推理的任务集。但大多数情况下,模型该做的工作早已被完成:从记录中提取了特征、计算了频谱、估计了噪声水平,并整理成结构化表格。在这种设定下,剩下的只是算术和数值比对——这些技能有用,但与射电物理无关。
区别是根本性的。当物理量已预先给出时,模型在早期步骤的错误就无从显现:错误的带宽或频率估计根本不会出现,因为这些值已在题目条件中给出。而当数据未经处理时,信号侦察阶段的任何错误都会牵连后续全部计算。因此 EMRB 检验的不是术语知识,而是构建链条的能力:观察采样、判断信号类型、提取所需特征、正确计算且不丢失量纲。
基准的构成
作者——Mingxu Zhang、Ying Sun、Yuhan Li、Yang Ji、Dazhong Shen、Ke Zhang 和 Shan Huang——共收集了 200 道题。题目按五个难度层级和 27 种问题类型划分:从最基础的信号检测到 OFDM 系统设计。素材来源为 11 种信号类型,每种都配有经过验证的参考答案。
五个层级
各层级按模型自主性的递增排列。最底层是基础参数测量:找到信号、估计其特征。往上依次是解释与比较,然后是多个步骤的分析,接着是诊断,最后是系统设计——此时要求模型不是去测量,而是按给定需求设计解决方案。
27 种问题类型与 11 种信号类型
如此大的跨度是为了让结果不依赖于某一种表述的成败。不同信号类型会带来不同的陷阱:有的受噪声干扰,有的存在频谱重叠,有的需要谨慎处理采样。问题类型与信号类型的数量共同构成了一个难以靠运气猜中的空间。
开放数据
所有材料和代码都发布在公开的 GitHub 仓库中,因此结果可以被独立复核。对基准而言,这一点比通常更重要:如果题目是生成的,而非从实测记录中人工收集的,那么参考答案的正确性就成了核心问题——而开放性是这里唯一有效的答案。
模型表现如何
共测试了 14 个语言模型:专有模型、开放权重模型,以及专门面向推理的模型。最终得分跨度从 24.1% 到 78.9%。仅这一区间本身就说明了很多:最好与最差模型之间的差距在这里不是以百分比计,而是以倍数计。
但更有意思的是另一点。平均成绩随层级升高而急剧下滑:从基础测量上的 84.9% 降至系统设计上的 21.2%。也就是说,当需要计算一个可测量的物理量时,模型表现尚可;而当需要把这些物理量组合成一个可用的解决方案时,几乎全线崩溃。
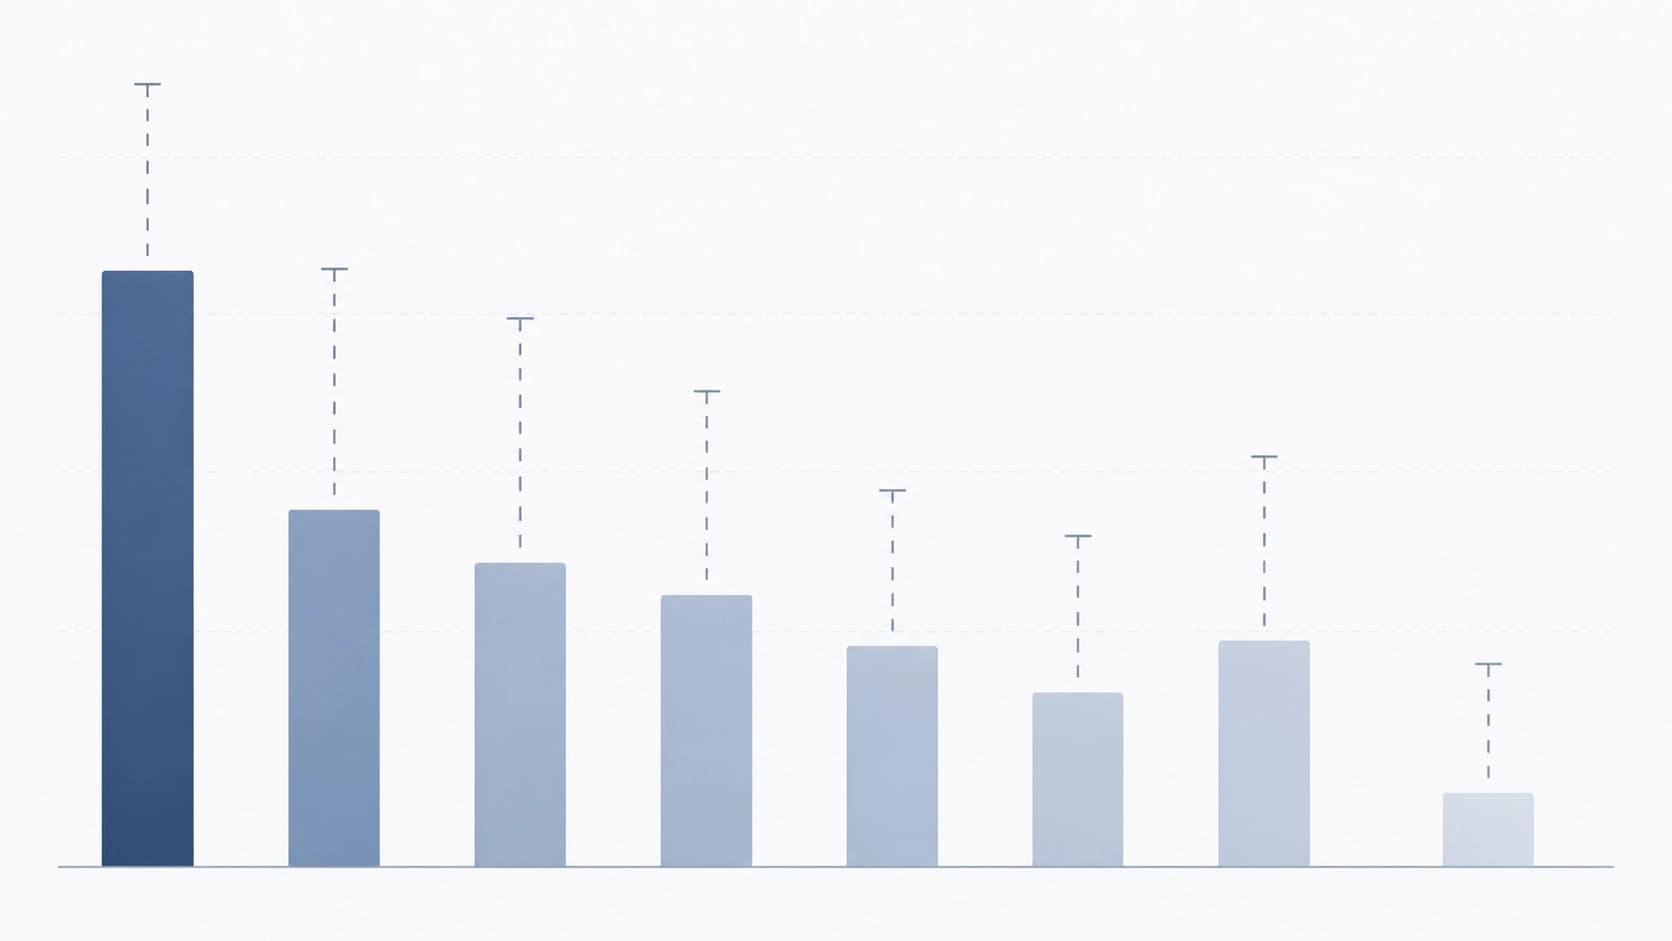
这应当被当作一份诊断书来读,而非排行榜。当前模型的强项是代码执行和在已知设定下的算术运算。弱项则是把工程任务转化为可测量步骤的语言:判断究竟需要哪些物理量、以什么顺序去查找、如何验证找到的结果是否靠谱。正是这一差距让该基准具有价值。
ReconPilot:侦察、分析、验证
作者并未止步于测评。他们提出了 ReconPilot——一种结构化方法,将工作分为三个阶段:信号侦察、目标分析和自检。首先,模型研究记录并形成对所处理对象的认识。然后解决具体任务。最后回到自己的结果,检验其一致性。
在三个基础模型上,该方法使总分提升了 3.8 至 17.6 分。在测试的 15 种"骨干模型 + 层级"组合中,有 13 种取得了提升。请注意这一表述:增益并不均等,且有两种组合完全没有提升。这是诚实实验的正常特征——没有找到万能药,但趋势是稳定的。
值得注意的是,起作用的正是阶段的明确划分。一个被简单要求"分析信号"的模型,往往会在尚未确认自己是否理解数据时就跳到计算。将侦察作为独立的必经步骤,迫使它先观察,再计算。
由此得出的结论
对工程实践而言,结论相当直接:在信任智能体基于真实测量做计算之前,应当用没有提示的数据检验它。友好的界面和聊天中流畅的回答,丝毫不能说明模型能否经受住接收机原始数据导出的考验。
还有一个更普遍的启示,超出了无线电领域。在任何推理依赖原始测量的领域——水声、振动、遥测——智能体都必须先能在数据中找到物理量,然后才能对其进行处理。带特征的表格掩盖了这部分工作,错误也随之被掩盖。
局限与展望
这个问题还不能说已被完全解决。200 道题数量可观,但并非无限,而基于 11 种信号类型的生成意味着真实的现场记录及其各种伪影终究未被纳入。对 14 个模型的评估只是某一时刻的截面,而非定论:该领域领先者的构成变化很快。
尽管如此,任务的设定看起来是正确的。如果我们希望 LLM 处理的不是数据的转述,而是数据本身,那就必须在提示结束之处检验它们。EMRB 正是这样做的——并且表明,模型在信号侦察方面的提升空间仍然非常巨大。


