
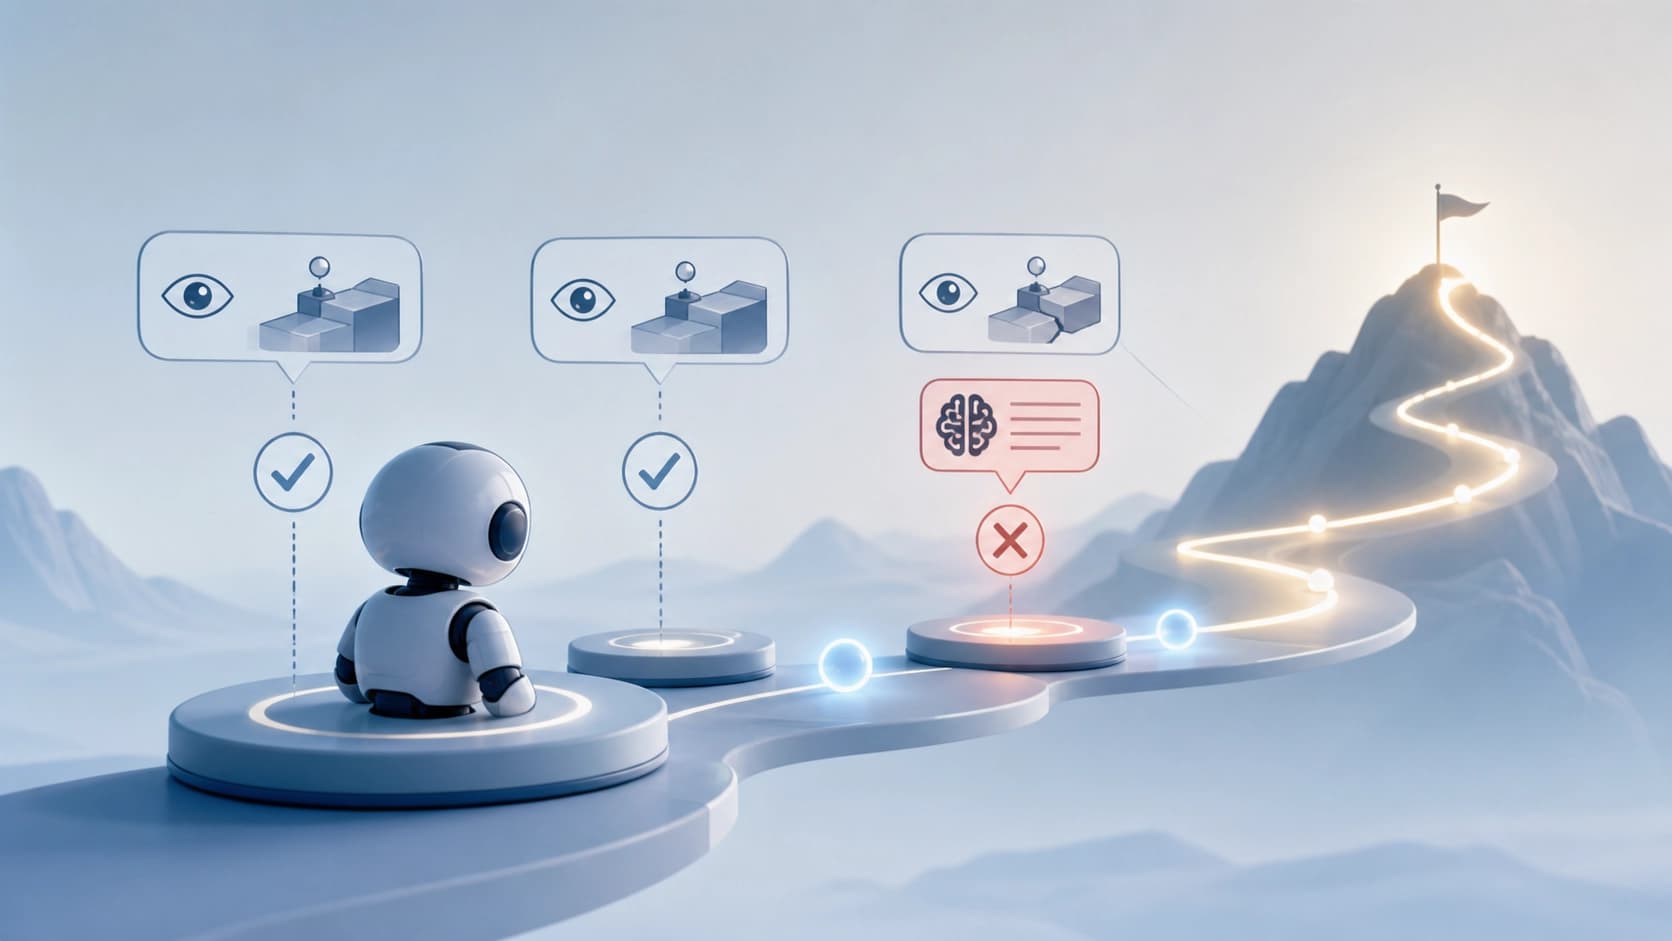
问题:整条轨迹共用一个奖励
基于 LLM 的多步智能体通过试错来学习:执行一连串动作,获得一个最终评分,再据此调整行为。问题在于,这个评分通常是针对整条轨迹给出的。智能体知道任务成功还是失败,却不知道究竟是哪一步出了问题。
接下来就是一套与常理相悖的算术。相同的优势被平摊到所有步骤上——无论是成功选择工具,还是查询里偶然的笔误,抑或是例行公事的“确认操作”。结果就是,只要最终结果是成功的,模型就会同时奖励随机的失误和正常的工作步骤。成功的功劳人人有份,失败的罪责也同样人人有份。
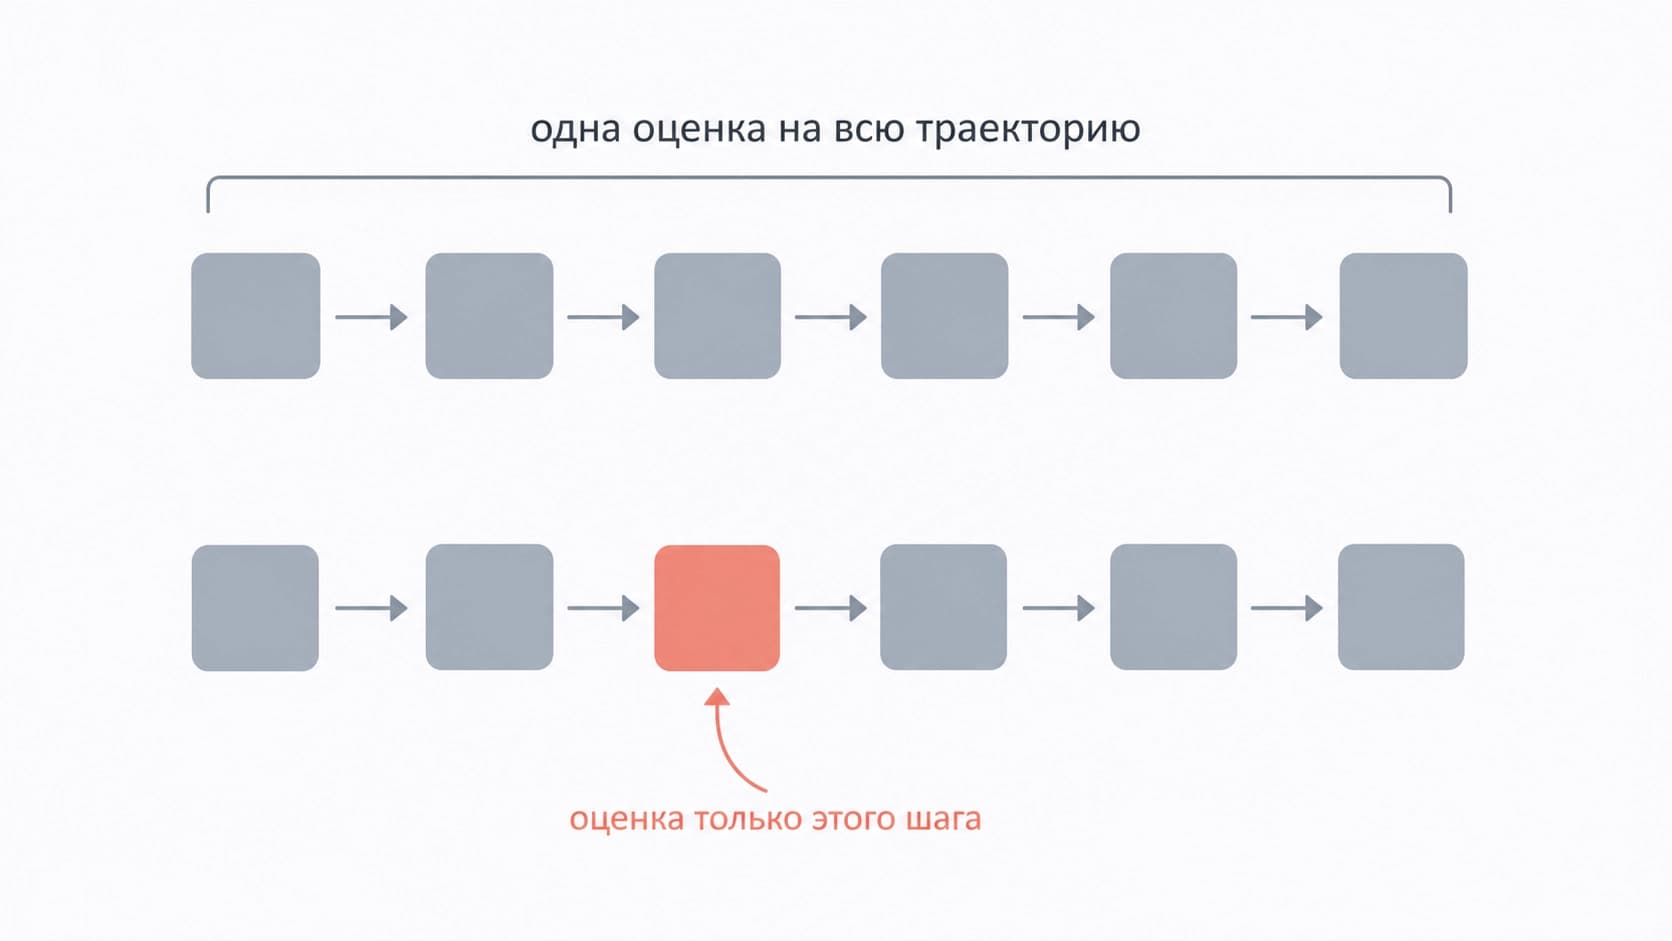
经典解法是带特权信息的自蒸馏。教师比学生知道得更多:它能访问环境、访问中间信号、访问正确答案。它可以在每一步给出提示,而不只是在最后。听起来不错,但这种做法有一个隐蔽的疏漏:同一条提示被不加区分地发给所有步骤。
步骤的不对称性:例行操作和错误需要不同的对待
AHEAD 这篇工作的核心观点是:轨迹中的各个步骤并不等价,对它们的监督也应当有所区别。
- 例行步骤——打开页面、确认跳转、调用相应工具——几乎不需要提示。模型本来就能应付。多余的指导只会给训练带来噪声,浪费预算。
- 带错误的关键步骤——也就是智能体走错方向、错失成功机会的地方——需要的不是简单地说一句“这里不行”,而是具体的指引:本来应该怎么做。
- 来自环境的反馈能很好地为所发生的事提供依据:它说明实际发生了什么。但它无法解释本该怎么做。“门没打开”这个信号并不会告诉你钥匙放在哪里。
于是,两个监督来源彼此互补,却无法相互替代。环境反馈在每一步都给出稠密而诚实的信号;由模型生成的纠正性提示则提供了环境反馈中根本不存在的东西——意图和替代方案。把它们不加分辨地混用于整条轨迹,就等于丢掉两者的长处。
AHEAD 是如何设计的
作者——Xiaolong Jin、Dingmin Wang、Vijay Lingam 和 Varun Kumar——提出了一个能够识别步骤类型、并据此选择监督来源的框架。该工作于 2026 年 8 月底发布在 arXiv 上,分类为 cs.AI;篇幅为 22 页、15 张图和 7 张表,也就是说细节材料相当充足。
一个能看见环境的教师
教师模型在所有步骤上都获得环境反馈——这是一个有依据且稠密的信号,在成功和失败的区段都同样可用。这样的教师不会凭空臆想:它依据的是环境中真实发生的事。
纠正性提示——精准投放
在此基础上,教师会获得由 LLM 生成的提示,但不是在所有步骤上,而恰恰是在出错的步骤上。逻辑很简单:在智能体出错的地方,仅有环境中的事实是不够的,需要解释本该往哪个方向走。而在一切顺利的地方,则完全不添加额外的指导。
这正是标题中所说的“精准提示”:不是平摊到整条轨迹上,而是聚焦于问题点。用步骤感知的监督来源匹配,取代针对整条动作链的单一信号。
对 GRPO 的最小改动
尤其值得一提的是这个方法在工程上的克制。GRPO——一种流行的强化学习算法——并没有被从零重写:改动是精准施加在标准方案之上的。对实践者来说这很重要,因为无需重建整个智能体训练流程。
实验展示了什么
评估在三种任务类型上进行:ALFWorld——文本环境中的多步场景,WebShop——与网店的交互,以及检索式问答。测试了三种规模的模型,因此结论并不局限于某一种规模。
与普通 GRPO 相比的结果:
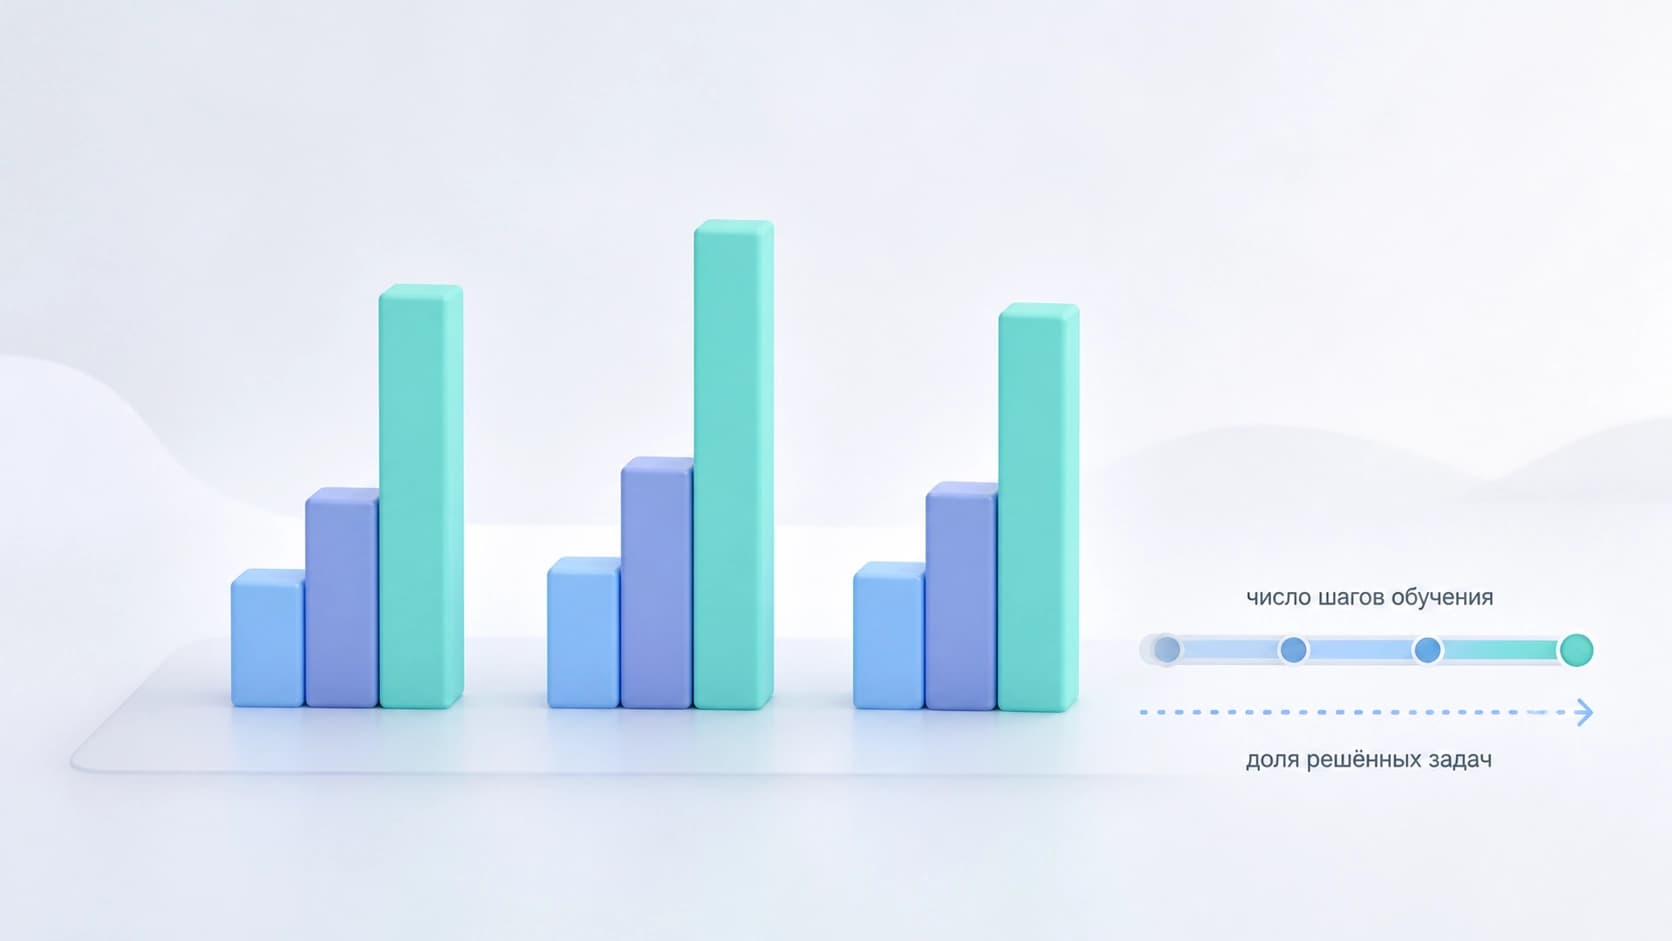
- 在 7B 模型上,ALFWorld 的成功率提升 13.3 个百分点;
- 在相同规模下,WebShop 提升 11.0 个百分点。
除了绝对数字之外,还有两个同样有趣的效果。第一,达到既定成功率所需的训练步数更少——也就是说,该方法不仅在极限上更优,而且更快进入可用状态。第二,智能体在更窄的交互预算内完成任务,优于仅基于最终奖励的方法以及此前的自蒸馏方法。
在我看来,第二点被低估了。节省交互步数不仅仅是一个好看的指标。在真实场景中,每一次工具调用都意味着金钱、时间和风险。一个用五步而非十步达成目标的智能体,其价值不是高出 13%,而是成倍提升——在错误代价高昂的地方尤其如此。
为什么它有效,以及还有什么未被言明
对这个方法的解释几乎带有教育意味。好老师不会对学生的每一个动作都加以点评——当学生做得合理时他保持沉默,只在学生偏离正轨的地方介入。如果事无巨细地评论,学生就不再自己思考,转而等待提示。如果什么都不评论,他就会反复犯同样的错误。
AHEAD 把这种直觉形式化为强化学习的术语:不同的步骤类型——不同的信号来源。稠密且有依据的反馈——作为背景,纠正性指引——作为强调。没有任何魔法,只是放弃了“所有步骤都平等”这一想法。
仍存疑问之处。生成纠正性提示本身就需要模型,这意味着额外的计算开销,并且依赖于它的质量——如果教师解释错了,学生就会得到一个自信却错误的方向。另一个悬而未决的问题是,该方法在那些中间步骤代价不像 ALFWorld 或 WebShop 中那样明显、且步骤的“错误性”并不总能立即判定、而只能通过延迟后果来判定的任务上,迁移效果如何。
尽管如此,这个方向看起来是健康的。近年来智能体方法发展的主线不是把模型做大,而是更聪明地利用训练信号。AHEAD 正属于这条主线:以精准介入取代全面控制。


