
太容易轻信的裁判
多模态模型正越来越多地充当仲裁者:它们查看图片、视频或聆听音频,然后做出裁决——结果是否符合文本请求。这类“来者不拒”的裁判既被用于评估生成系统,也被用于自动标注数据,毕竟真人专家不够用。
逻辑很清晰:如果模型能同时理解多种模态,为什么不把 text-to-image、text-to-video 和 text-to-speech 的检查交给它呢?但这里藏着一个令人不安的问题。这类裁判良好的最终准确率,并不意味着它真的看到了自己所评估的内容。现有的测试集和训练样本通常偏向于成功案例,而不同类型的失败则被混作一团。
结果就是一幅失真的图景。裁判给出不错的数字,因为它学会了说“是”,而它真正的盲区却无人察觉。这正是 arXiv 上一篇新论文所剖析的问题。
作者提出了什么:D3-Omni
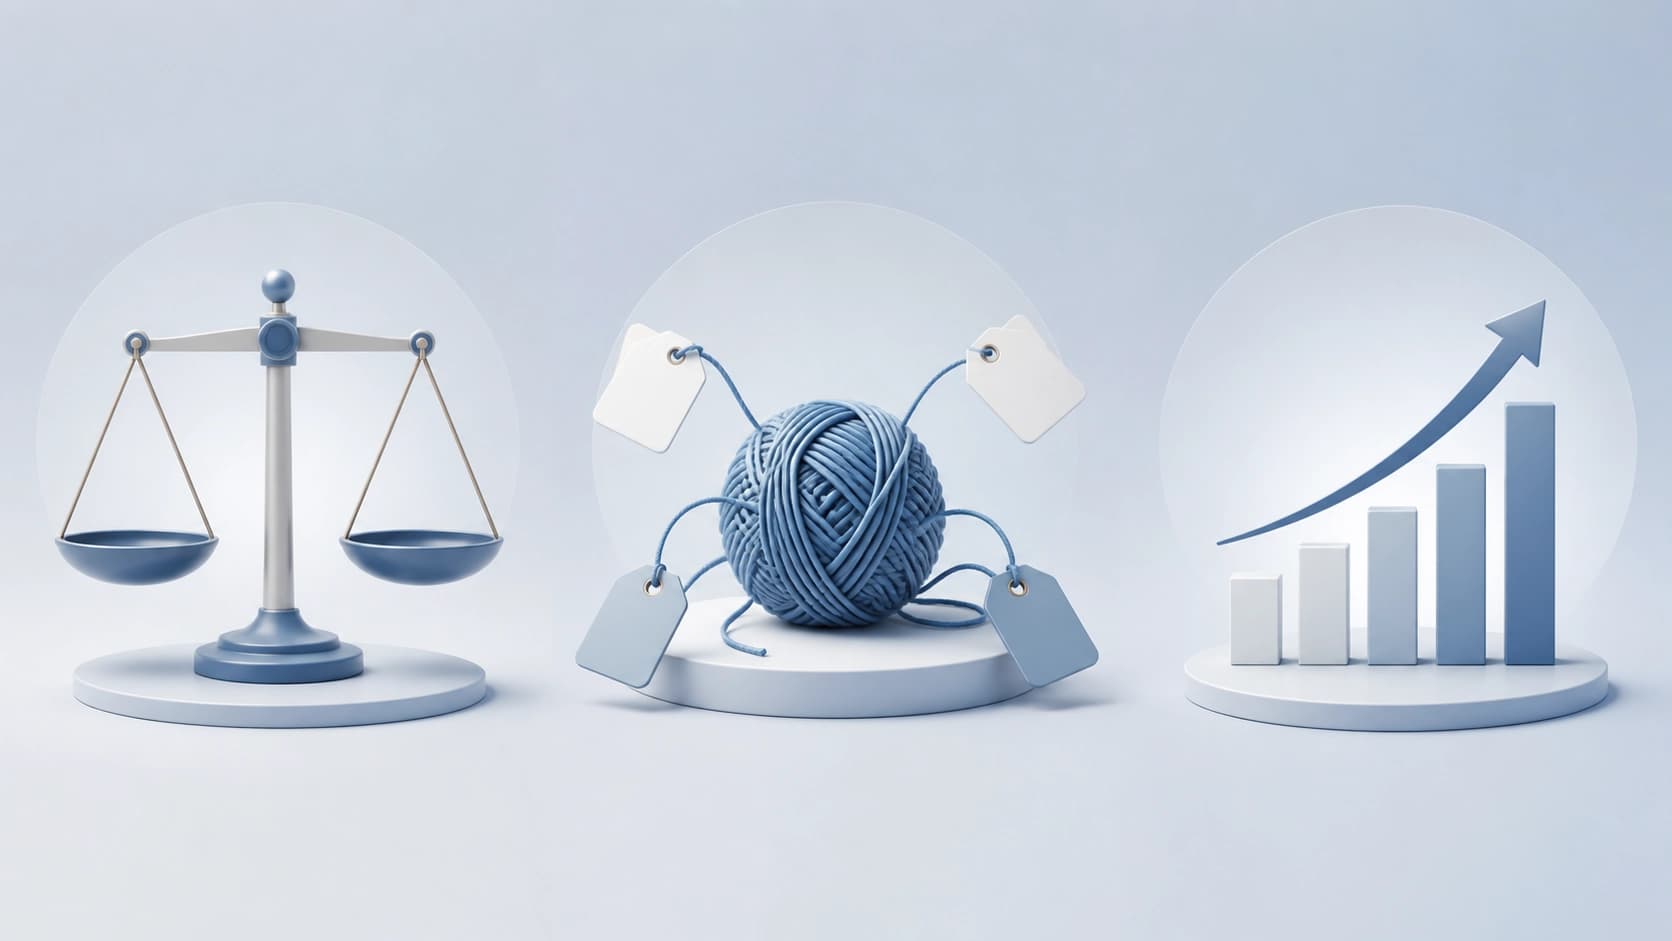
这项研究发表时用了一个作者自己构建的、基于反差的标题:“OmniJudge or OmniBias?”。他们没有再做一份排行榜,而是打造了一个诊断工具——D3-Omni,一个旨在不让裁判躲在总体统计数字背后的基准测试。这个名字由三条原则展开,每一条都针对惯常测试的某个具体弱点。
Dual-balanced:消除偏向“一切都好”的失衡
第一条原则负责平衡。与其随意收集样本,不如让数据集保持均衡:对于每一项被检验的特征,成功和失败的案例数量应当相当。这样就不会出现模型仅仅因为正确答案更常是“是”而得分的情况。
Decoupled:一个错误——一个原因
第二条原则是解耦。测试中的每个缺陷都恰好对应一种能力。如果裁判出错了,就能清楚知道它缺的究竟是什么:是对构图、颜色、音频同步还是别的什么的理解。没有那种搞不清三个违规中哪一个绊倒了模型的复合样本。
Dynamic:测试随生成器的进步而调整
第三条原则是动态。随着生成模型掌握新领域,测试的构造会被引导到样本表征尚不充分的地方。目标是让每项特征大致保持一比一的均衡,并让最终得分的各个层级都均匀填充。
数据集是如何构建的
D3-Omni 的规模相当可观:53 项二元特征,分布在三个任务上(分别为 17、22 和 14 项),共 10 671 个样本(分别为 3 526、1 998 和 5 147 个)。这些特征是按正交方式挑选的——它们彼此不重复。
一个单独的工程细节是如何获取负样本。作者坚决放弃了重新生成输出的做法:这条路会导致特征之间的信息泄漏,测试也就不再纯粹。取而代之的是,他们取用经过验证的完全正面的“种子”,然后以可控方式引入违规——改写提示词并加入针对性的扰动,从而隔离出单一特征。
发现了什么:裁判信心十足地夸奖,却拙于捕捉瑕疵
这项工作中最有趣的不是基准测试的构造,而是它揭示出的东西。即便是强大的多模态裁判,也会在与模态直接相关的特征上栽跟头。简而言之,它们恰恰难以胜任的,正是它们被请来当评估者的原因。
第二个观察更令人不快。模型确认已满足要求的能力,明显比发现被违反的要求更可靠。这种不对称是稳定的:对裁判来说,说“这里一切都符合请求”要比抓住某个具体的不符之处容易得多。
第三,名义上不同的属性,模型倾向于把它们当作一个整体判断来感知。属性之间的差异被抹平,裁判给出的是笼统的裁决,而非逐条分析。
为什么聚合百分比会骗人
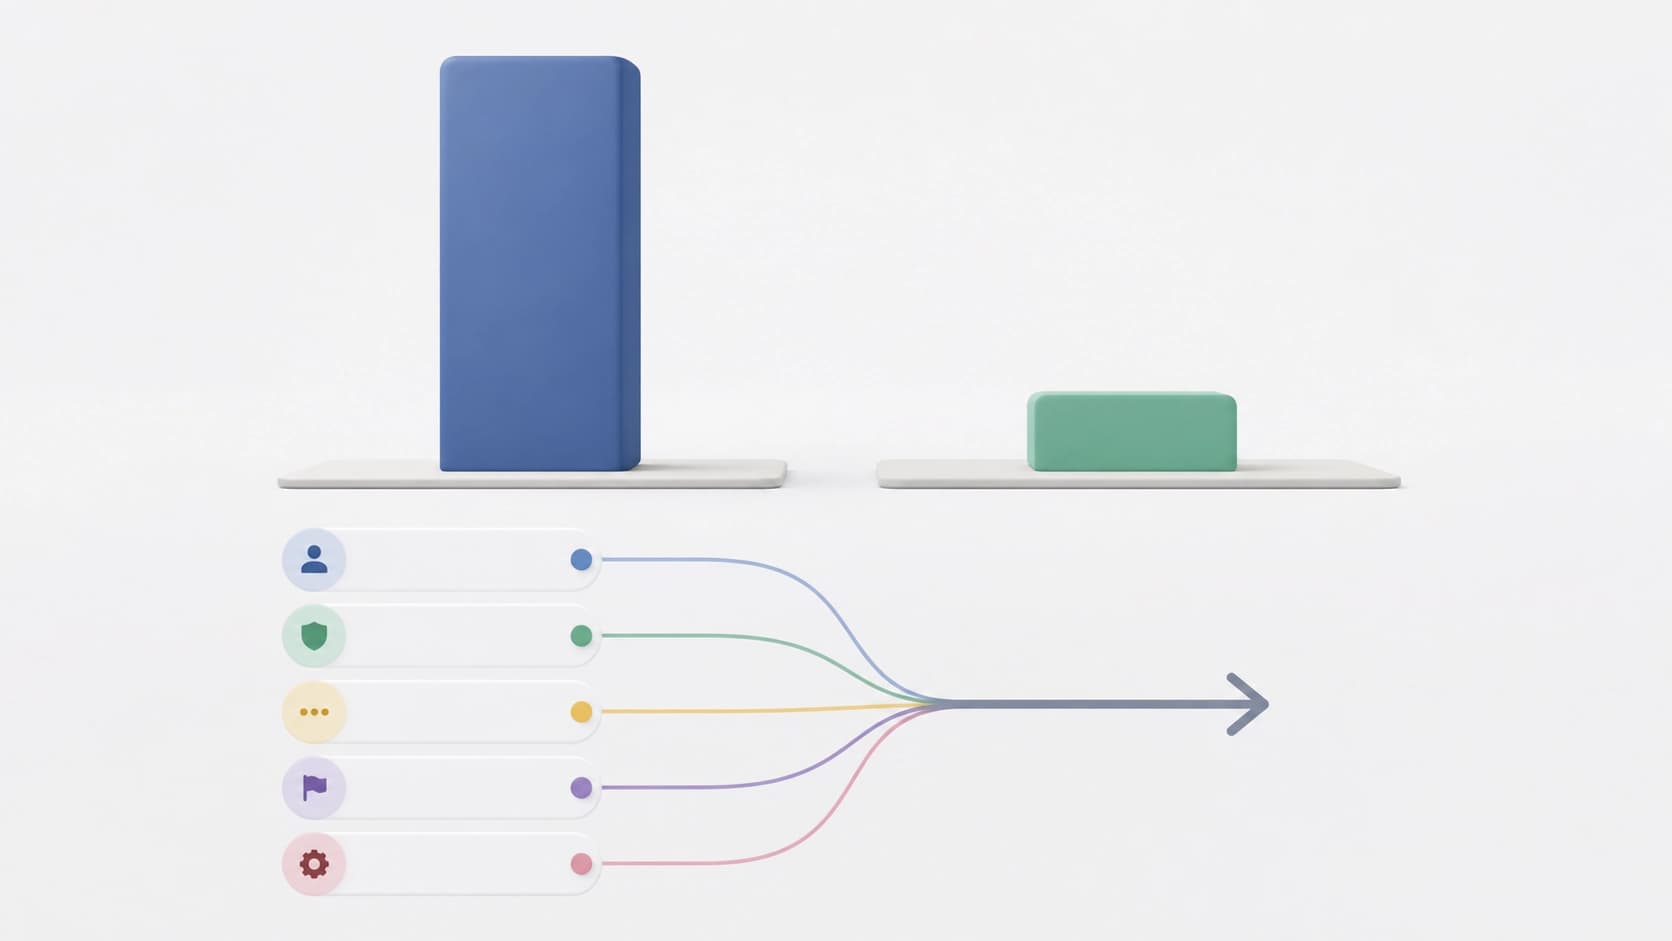
从这些观察中得出主要结论:最终准确率可能掩盖系统性的盲区。一个稳定猜中“正面”答案的裁判,在失衡的数据集上会显得不错——而在需要抓住生成器错误的地方则会失败。
平衡且解耦的视角不是为了指标好看,而是为了让这些盲区变得可见。而一旦看见——就可以有针对性地去弥补:在问题特征上做微调,而不是一味追求平均分。
对实践而言,这意味着很简单的一件事。如果你在搭建一条由模型裁判来过滤生成结果或标注数据集的流水线,那么应当在偏向负样本的数据集上检验它,而不是在由成功案例构成的顺手样本上。否则评估者会放过瑕疵,而你会从用户那里、而不是从指标那里得知这一点。
简要总结
- D3-Omni 是用于诊断多模态裁判的基准测试,而非模型排行榜。
- 三条原则:正负样本的平衡、每个错误对应一种能力、测试随生成器的发展而调整。
- 53 项特征和近 1.1 万个样本,覆盖 text-to-image、text-to-video 和 text-to-speech 任务。
- 负样本通过改写提示词和针对性扰动来创建,而非重新生成——以免混淆特征。
- 主要结论:高平均分可能掩盖稳定的盲区,尤其是在需要察觉违规而非确认符合的地方。


